
 语音小管家
“把闹钟设置为早上7:15”
- “好的,呼叫Selma Martin`”
“不对,将闹钟设置为上午7:15”
- “对不起,我无法帮助你。”
我们的声音多种多样,复杂多变,语音命令甚至更难以处理。不仅在人与人之间,人与计算机之间的交互也是。我们构思思维的方式,文化交流的方式,我们使用俚语的方式......所有这些细微差别都会影响我们语言的理解。
那么,交互设计师应如何应对这一挑战呢?我们又该如何培养用户和AI之间的信任?
这就是语音用户界面(VUI)发挥作用的地方。
VUI是视觉,听觉和触觉界面之间的组合,它将人与设备之间的语音交互变为可能。VUI可以是任何东西,从听到你的声音时闪烁的灯光到汽车的娱乐控制台。VUI不需要具有可视界面-它可以是完全听觉的或触觉的。虽然VUI种类繁多,但它们仍将遵循一套常用的UX基础知识。在这篇文章里,我们将探索这些知识,来帮助交互设计师在设计VUI时构建更好的体验。
我们与世界互动的方式受到我们的技术,环境和社会约束的极大影响。我们处理信息的速度,我们将数据转化为行动的准确性,我们用来传达数据的语言,以及该行动的接收者,都影响着我们与这世界的交互方式。因此,在我们深入研究语音交互设计之前,我们必须首先确定构成语音交互的环境背景。
确定设备类型
设备类型对语音交互的频谱和范围的模式和输入有很大影响。
这些设备和环境包括:
手机
iPhones, Pixels,Galaxies
连接-蜂窝网络,wifi,配对设备
环境背景对语音交互性有重大影响
用户习惯于使用语音交互
允许通过视觉,听觉和触觉反馈进行互动
交互方法在各种模型中相当标准化
可穿戴
如手表,健身带或智能鞋
连接-蜂窝网络,wifi,配对设备
用户可能习惯于使用语音交互,但这种交互在设备之间是非标准化的
一些可穿戴设备允许通过视觉,听觉和触觉反馈进行交互
通常依赖于连接的设备进行用户交互和数据消费
固定连接设备
台式电脑,带屏幕的电器,恒温器,智能家居集线器,音响系统,电视
连接-有线网络,wifi,配对设备
用户习惯于在相同的位置使用这些设备并在习惯的基础上进行设置
类似设备类型之间的准标准化语音交互方法(台式计算机与诸如Google Home / Amazon Alexa与智能恒温器之类的连接集线器)。
非固定计算设备
笔记本电脑,平板电脑,转发器,汽车信息娱乐系统
连接-无线网络,有线网络(不常见),wifi,配对设备
主输入模式通常不是语音
环境背景对语音交互性有重大影响
通常在设备类型之间具有非标准化的语音交互方法
语音交互的主要,次要和第三使用案例是什么?该设备是否有一个主要用例(如健身追踪器)?或者是否有不拘一格的用例组合(如智能手机)?
创建一个用例矩阵非常重要,它将帮助您了解用户与设备交互的原因。他们的主要互动模式是什么?什么是次要的?什么是好的交互模式,什么是必不可少的?
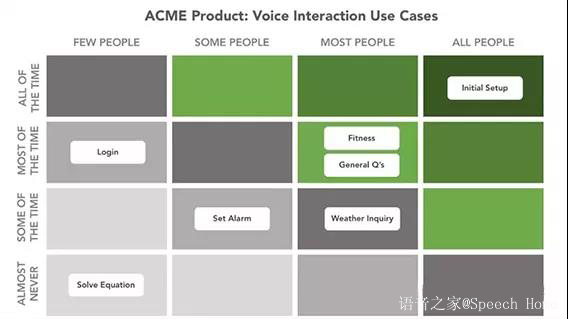
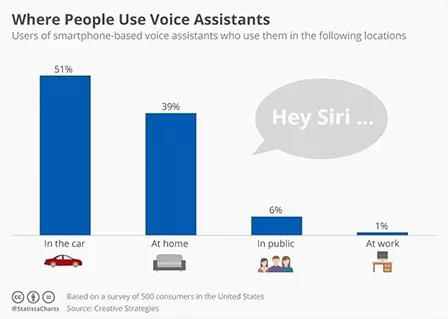
您可以为每种交互模式创建用例矩阵。应用于语音交互时,矩阵将帮助您了解用户当前使用或想要使用语音与产品交互的方式-包括他们使用语音助手的场景:
按顺序排列交互模式
如果您正在使用用户研究来验证您的使用案例(使用原始定量/定性研究),那么交互模式的排序非常重要。
如果有人告诉你:“如果我能与电视对话并告诉它改变频道,那一定会很酷!”那么,在这种情况下,你需要深入挖掘用户的心声:他们真的会用这个功能吗?他们了解功能相关的限制吗?他们真的了解自己使用该功能的倾向吗?
假设我们正在检查用户是否可能使用语音命令与他们的电视进行交互。在这种情况下,我们可以发现语音交互是许多可能的交互类型之一:用户可以使用多个备选交互方式,包括远程,配对智能手机,游戏控制器或连接的物联网设备。因此,语音不一定成为默认的交互模式,它只是用户众多选择之一。
将我们的言论转化为行动是一项极其困难的技术挑战。通过无限的时间,连接和训练,计算引擎可以方便地摄取我们的语音并触发适当的操作。
不幸的是,我们生活在一个网络连接有限的世界(千兆互联网并不是无处不在的),我们也没有无限的时间可以浪费。我们希望我们的语音交互与传统的替代方案一样便捷与迅速,和曾经的视觉和触摸交互一样,尽管语音引擎需要复杂的处理和预测建模。
以下是一些示例流程,演示了我们的语音被计算机识别的过程:
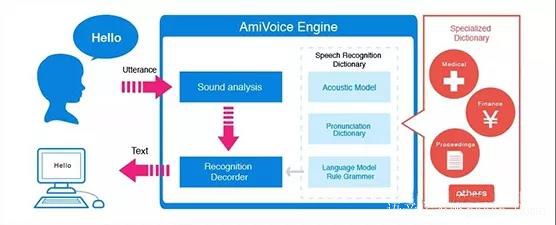
正如我们所看到的......有许多模型需要不断训练才能使用我们的词典,重音,可变音调等。
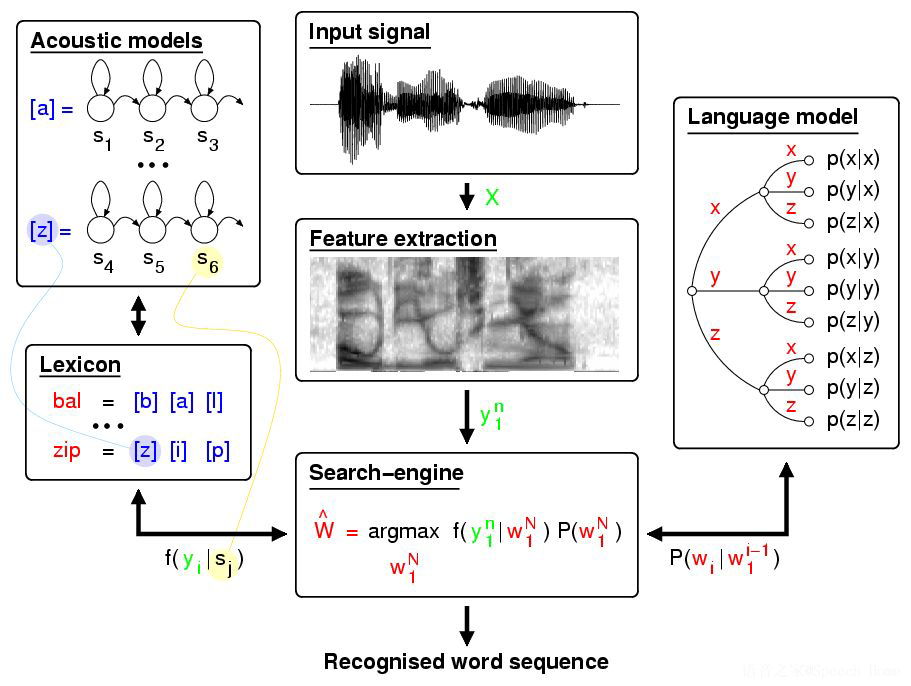
每个语音识别平台都有一套独特的技术限制。在构建语音交互时,UX设计师必须学会接受这些限制。
尝试分析以下类别:
连接级别-设备是否始终连接到互联网?
处理速度-用户是否需要实时处理他们的语音?
加工精度–如何处理准确度和速度之间的平衡?
语音模型-我们目前的模型训练有多好?它们能够准确地处理完整的句子还是简短的单词?
备选计划-如果言语无法被识别,那么技术备选计划是什么?用户可以利用另一种交互模式吗?
不准确的后果-错误处理的命令会导致不可逆转的行为吗?我们的语音识别引擎是否足够成熟来避免严重错误的发生?
环境测试-语音引擎是否已在多种环境环境中进行过测试?例如,如果我正在构建汽车信息娱乐系统,那么我会预期该语音识别系统会比智能恒温器受到更多的环境干扰。
非线性
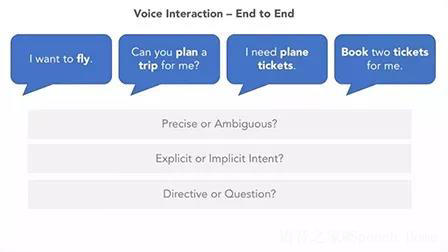
此外,我们还应该考虑用户可以以非线性方式与设备交互。例如,如果我想在网站上预订机票,那么我将被迫完成网站引导我们完成的步骤并提供所有信息:选择目的地,选择日期,选择门票数量,查看选项等...
但是,VUI面临着更大的挑战。用户可以说“我们想在商务舱飞往旧金山。”此时,VUI必须从用户那里提取所有相关信息,以便利用现有的航班预订API。在用户提供的信息不完整或在不常规的语言逻辑顺序情况下,VUI需要使用别的手段从用户身上提取更多的相关信息(通过语音或视觉补充)。
语音输入UX
现在我们已经探索了有关VUI的约束,依赖关系和用例,我们可以开始深入研究实际的语音UX。首先,我们将探讨设备如何知道需要在何时聆听我们的需求。
下图说明了基本的语音UX流程:
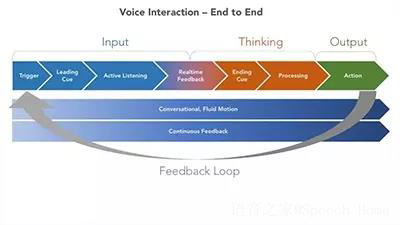
有四种类型的语音连接触发器:
语音触发-用户会说出一个短语,提示设备开始处理语音(例如“Ok Google”)
触觉触发-按下按钮(物理或数字)或切换控件(例如麦克风图标)
动作触发器-在传感器前挥动手
设备自触发-事件或预先确定的设置将触发设备
作为设计师,您必须了解哪些触发器与您的用例相关
提示
通常,当用户触发设备时,设备将会提供听觉,视觉或触觉提示。
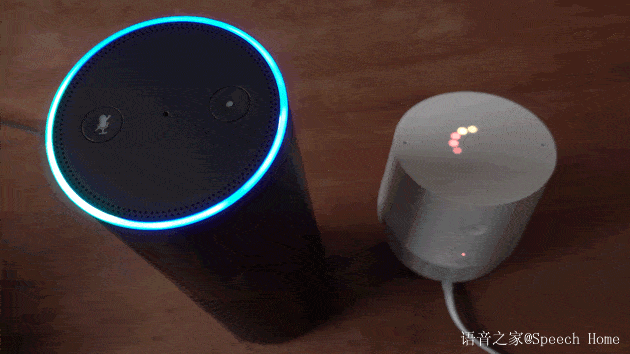
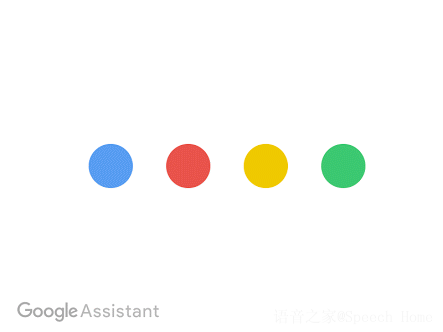
这些提示应遵循以下可用性原则:
快速性-在适当的触发后,提示音尽快提示。
简短-提示应该几乎是瞬间的,特别是对于习惯使用的设备。例如,两个肯定的哔哔声比“Ok Justin”更有效,你现在要我做什么?
清晰的开始提示-用户应确切知道何时开始录制他们的声音。
一致性-提示应始终相同,声音或视觉反馈的差异会使用户感到困惑。
区别-提示应该与设备的正常声音和视觉效果不同-并且不应在任何其他环境中使用或重复。
补充提示-如果可能,利用多种交互式媒介来表现提示(例如,两次哔哔声,一次灯光变化和一次屏幕对话)。
初始提示-对于初次使用的用户,或者当用户似乎卡住时,您可以显示初始提示或建议以促进语音通信。
反馈系统对于成功的语音界面UX至关重要。它允许用户立即确认他们的声音被设备接收和处理。
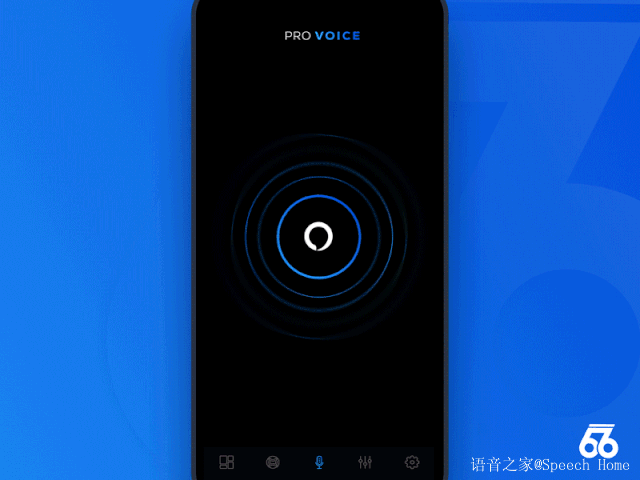
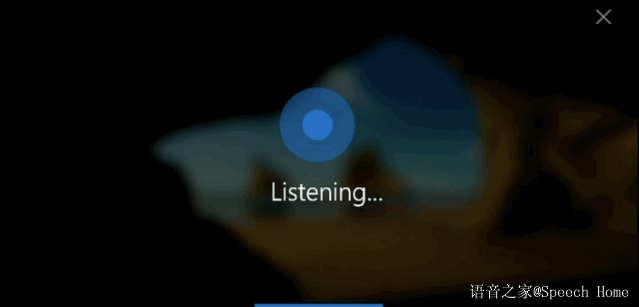
以下是一些有助于提供有效VUI反馈的UX原则:
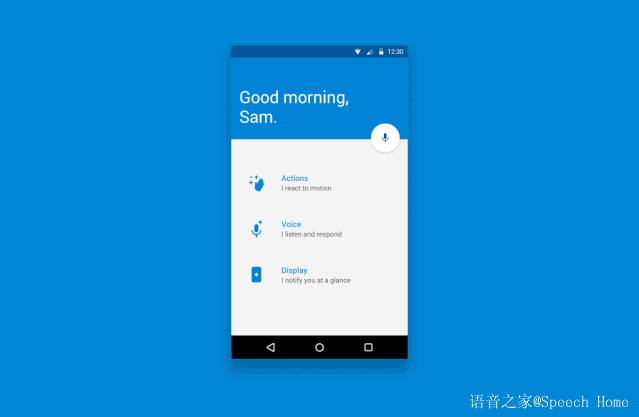
实时响应式视觉效果 - 这种视觉反馈在本机语音设备(例如手机)中最常见。它可以在多个声音维度上创建即时的认知反馈:音高,音色,强度和持续时间 - 这些都可以响应性地实时改变颜色和模式。
音频播放-简单的播放,以确认语音的解释
实时文本-文本反馈将在用户说话时逐步显示
输出文本-在用户完成发言后转换和修改的文本反馈。在将音频确认或转换为动作之前,将其视为第一层纠正处理。
非屏幕视觉提示(灯光,灯光模式)-上面提到的响应式视觉效果不仅限于数字屏幕。这些响应模式也可以表现为简单的LED灯或灯光模式。
结束提示
该提示意味着当设备停止接收用户的声音并开始处理命令。许多相同的“主要提示”原则适用于最终提示(即时,简短,清晰,一致和不同)。但是,还有一些其他原则也适用于这种情况:
足够的时间-确保用户有足够的时间完成命令。
可调节的时间-分配的时间应适应用例和预期响应。例如,如果用户被问到“是”或“否”问题,则结尾提示应该在一个音节之后期望合理的暂停。
合理的暂停-自上次录制声音以来经过了合理的时间吗?这非常难以计算,但在上下文中也依赖于交互的用例,
像“打开我的闹钟”这样的简单命令不一定需要冗长的对话,但更复杂的命令可以。与传统的人与人之间的互动不同,人与AI之间的互动往往需要额外的确认和纠正来避免错误发生。
更复杂的命令或迭代对话通常需要多层语音/选项的验证以确保准确性。使问题更加复杂,通常用户不确定要询问什么或如何要求它。因此,解密消息并允许用户提供其他上下文成为VUI的工作。
肯定性-当AI确实理解语音时,它应该回复肯定的消息,该消息也确认了语音。例如,人工智能不是说“当然”,而是说“当然,我会把灯关掉”-或者“你确定要我关灯吗?”
纠正-当AI无法破译用户的意图时,它应该使用纠正选项进行响应。这允许用户选择另一个选项或完全重新开始对话。
移情–当AI无法满足用户的请求时,它应该因缺乏理解而获得所有权–然后为用户提供纠正措施。移情对于建立更加个性化的关系非常重要。
将语音交互赋予人类特征会在人与设备之间建立关系。这种拟人化可以以各种方式表现出来:灯光模式,抽象图案,计算机生成的声音和声音。
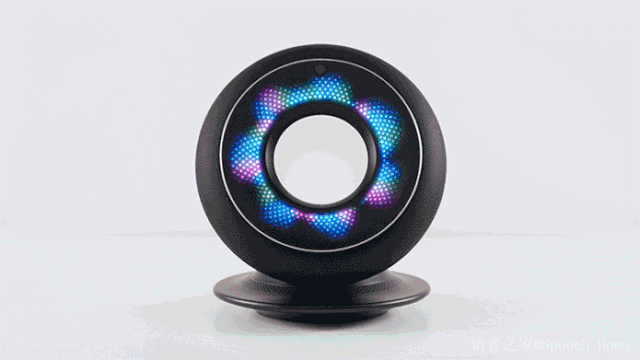
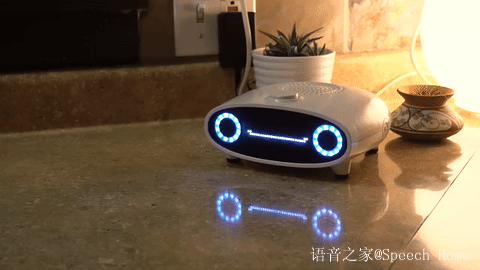
这种关系在用户和机器之间建立了更紧密的联系,这也包括一些跨平台的产品,例如Google assistant,亚马逊的Alexa和Apple的Siri。
它们往往包含以下特点:
个性-为交互带来另一个维度,允许虚拟个性与用户建立起同理心。它有助于减轻错误处理的语音的负面影响。
积极性-一般积极性鼓励重复性的互动。
信心和信任-鼓励额外的互动和复杂的对话,因为用户将对结果更有信心,同时有助于培养用户与产品之间的信任。
语音交互应该是动态变化的。当我们亲自交谈时,我们通常使用无数的面部表情,语气,肢体语言和运动的变化来传递讯息。对于语音交互,在数字化环境中抓取这种长时间的交互行为成为一大挑战。
如果可能,整个语音交互体验应该感觉像是一种有益的互动。短暂的互动如命令“关灯”,并不一定需要长时间的对话和交互。然而,任何其他类别的互动,如与数字助理一起烹饪,确实需要长时间的对话与交互。
有效的语音运动体验将受益于以下原则:
转换-无缝处理不同状态之间的转换。用户应该感觉他们永远不会等待,而是助手正在为他们工作。
鲜艳生动的色彩传达了喜悦和未来主义。它为互动增添了未来主义优雅元素-鼓励重复互动。
响应-响应用户输入和手势。给出关于正在处理哪些单词的提示,并允许用户查看他们的语音/意图是否被准确地解析。
VUI非常复杂,并且通常是多种交互的混合。事实上,现在并没有真正包含所有VUI内容的定义。在日益数字化的世界背景下,VUI的交互也在随着技术不断发展。它最终会成为我们与世界互动的主要手段吗?我们拭目以待。
