
 语音小管家
本文转载AINLP。这里有一些文本数据集,有兴趣的同学可以看看。
搜索所有中文数据集,附常见英文数据集
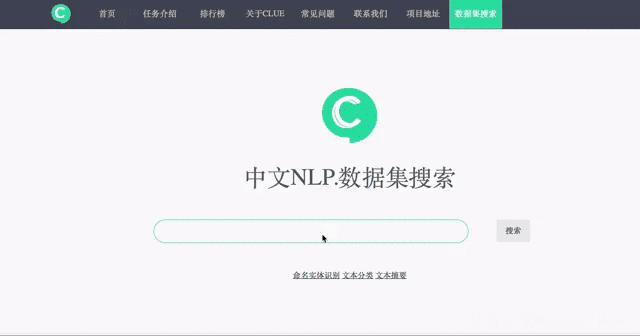
搜索入口:https://www.CLUEbenchmark.com/dataSet_search.html
项目地址,点击文末阅读原文直达:https://github.com/CLUEbenchmark/CLUEDatasetSearch
CLUEDatasetSearch是什么
鉴于我们在国内很难找到一个具体的地方可以搜索到NLP的相关数据集,所以CLUE组织创 立了本项目。本项目中搜集了网络中现有的比较流行的数据集。按照任务分成了以下十个方面:
类型 | NER | QA | 情感分析 | 文本分类 | 文本匹配 | 文本摘要 | 机器翻译 | 知识图谱 | 语料库 | 阅读理解 |
数量 | 9 | 9 | 11 | 19 | 17 | 24 | 16 | 1 | 14 | 22 |
每个类别包括以下信息,以帮助读者快速找到自己想要的数据集,并最大程度保护数据提供者的版权。
标题 | 更新日期 | 数据集提供者 | 许可 | 说明 | 关键字 | 类别 | 论文地址 | 备注 |
同时我们提供了搜索功能,大家可以方便的进行查询。
为什么做数据集搜索
首先中国存在大量的NLP相关从业者,很多人在工作、学习或者做研究的时候面临的一个 大问题就是很难一下子找到自己想要的数据集,而有一些数据集散落在网络各个角度,但却没有一个合适的地方可以帮助大家快速找到,无形中增加了NLP的研究难度。尽管存在一些外文网址提供了部分数据,但是其大多仅围绕英文,并且对于我们在访问检索的时候依然存在困难。
所以,如果在国内有一个网址,能够提供导航到大众能广泛使用和测评的数据集,并且可以提供简单的介绍,就可以帮助大家进行相关工作,也能促进中文自然语言处理紧跟当前世界技术的发展,并促进相关应用的发展。
使用方法:
1.进入 github 项目地址进行浏览,寻找自己想要的数据集。
2.我们也提供了搜索功能,可以直接通过搜索想要的数据种类。
特点
本数据集覆盖到了十种NLP任务,其中包括了经典的NER、文本分类等任务,也涉及了近两年火起来的阅读理解等相关任务,覆盖范围广。
同时为了大家使用方便,还提供了搜索界面,可以让大家方便快速的进行检索。
未来工作
1.我们会针对不同的项目或者比赛提供基础的baseline模型,或者提供平台让过往的参赛者将他们的解决方案链接添加到此处。
2.我们会根据现有的数据集,进行归纳整理。
3.我们会定期更新数据集,如果有新的比较好的比赛数据等,我们会将其聚合在这里。
贡献与参与
感谢以下同学的贡献(排名不分先后)
郑少棉、李明磊、Lee、叶琛、薛司悦、章锦川、李小昌、Duke
您可以通过【上传数据集】功能,上传数据集信息来贡献你的力量。上传五个或以上数据集信息并审核通过后,该同学可以作为项目贡献者,并呈现在我们的github主页上;你也可以将你搜索到的中文数据集信息通过邮件以表格的形式发送给我们CLUEbenchmark@163.com
如果有一些数据集我们没有提供,可以通过在github项目中创建issue的方式提出自己的需求,同时更加欢迎大家将自己能够找到的数据集添加到我们的项目中。
