语音小管家
文章来源于PaperWeekly,作者黄融杰
扩散模型在深度生成模型中自成一派,最近成为最热门的话题之一。扩散模型展示了强大的生成能力,无论是生成高水平的细节还是其生成的多样性,都让人印象深刻。
扩散生成模型将生成式建模领域的标准提高到了一个全新的水平。迄今为止,扩散模型已被应用于各种生成式语音建模任务,如语音合成(speech synthesis)、语音转换(speech conversion)、语音编辑(speech editing)、语音转换(speech-to-speech translation)等等。
在今年的IJCAI 2022和ACM-MM 2022上,浙江大学的两篇论文提出了全新的语音合成条件扩散模型 FastDiff和ProDiff,能大幅减少 DDPM 每步降噪所需时间在解决其原来的速度瓶颈的同时,仍能生成出与人声难以分辨的高质量语音, 并挖掘其应用在语音合成上的潜力。FastDiff, ProDiff分别在声码器和语音合成上得到验证,揭示了扩散生成模型的包括去噪起点、生成算法、噪声采样的加速方法,克服了因模型加速带来的生成性能损失。
降噪扩散概率模型(Denoising Diffusion Probabilistic Model,DDPM)是近两年开始火热起来的一种非自回归生成模型,特点是能以较为简单的训练方式在许多基准图像生成任务中达到跟GAN差不多甚至是更佳的生成质量。
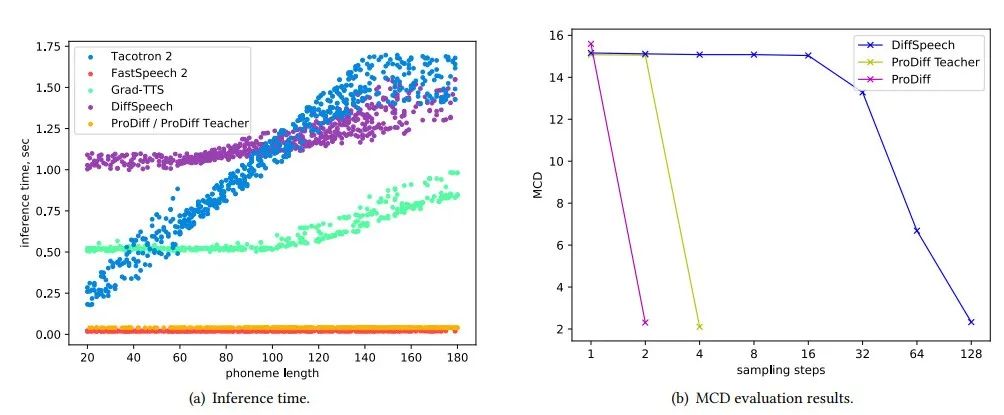
在听感测试中,业内一些基于DDPM的声码器的合成质量已能赶上自回归模型,但生成速度仍要远低于同为非自回归模型的Flow和GAN模型。这是由于DDPM在建模上需要通过迭代几百上千个采样步数来得到有效的降噪,如何快速得到高质量的合成样本仍然是难以解决的瓶颈。
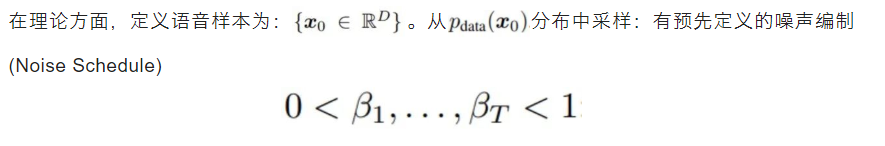
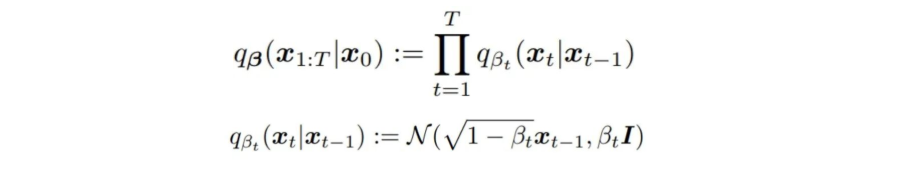
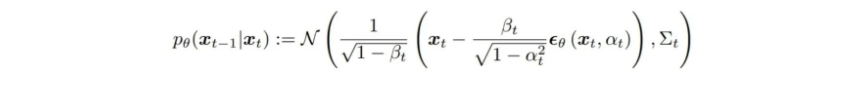
我们通过最大化证据下界(Evidence Lower Bound,ELBO),可以推导出简化的训练损失。这里,我们参考BDDM [1],有效的训练方法是用随机梯度下降优化:
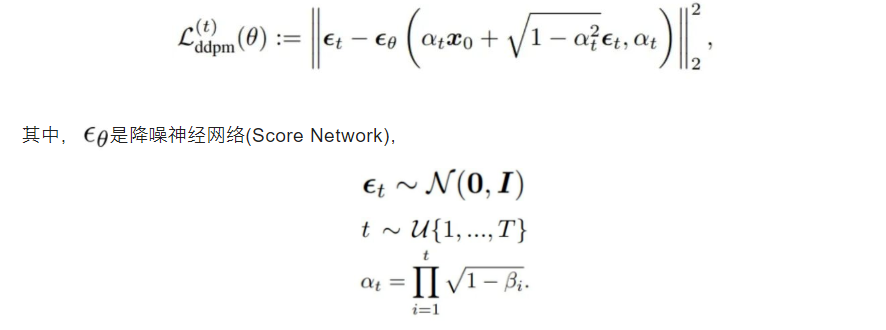
其中,仅有噪声编制与去噪步数 T 是需要预先定义的,其他变量都可以依次计算出。
论文链接:https://arxiv.org/abs/2204.09934
代码链接:https://github.com/Rongjiehuang/FastDiff
FastDiff的主要创新点来自于降噪模型结构方面:
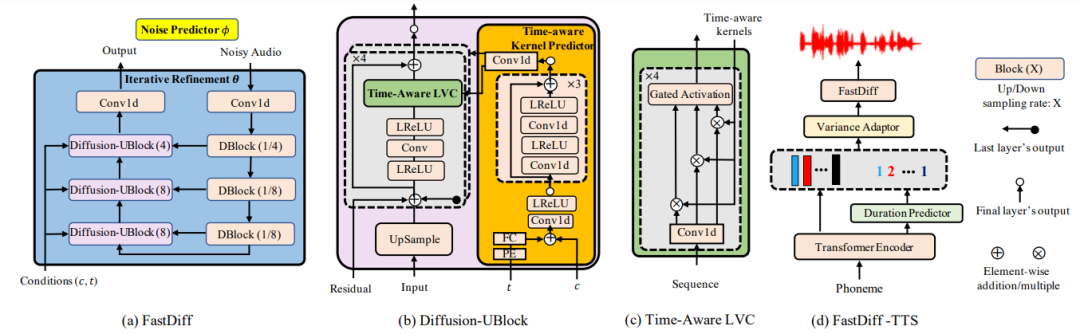
如图(a)所示,FastDiff模型主要由三层降采样块(DBlock)以及三层条件上采样块(Diffusion UBlock)构成。模型输入为带噪音频(Noisy Audio),噪声步数索引(表示为 t),梅尔频谱条件(Mel-spectrogram,表示为c)。DBlock等同于WaveGrad中的DBlock结构。而新设计的条件上采样块(Diffusion UBlock)如图(b)所示,先使用位置编码(Positional Encoding,PE)对 t 编码,然后经线性层后跟c相加,然后作为卷积核预测器(Kernel Predictor)的输入。预测的卷积核会在Time-Aware Location-Variable Convolutoin(LVC)中使用。以下是引入Time-Aware LVC的作用和原理解释。
为了有效的捕获条件的局部信息,FastDiff参考了LVCNet [2]设计Time-Aware LVC,如图(c)所示,位置变量卷积能对梅尔频谱和噪声步数编码条件进行高效建模,使之能对应于不同的噪声水平,均能够高质量地生成所预测的卷积核。能在保持模型尺寸的同时获得了更优的音质和速度。该模块输入包括下采样的带噪音频,以及预测的卷积核。在Time-Aware LVC中,Gated Activation Unit(GAU)门激活单元是为了提高本语音合成深度模型对于多说话人数据集的通用性,它在WaveNet中被证明能够有效地增加深度神器网络网络中的非线性。
总结FastDiff每步降噪的建模过程:卷积核预测器以噪声等级和梅尔频谱为条件,输出预测的卷积核。带噪音频通过三次下采样,经过LReLU激活与Conv1d一维卷积计算后,与先前获得的预测卷积核,一同参与计算Time-Aware LVC区域卷积。得到的音频通过GAU以增加非线性,与残差相加后送到下一层Diffusion UBlock的子层(共四层),最后模型输出预测还原的噪声向量。
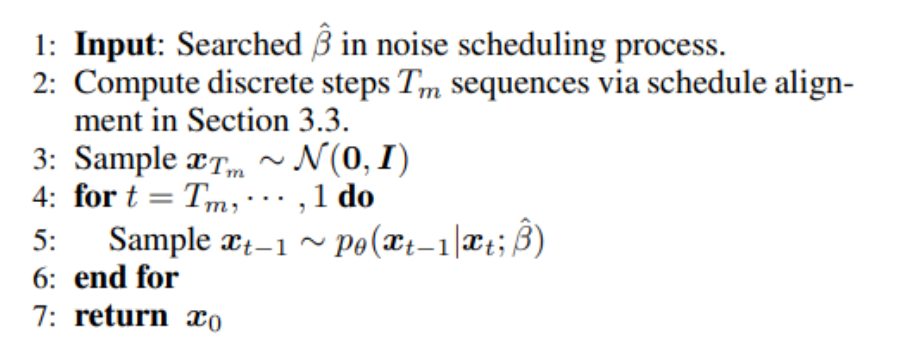
当降噪神经网络被充分训练之后,FastDiff利用BDDM算法训练Schedule network来得到步数更少的噪声编制。当得到搜索后的噪声编制,FastDiff能用以下的采样算法来进行高速的音频合成。
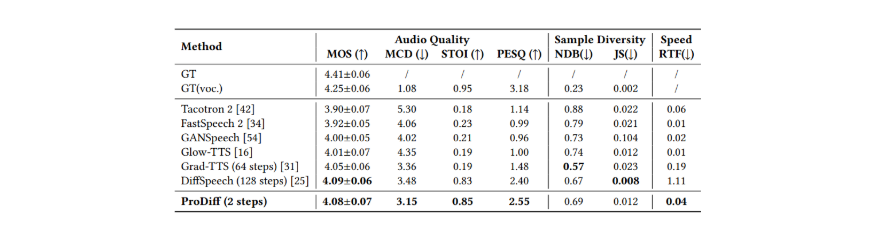
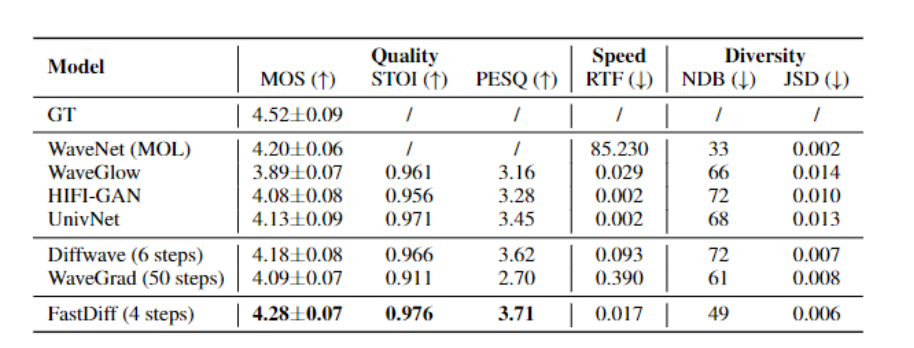
在LJSpeech数据的实验中,如下表所示,FastDiff能以4步降噪就能拿到相比前者最先进的声码器更优的主观及客观听感指标,同时FastDiff是首个在生成速度上能跟非DDPM类模型可比的(略比WaveGlow快)。在生成多样性上面,实验中较低的NDB和JSD也验证了FastDiff和其他DDPM类模型能比较避免模式坍塌问题。
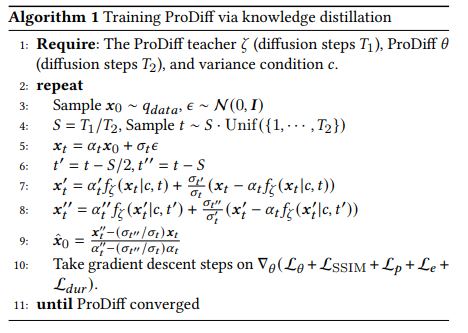
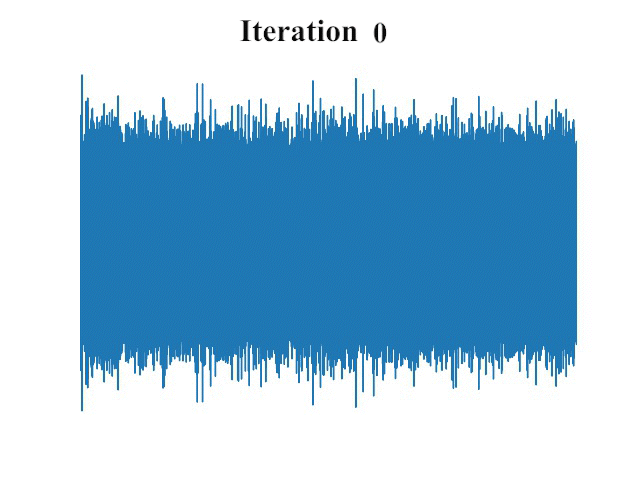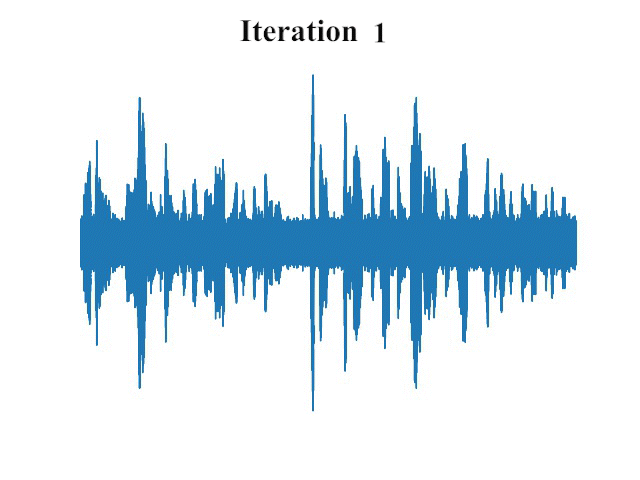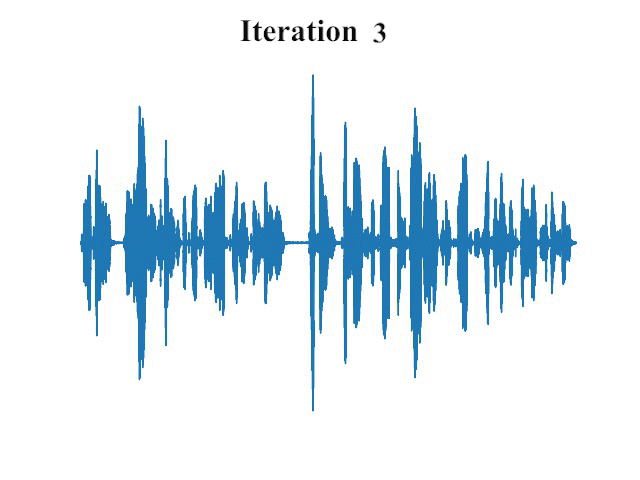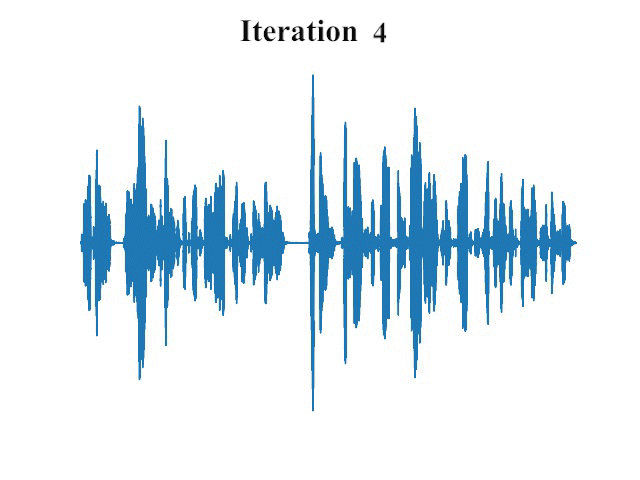 ProDiff: 快速蒸馏式文本语音合成模型
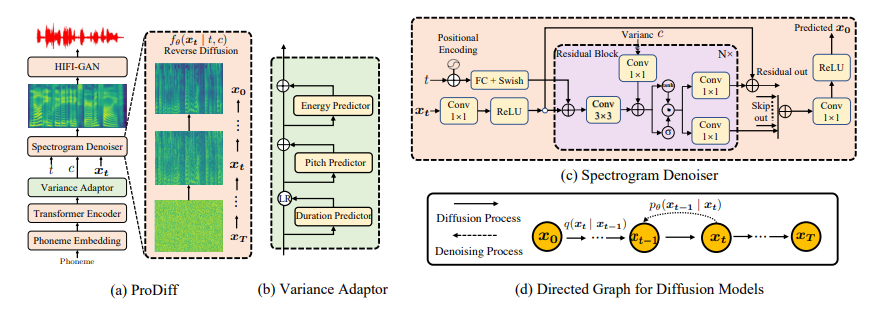
ProDiff的主要创新点来自于训练策略方面: