
 语音小管家
文章来源于PaperWeekly,作者范帅
本文主要介绍我们在自然语言处理领域被 EMNLP 2022 接收的工作,我们提出了SentiWSP,一种基于多层级的情感感知预训练模型,能够在多个情感分析下游任务上微调取得竞争性的性能。该模型通过巧妙的设计词级别和句子级别的预训练任务,使得模型可以更好地在两个层级捕捉到句子的情感信息。
©PaperWeekly 原创 · 作者 |范帅
单位 |厦门大学
研究方向 |自然语言处理
论文标题:
Sentiment-Aware Word and Sentence Level Pre-training for Sentiment Analysis
EMNLP 2022
https://arxiv.org/abs/2210.09803
https://github.com/XMUDM/SentiWSP
本文作者:
01 研究背景
如何从词级别学习词语中更丰富的情感信息 如何从句子级别构造更加有效的预训练任务提升模型对于文本的整体情感信息的捕捉
02 方法
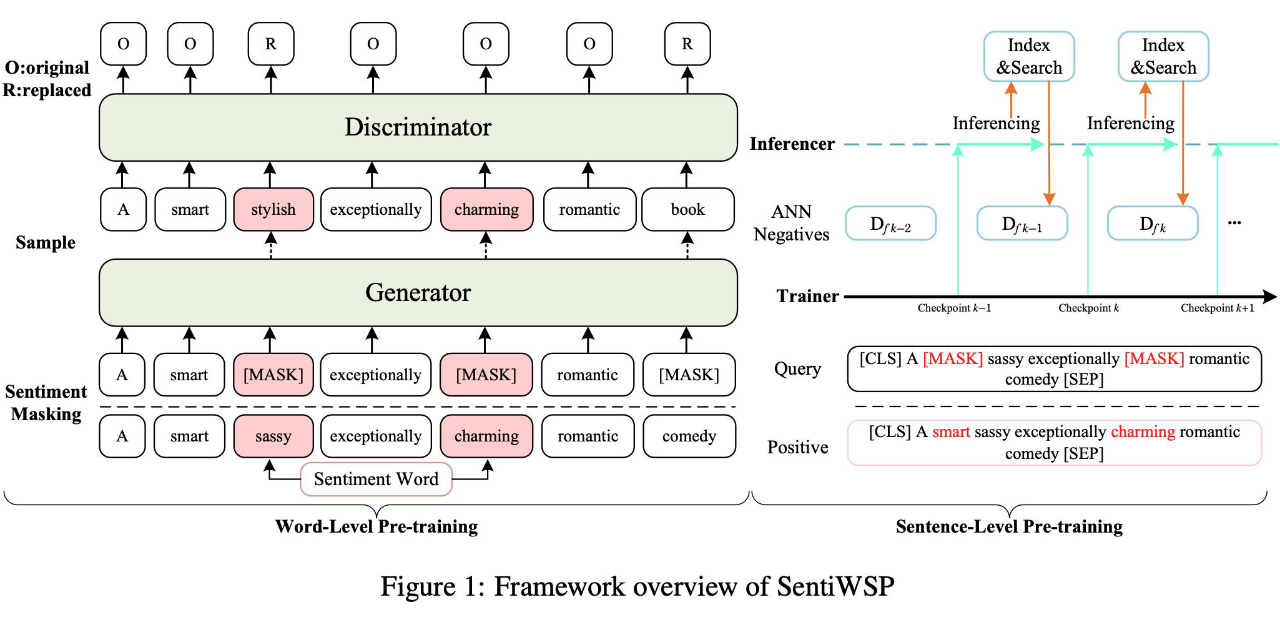
SentiWSP 分别从词级别和句子级别分别设计了相关的预训练任务来提升模型对于文本情感信息的捕捉,在词级别使用情感词替换检测任务,通过生成器和判别器联合训练,增强判别器对于文本中情感信息的学习。然后,通过设计的对比学习框架来提升经过词级别训练之后的判别器对于整个句子情感层面的信息捕捉能力。接下来介绍我们设计的预训练任务的细节。
2.1 词级别预训练
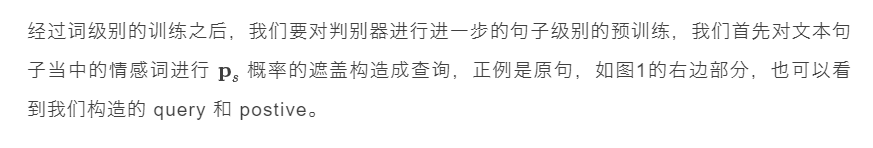
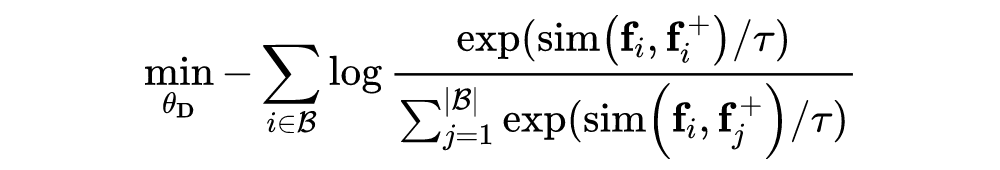
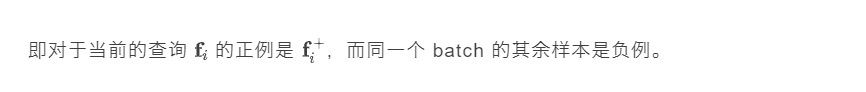
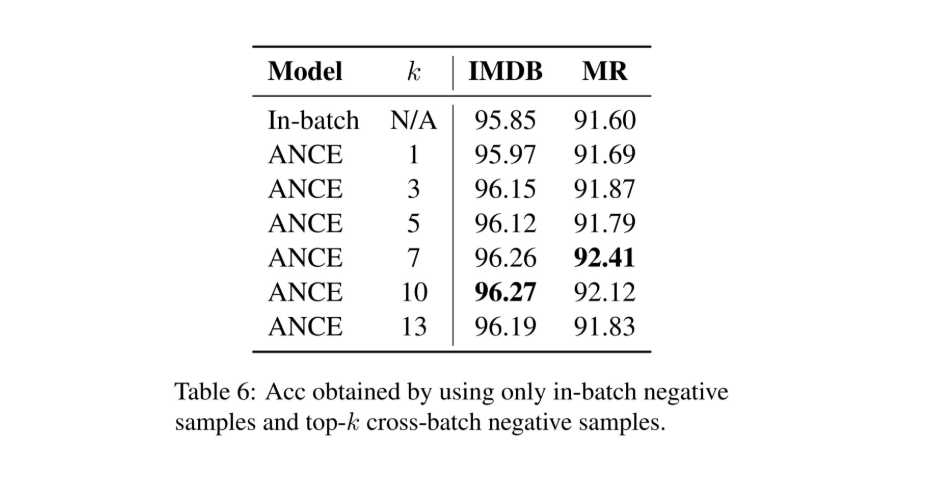
因为 in-batch 内的样本对于模型来说已经形成不了更多的考验,因此我们设计了一个基于 ANN 检索的难负样本挖掘,在 cross-batch 中选择更具有难度的难负样本来对模型进行进一步的学习。
随着模型的逐渐学习,我们会更新当前所有 query 的难负样本,然后训练下一个 checkpoint 模型,以此迭代,这一部分的优化目标是将正例拉近,负例拉远:
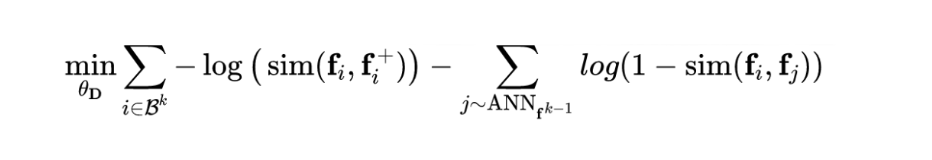
03 实验结果
我们通过在 wikipedia 的语料上预训练我们的模型,我们加载 ELECTRA 的模型作为我们的初始参数。然后我们在一些下游任务上面微调验证我们模型对于情感分析任务的有效性。
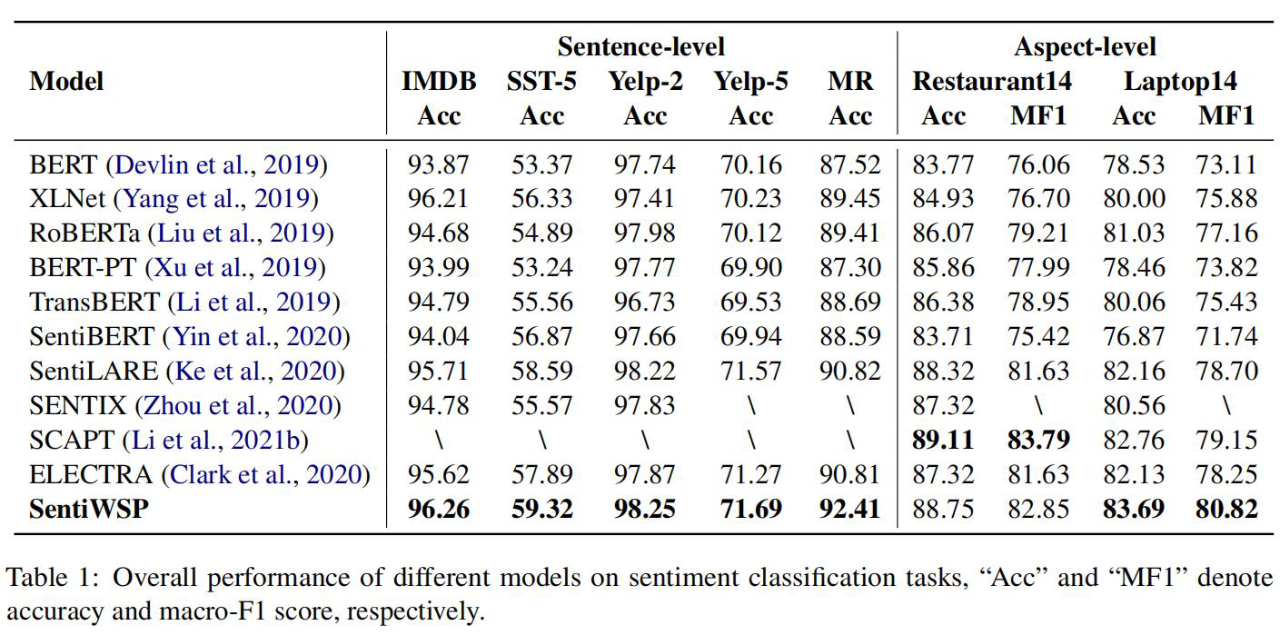
主实验部分,我们对经过我们预训练之后的模型在 5 个最常用的开源句子级别情感分类的数据集 SST,IMDB,MR,Yelp-2/5 和方面级情感分类 Semeval2014 数据集两个子集 Resaurant 14 和 Laptop14 上面做微调进行实验:
对比基线得到的效果如下:
对比近两年的一些情感领域的预训练工作以及通用的预训练模型的效果,我们的模型在句子级别数据集上面都有着最好的性能。 在方面级情感分析的数据集上,我们的总体效果达到了最优,在其中一个子集即 Restaurant14 上略逊于 SCAPT 这篇专门针对方面级情感分析所做的工作。 对于 ELECTRA,我们在所有数据集上都有着效果上的提升,这证明了我们预训练任务的有效性。
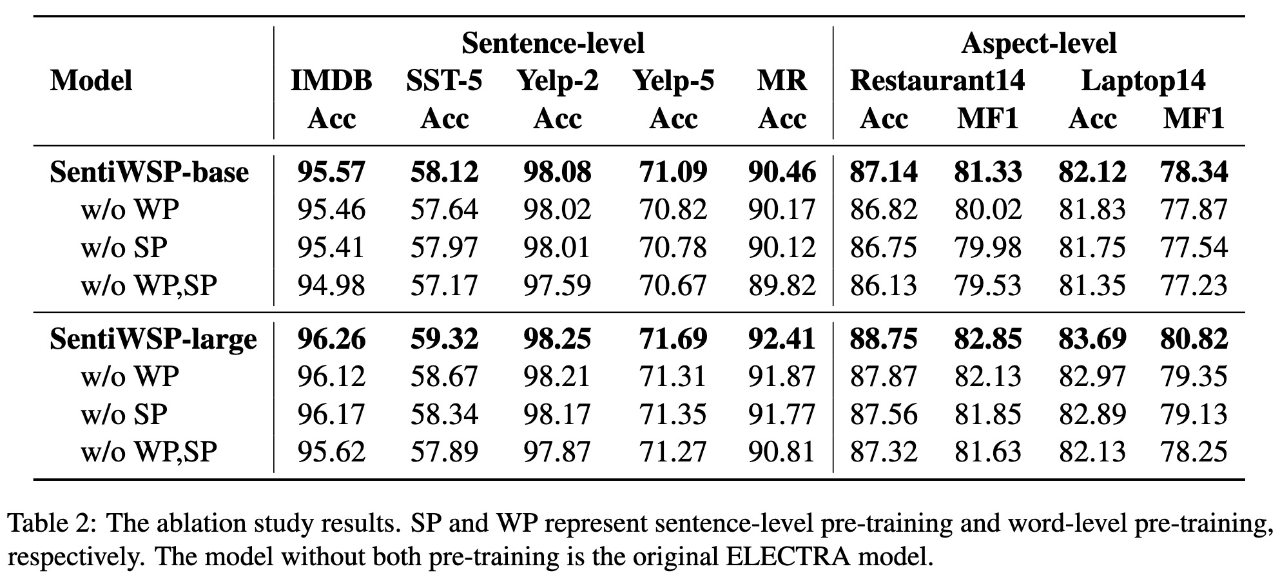
对于我们提出的两个预训练任务,我们进行了消融实验分析。发现我们提出的预训练任务在不同规模的模型上都有着很好的性能。base 版本是 12 层 768 隐层而 large 是 24 层 1024 隐藏层大小的模型。
使用词级别和句子级别的预训练任务之后模型在所有情感分类下游任务上都得到了提升,对与不同大小的模型而言结论相同 词级别和句子级别的预训练任务都很重要,并且在不同的数据集上面表现并不相同。 使用我们的预训练任务训练的 base 版本的模型甚至优于一些通用预训练模型的 large 版本,例如 BERT,RoBERTa。
同时我们也做了一些相关的参数实验验证不同实验设置下我们提出的预训练任务的有效性。
04 总结
