
 语音小管家
Wenet 社区正式发布 wespeaker, 面向研究和产品的说话人表征学习框架,wespeaker 具有高质量,轻量级,面向产品,支持工业级数据训练,在线数据增强等诸多优点,欢迎大家体验、贡献。目前该工作已投稿ICASSP 2023, 论文预览版可见 :
https://arxiv.org/pdf/2210.17016.pdf
目录
说话人表征学习简介
Wespeaker 的整体设计
特性
整体架构
数据管理 (Data Management)
在线特征准备
模型支持
模型训练
打分与metric 计算
Recipes
VoxCeleb 说话人确认性能
CNCeleb 说话人确认性能
VoxSRC 说话人日志性能
部署
Demo
未来方向
说话人表征学习简介
说话人身份是人类语音中最重要的属性之一,说话人建模也被应用在多个相关的应用场景中,比如说话人身份认证,个性化交互。近年以来,固定维度的向量表征成为说话人建模的主要形式,而建模手段也从基于因子分析的i-vector 逐渐过渡到目前流行的神经网络方案。除了常见的说话人识别任务以外,说话人表征还经常被应用到如下相关领域:
说话人日志(speaker diarization): 基于说话人表征的聚类、相似度计算 语音识别 (speech recognition) :说话人自适应训练 语音转换 (voice conversion) :说话人音色建模 语音合成 (speech synthesis) :说话人音色建模 目标说话人增强 (target speaker enhancement): 作为目标说话人的reference。
常见的基于神经网络的说话人表征学习框架如下图
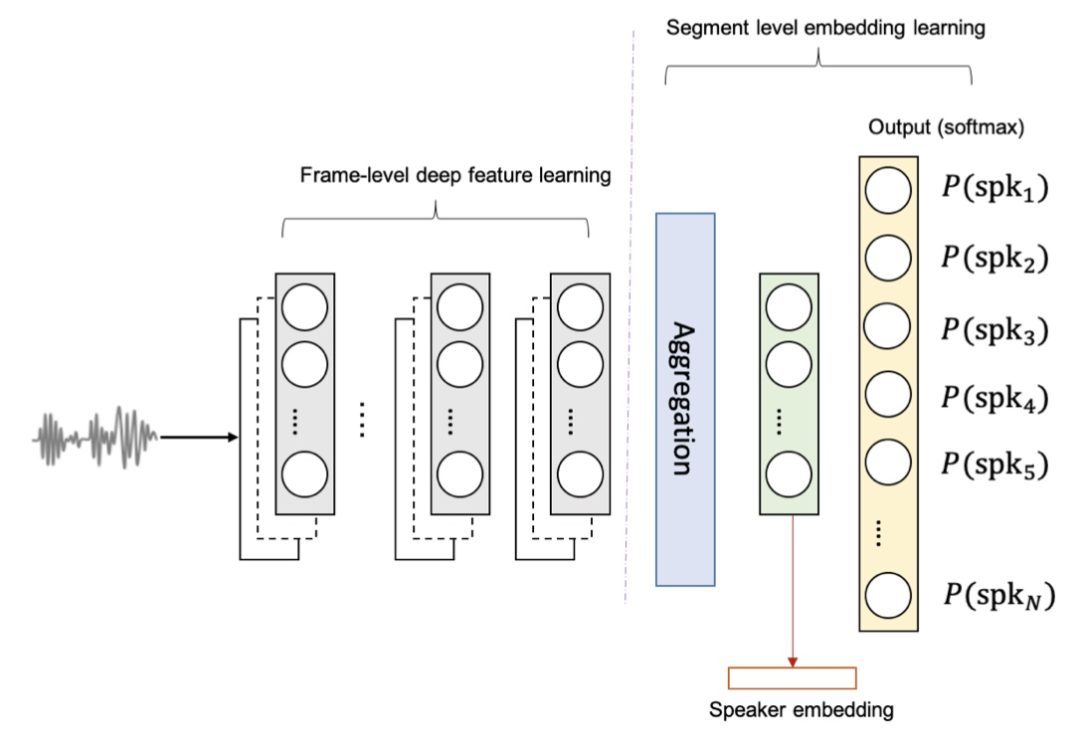
一个典型的说话人网络分为帧级别的特征学习层、特征聚合层,段级别表征学习层。通过说话人区分性的训练准则来进行学习,在段级别层进行说话人表征的提取。
Wespeaker 的整体设计
特性
高质量:wespeaker 通过精心设计的训练策略、优化方法,能够得到高质量的说话人表征提取器,在下游任务如说话人确认、说话人聚类上取得较有竞争力的效果。 轻量级:wespeaker的代码逻辑简单,结构整洁,聚焦于说话人表征学习任务,并且不依赖于kaldi(但是支持kaldi 特征),完全建立在pytorch 和相关生态之上。 支持超大规模数据:类似wenet 的UIO 设计,支持从几小时到数万小时的工业级数据的模型训练 在线数据增强:wespeaker提供了一套完整的在线数据增强方案,包括了重采样、加噪、加混响、速率扰动等策略,能够增强模型训练过程的数据的丰富性,有助获得更鲁棒的模型。 提供部署方案:wespeaker提供了基于onnx-runtime,triton inference server 的部署方案,并且提供了相关预训练模型与支持快速体验的python binding。
整体架构
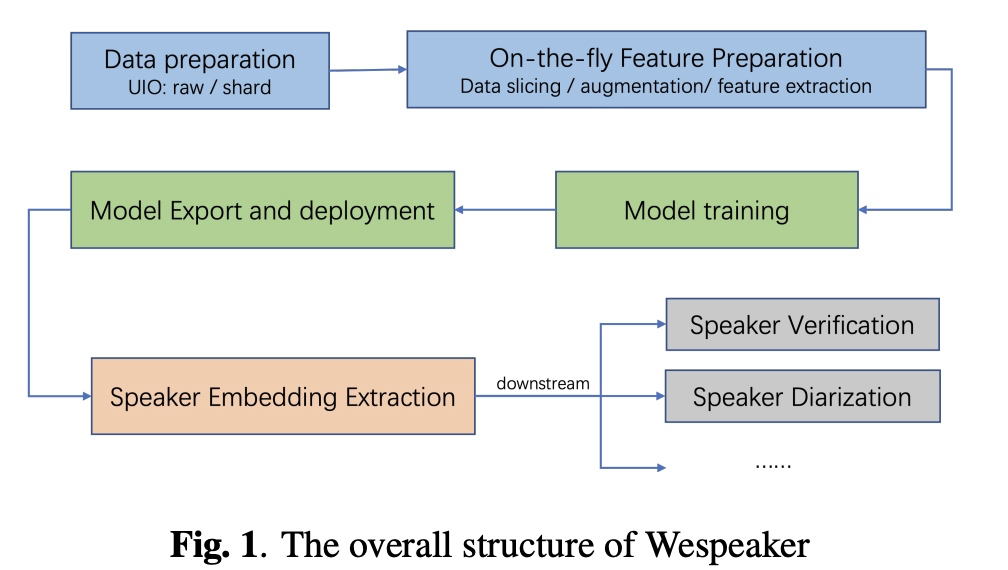
wespeaker 的系统流程图如下图所示,包括本地数据准备,在线特征准备;模型训练;模型部署;说话人表征提取;相关下游任务使用。
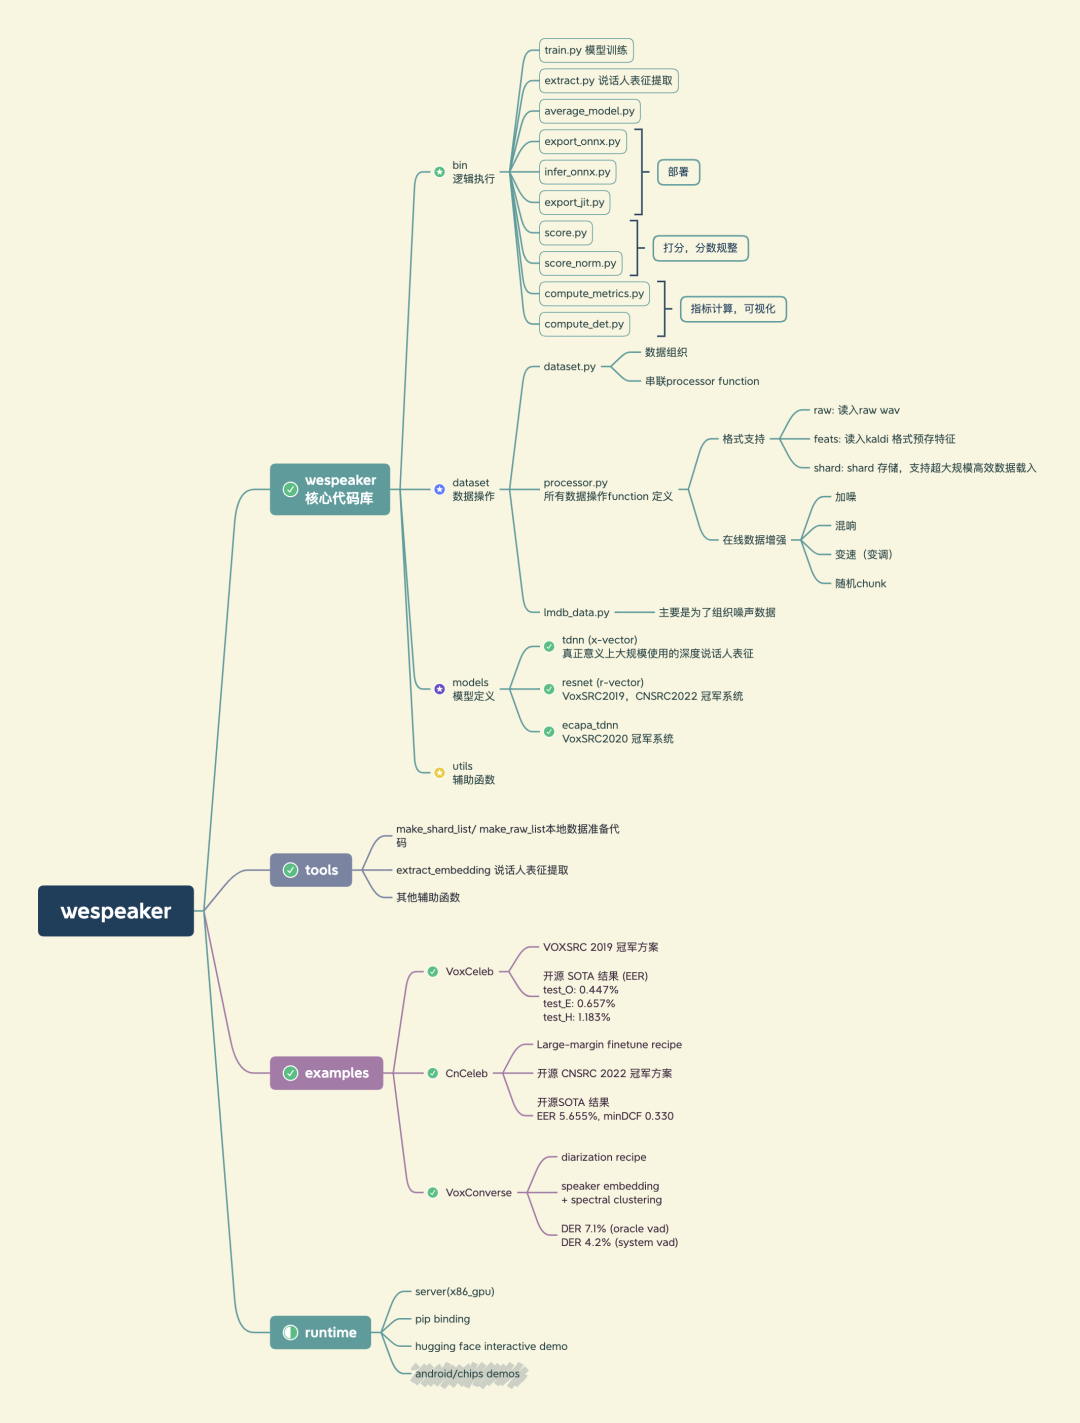
wespeaker 的官方repo 比较简洁,整体框架大致如下图所示,具体可参考我们的官方repo。
数据管理 (Data Management)
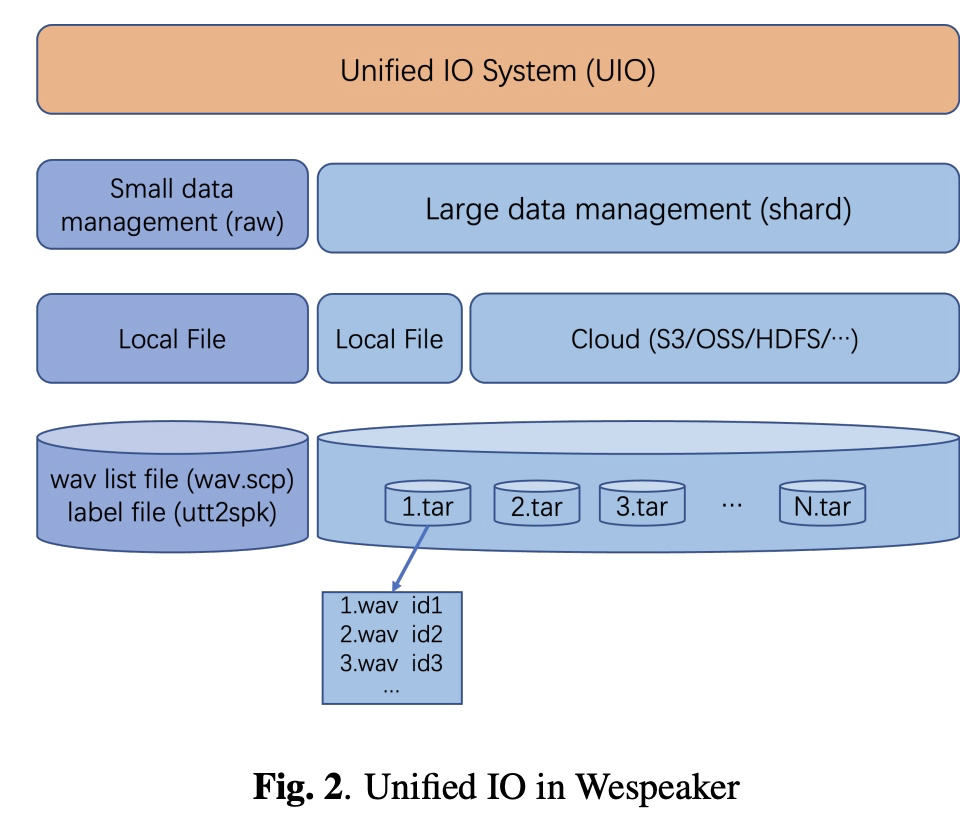
在工业级的应用中,说话人表征训练使用的数据的量级往往与语音识别相当,类似wenet,我们采用了UIO的方式,对不同规模的数据集进行支持。除了对于基本的raw格式的支持外,对于小数据集,UIO采用lmdb格式进行存储(wespeaker 中主要用来存取噪声集合和混响集合),对于大规模数据集,我们推荐采用shard模式。两种模式都能避免小文件的大量读写,并能保证文件读入速度与随机性。更详细的关于UIO的讲解可以参考这篇文章。除此之外,为了兼容业界常用的kaldi 特征存储格式,我们也默认保留了feats接口。
在线特征准备
在线特征准备的流程如下图所示
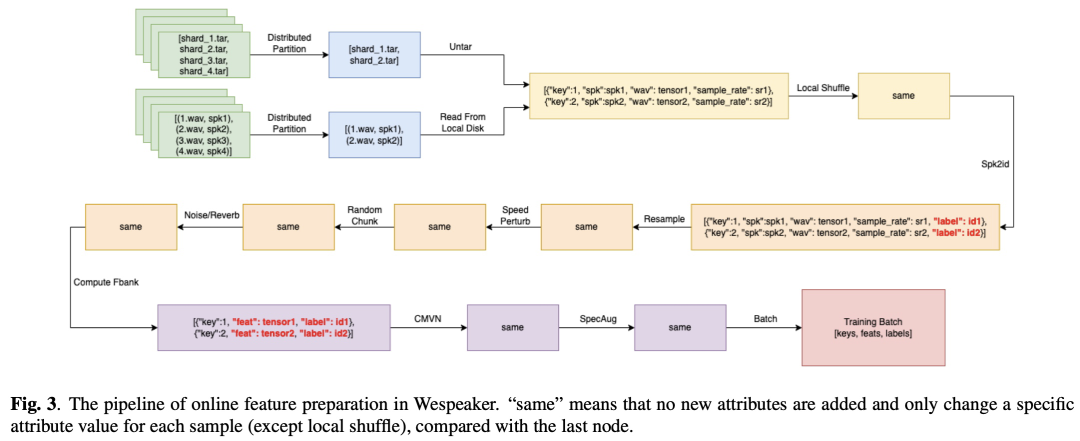
相对于传统的离线特征准备,主要有两大优势:
不需要花费额外的磁盘空间去存储大量的加噪或其他变换后的音频,能够大大减少磁盘占用 离线生成的特征在训练过程中是一成不变的,而在线方式在每个epoch 模型见到的数据都不一样,这种不确定性和随机性能够大大提升样本利用率和模型的鲁棒性。
模型支持
wespeaker 支持较为流行的、性能表现比较好的主流模型,具体如下,
基于TDNN 的x-vector 系统,这是基于深度学习的说话人表征正式超过传统方案的一个里程碑模型. 基于ResNet 的 r-vector 模型,是基于ResNet 结构并且adapt 到说话人识别任务的一个模型, 作为主要建模方法赢得了 VoxSRC 2019 和 CNSRC2021 两个国际说话人识别比赛,我们提供了从18层到293 层的多种配置。 ECAPA-TDNN, 作为原始TDNN 的扩展模型, 是 VoxSRC 2020 冠军系统的主要模型.
模型训练
wespeaker 提供了margin based softmax 系列的训练准则,并且提供了精细的学习率调节方案与损失函数的margin 调节方案,最后我们也提供了比赛中常用到的利用长语音、large margin 进行finetune 的相关recipe.
打分与metric 计算
对于说话人相关应用而言,wespeaker提供了cosine 打分策略、PLDA 打分策略、分数规整策略、EER/DCF/DER 计算策略与相关的 DET 作图支持。
Recipes
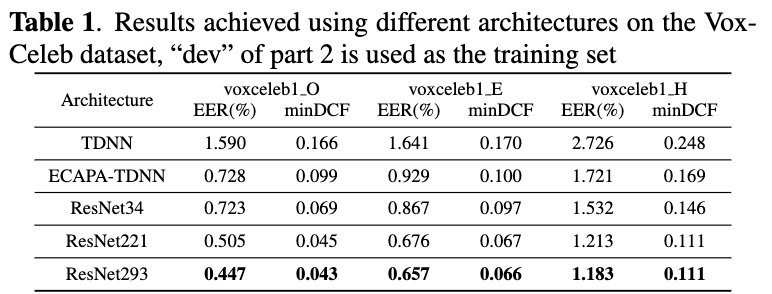
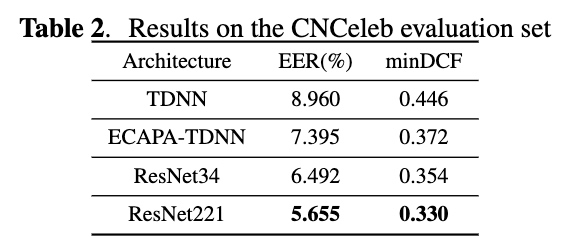
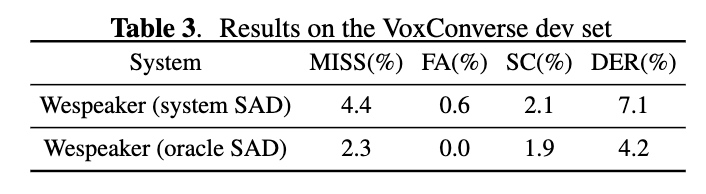
wespeaker 目前包括了三个recipe:VoxCeleb 和 CNCeleb主要关注说话人确认任务,提供了非常强的开源实现。VoxConverse 则是一个简单的说话人日志的recipe,里边使用了 VoxCeleb 中的预训练模型,可以当做一个说话人日志任务的baseline 和 说话人表征应用于下游任务的一个模板。
三个recipe 上的主要结果如下:
VoxCeleb 说话人确认性能
CNCeleb 说话人确认性能
VoxSRC 说话人日志性能
采用了VoxCeleb Recipe中的 ResNet34 模型作为说话人表征提取器。
部署
目前 wespeaker 支持onnx 格式导出,并提供了triton inference server 的相关实现,作为后续,我们将支持如 android 平台的相关部署。
Demo
预训练模型
wespeaker 提供了在两个开源数据集上的 resnet34 预训练模型,包括 runtime 的onnx版本与 pytorch 的ptcheckpoint.
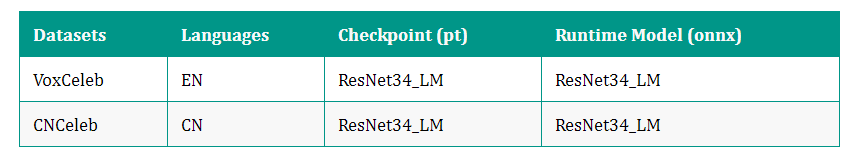
onnx 模型可以通过如下命令快速体验
python wespeaker/bin/infer_onnx.py --onnx_path $onnx_path --wav_path $wav_path欢迎大家在自己的数据集上进行训练,贡献模型!
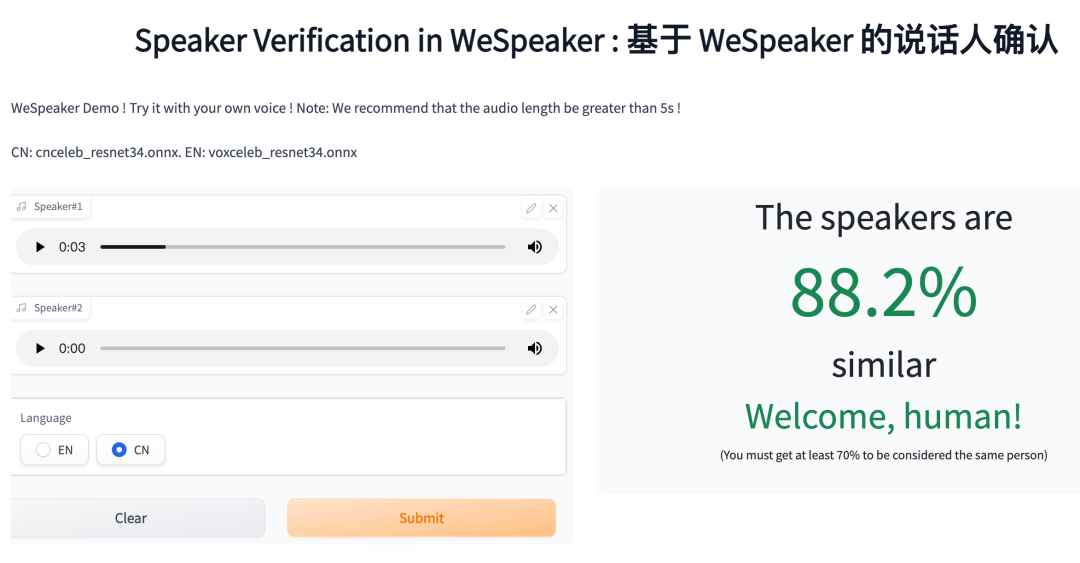
Hugging face 交互 demo 体验
pip install / 预训练模型体验
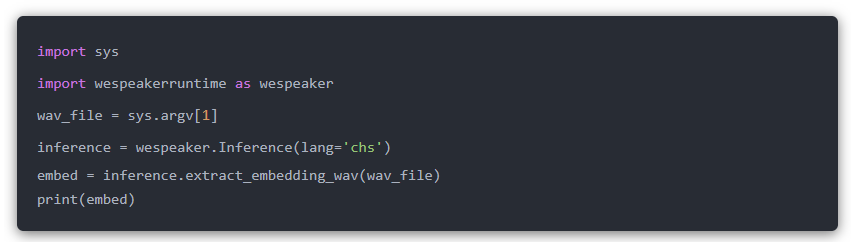
为了方便用户聚焦于下游任务,而不必花太多时间在说话人表征的模型的训练工作上,我们提供了中文、英文的预训练模型,并且提供了 工具包的python binding.
可以通过如下的pip命令进行相应的python 包安装。
pip3 install wespeakerruntime一个示例用法如下,更多的信息可以参考相关页面
未来方向
目前,wespeaker 1.0 包括了sota模型与一部分的部署相关的实现,在轻量化的代码框架下可以训练得到非常高质量的说话人表征,可应用于不同的下游任务。在未来,我们会更关注如下几个方面:
SSL 利用工业界大量的无说话人标签的语音数据 模型小型化,满足更多场景受限如芯片层面的调用 持续添加新的说话人模型,优化训练策略。
欢迎大家使用wespeaker,服务于各种下游任务,也欢迎社区的贡献和宝贵建议!
