我们在 2021 全国声学大会的报告中,探讨了新一代语音识别技术的若干新特点,特别是数据高效、自动机器学习以及可信赖。本文是我们面向数据高效语音识别的新工作,介绍清华大学语音处理与机器智能实验室(Speech Processing and Machine Intelligence, SPMI)与它思科技的联合工作—用单通道数据改进麦克风阵列语音识别系统。该工作已被语音语言技术领域的国际会议 ISCSLP2022 录用,论文的作者是安柯宇、肖吉、欧智坚。论文链接:
http://oa.ee.tsinghua.edu.cn/~ouzhijian/pdf/multi_channel_ISCSLP_camera.pdf
引言
阵列感知(microphone array processing) 是语音前端 (front-end) 的关键技术之一。相对于单麦克风,多麦克风可以通过对输入进行空间滤波,抑制来自非目标方向的干扰信号,从而增强语音的质量。而语音识别则是将语音转录为文本的技术。阵列感知和语音识别具有任务的上下游关系,通常来说,阵列处理得到的增强输出会作为语音识别系统的输入。在传统方案中,阵列感知模块和语音识别模块是分别进行优化的,这有可能会造成前后端的失配,影响最终的识别准确率。受已有工作的启发,我们构建了阵列感知与语音识别一体化系统,在一个统一的框架内实现阵列感知和语音识别。然而,已有的研究表明,训练由多个模块组成的多通道端到端 ASR 系统比训练单通道 ASR 系统困难很多。具体而言,多通道端到端系统的直接优化有可能导致训练发散,或最终结果不佳。另一个困难是有标注多通道数据的收集成本相对较高。此外,一体化训练还存在前后端对数据量的需求不一致的问题: 一般而言,前端模型完成的任务 (时频掩模估计) 相对简单,模型相对较小,所需要的训练数据量也较小。已有的一些研究表明,仅需几十个小时的带噪语音和干净语音配对数据,即可训练一个有良好表现的前端系统;后端模型完成的任务 (完成音频到文本的序列到序列映射) 则相对复杂,模型相对较大,所需要的训练数据量相对较大。在工业生产环境中,后端系统,尤其是端到端系统,往往需要上千甚至上万小时的训练数据。为了解决这些问题,我们探究了利用单通道数据改进多通道一体化系统性能的三种方案,下面将进行详细介绍。
多通道端到端语音识别
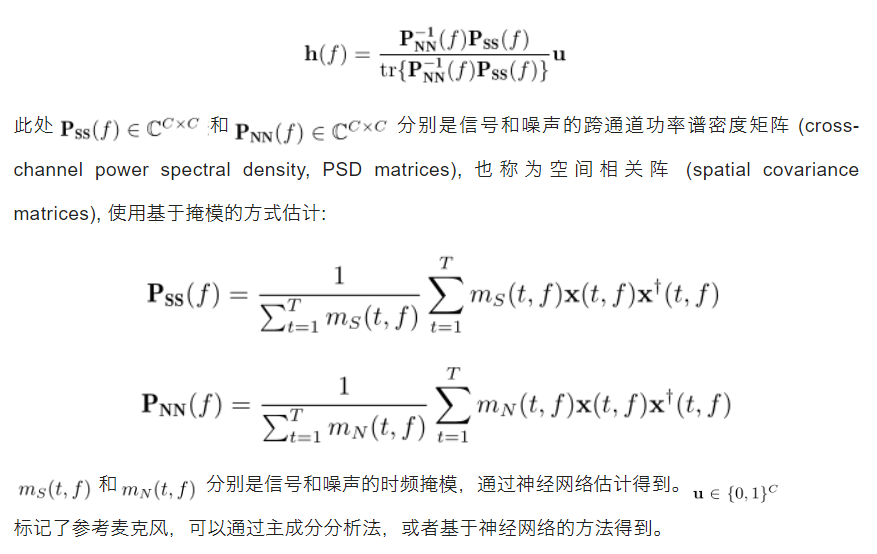
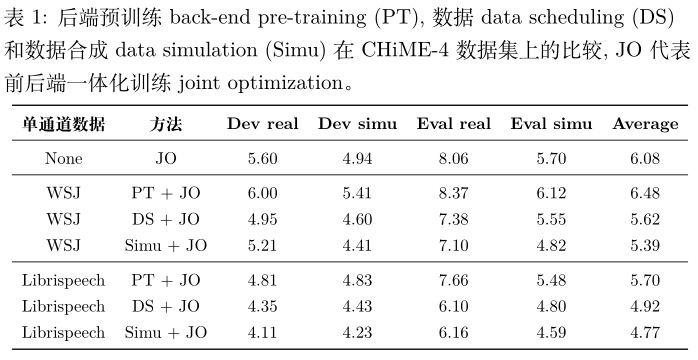
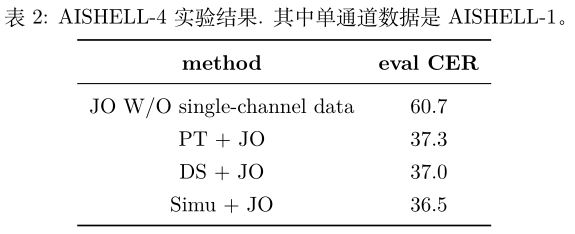
我们的多通道端到端语音识别系统由基于 MVDR 的神经网络波束成形器和基于 CTC-CRF 的语音识别后端构成。下面将分别进行介绍。基于 MVDR 的神经网络波束成形器,包括了 MVDR 波束成形器、跨通道功率谱密度估计模块和时频掩模估计模块。MVDR 通过求解最小方差无失真响应 (minimum variance distortionless response) 得到波束成形滤波器系数:对于后端语音识别系统,我们选取了最近提出的 CTC-CRF。在普通CTC 中,状态间具有条件独立性,无法建模状态间的依赖关系,而 CTC-CRF 通过引入边势能建模了状态间的依赖关系。CTC-CRF 的训练遵循了CRF 训练的标准步骤,损失函数的梯度是经验期望和模型期望两者之差,两项可以在分子和分母图上分别用前后向算法计算。值得指出的是,CTC只涉及分子图上的运算,可以看成 CTC-CRF 的一种特例。在多个中英文数据集上的评测结果表明,CTC-CRF 表现远好于 CTC,与目前最先进的模型表现相当。其详尽介绍请参考文献 CRF-based Single-stage Acoustic Modeling with CTC Topology.我们使用了三种方法来利用单通道数据改进一体化系统的性能。在多通道端到端语音识别系统中,利用单通道语音数据的第一种方法是,进行后端预训练。具体来说,训练过程包括两个阶段。在第一阶段,使用单通道语音数据对后端声学模型进行训练。在第二阶段,我们执行多通道端到端联合优化。在多通道端到端语音识别模型中,前端产生的增强特征频谱应该与单通道 (干净) 语音的特征频谱相似。因此,与随机初始化相比,后端预训练有望为声学模型提供更好的初始化。然而,在预训练阶段后端可能会过拟合单通道 (干净) 语音,甚至降低联合优化的性能,尤其是当预训练所用的单通道数据较少时,我们将在后面的实验中详细讨论。利用单通道语音数据的第二种方法是,数据调度 (data scheduling)。与上一节中描述的两阶段训练方式不同,数据调度在单个阶段内进行。在数据调度中,训练数据来自两个来源: 多通道集和单通道集。当训练批次 (training mini batch) 来自多通道集合时,我们将执行多通道端到端联合优化。否则,我们绕过前端,只用单通道数据训练后端。在这种机制下,后端声学模型将同时使用原始 (未增强) 数据和增强后的单通道数据进行训练,因此对输入变化更加鲁棒。此外,当绕过前端时,后端可以独立优化,这简化了训练,并对多通道端到端训练起到了规范化 (regularization) 的作用。第三种方法是,使用单通道数据模拟生成多通道数据。在这种方法中,我们首先定义一个安置有声源 (单通道样本) 和麦克风阵列的房间,然后计算声源和麦克风之间的房间冲激响应 (RIR)。然后,通过将单通道波形样本与RIR 进行卷积来得到多通道麦克风信号。经过数据模拟,将模拟的多通道数据与真实的多通道数据混合,训练多通道语音识别系统。与后端预训练和数据调度不同,使用模拟多通道数据可以增加前端的训练数据,但代价是训练时间更长。时间成本的增加是由于 1) 模拟数据所需的时间,2) 额外的前端计算,以及 3) 训练时只能使用较小的训练批大小,因为多通道端到端训练的显存消耗比仅使用单通道数据训练后端大得多。在我们的实验中,前端的输入是波形通过 STFT 变换得到的频谱特征。神经网络波束形成器中的掩模估计网络是一个三层 BLSTM。波束成形后,首先将增强的单通道 STFT 特征转换为 40 维对数 fbank 特征,然后进行均值-方差归一化。我们为归一化后的对数 fbank 特征拼接了一阶差分和二阶差分特征,并进行了 3 倍降采样。声学模型是 VGG+BLSTM。BLSTM 每个方向的隐藏层维度是 320。在训练期间,BLSTM 的 dropout 概率为 0.5,以防止过拟合。在后续实验中,如无特殊说明,我们选择的声学建模单元均为音素 (phone)。我们选择 Adam 作为优化器,并应用梯度裁剪来避免训练发散。初始学习率设置为 0.0001,当开发集 loss 不再下降时,学习率变为之前的 1/10,当学习率小于设定的阈值 0.00001 时,训练终止。使用不同量级单通道数据和不同方法的实验结果如表 1 所示,评测指标为词错误率 (word error rate, WER)。可以看到,三种利用单通道数据的方案均提高了多通道语音识别系统的性能,其中数据调度优于预训练,尤其是当单通道数据量比较小的前提下。可能是因为预训练阶段后端会过拟合单通道干净数据。合成数据优于其他两种方式,代价是训练计算和时间开销更大。AISHELL-4 上的实验结果也可以得出相似的结论。
本工作将于近期在 CAT 工具包开源发布,敬请关注!CAT 工具包链接:
https://github.com/thu-spmi/CAT
 超级管理员