语音小管家
摘要:2019年底,清华大学语音处理与机器智能实验室(THU-SPMI)推出了基于CRF的语音识别工具包CAT,在多个基准数据集上取得了前沿性能(State-Of-The-Art,SOTA);2021年10月更新到了v2版。近期CAT工具包完成了较大更新,本文总结了自CAT-v2以来升级发布的三个方面的八处新特点:
最新学术成果——多语言与跨语言语音识别新方法JoinAP(ASRU 2021),流式语音识别新方法CUSIDE(INTERSPEECH 2022),语言模型融合新方法LODR(INTERSPEECH 2022);
功能完善——RNN-T的支持,语言模型的支持,torchaudio特征提取;
工程优化——工业级大数据下的训练,更简洁易用的流程配置等。
本次升级版本名为CAT-v3,赶紧来看~
01 CAT愿景
数据高效端到端:在保持端到端系统简洁性同时,保留声学模型(AM)与语言模型(LM)的必要分解,就像在人类听觉和大脑皮层系统中,听觉与语言是分区的。这样利于声学模型的有效训练,也利于进行语言模型融合。
基于条件随机场(CRF)的声学模型:通过全局归一化建模,直接实现序列鉴别训练(sequence discriminative training),并克服局部归一化模型(如Attention, RNNT)固有的标签偏置(Label Bias),同时还能减少模型的曝光偏置(Exposure Bias)。
在先进性、开放性、灵活性和规范性上助力语音识别研究:取得SOTA结果,代码完全开源,架构基于PyTorch生态,灵活易用,对初学者友好且规范,力求结果可复现,不仅提供学术上常用数据集实验脚本,也不断丰富对实际应用所需的流式识别,大数据训练,模型加速等的支持,促进语音识别研究创新与落地应用!
02 CAT-v3新方法
一、多语言与跨语言语音识别新方法JoinAP
Chengrui Zhu, Keyu An, Huahuan Zheng, Zhijian Ou.Multilingual and crosslingual speech recognition using phonological-vector based phone embeddings. ASRU, 2021.
世界上有超过7000种语言,但绝大多数语言对语音识别来讲是低资源的,即缺乏语音识别所需的大量标注数据。多语言(Multilingual)和跨语言(Crosslingual)语音识别技术,旨在借助多个语言的语音数据,利用不同语言间发音的相通性,更好地建立低资源的目标语言的语音识别系统。成功的多语言与跨语言语音识别的关键是,提升多语言训练中的信息共享,并最大限度地将知识从充分训练的多语言模型迁移到新语言的模型。
JoinAP(Joining of Acoustics and Phonology),意为结合了声学(Acoustics)和音韵学(Phonology)的方法。在传统方法中,两个语言之间共享信息只能靠中间那些在两个语言都出现的音素来实现。但音素被拆分为音韵特征表示以后,分别在两个语言中出现的西班牙音素ð和意大利语音素ɛ在音韵特征的层面上有很多相似,他们仍然可以在这一层面上共享信息!
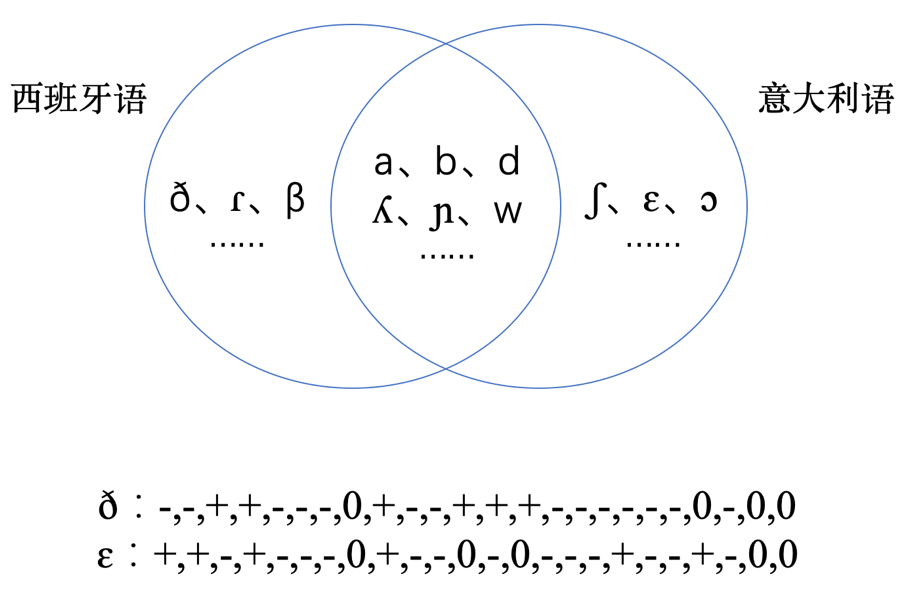
不难看出,JoinAP思想并不局限于多语言与跨语言语音识别,对多方言、混合语言(switch-code)语音识别也类似可用,期待更多探索!
有关JoinAP方法的更多介绍请见:
二、流式语音识别新方法CUSIDE
Keyu An, Huahuan Zheng, Zhijian Ou, Hongyu Xiang, Ke Ding, Guanglu Wan.CUSIDE: Chunking, Simulating Future Context and Decoding for Streaming ASR. INTERSPEECH, 2022.
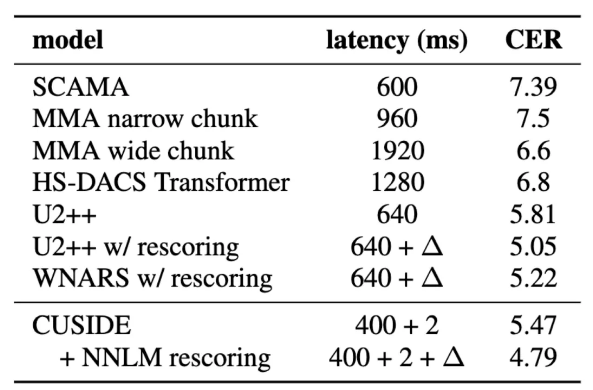
流式语音识别,是指在说话人讲话的同时进行识别;这不同于在离线语音识别中,系统拿到整句话后再开始识别。CUSIDE(Chunking,Simulating future context andDecoding),意为分块、预测未来、解码的低延迟语音识别框架,核心思想是,使用模拟的未来帧而不是真实未来帧来构建上下文感知块,由此免除对未来信息的依赖,减小识别延迟。此外,CUSIDE还通过训练中块大小抖动(chunk size jitter)、流式/非流式模型共享参数和联合训练等方法(unified streaming/non-streaming model),进一步提高了流式模型的识别准确率,减小了流式模型和非流式模型之间的性能差距。
基于CTC-CRF的CUSIDE模型在AISHELL-1上的识别错误率低至4.79%,是目前AISHELL-1上流式模型的最好结果。
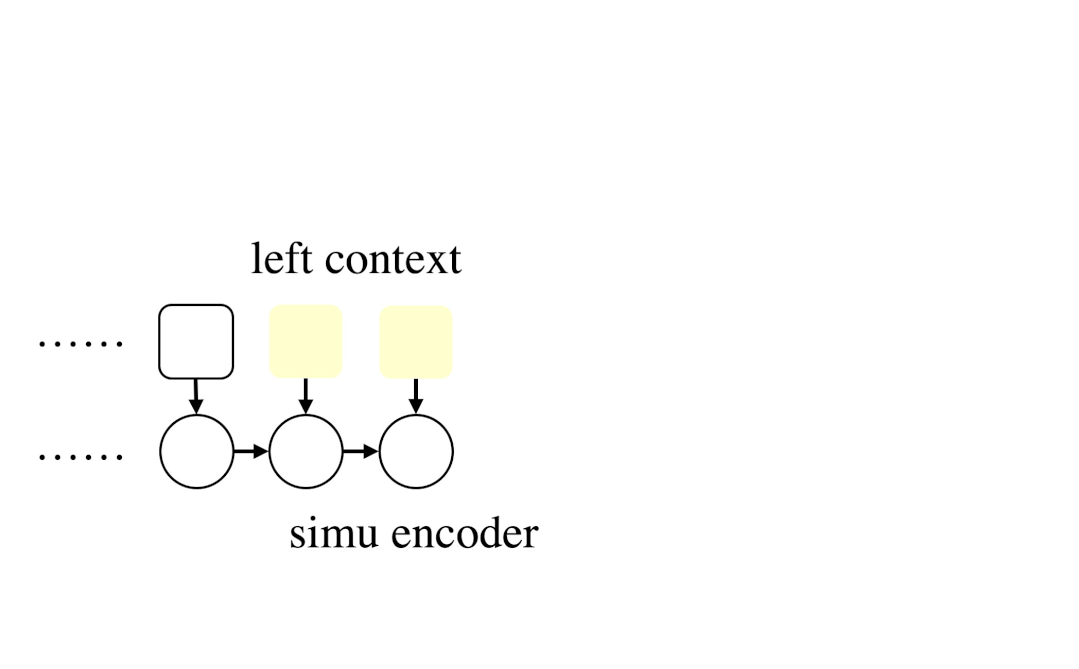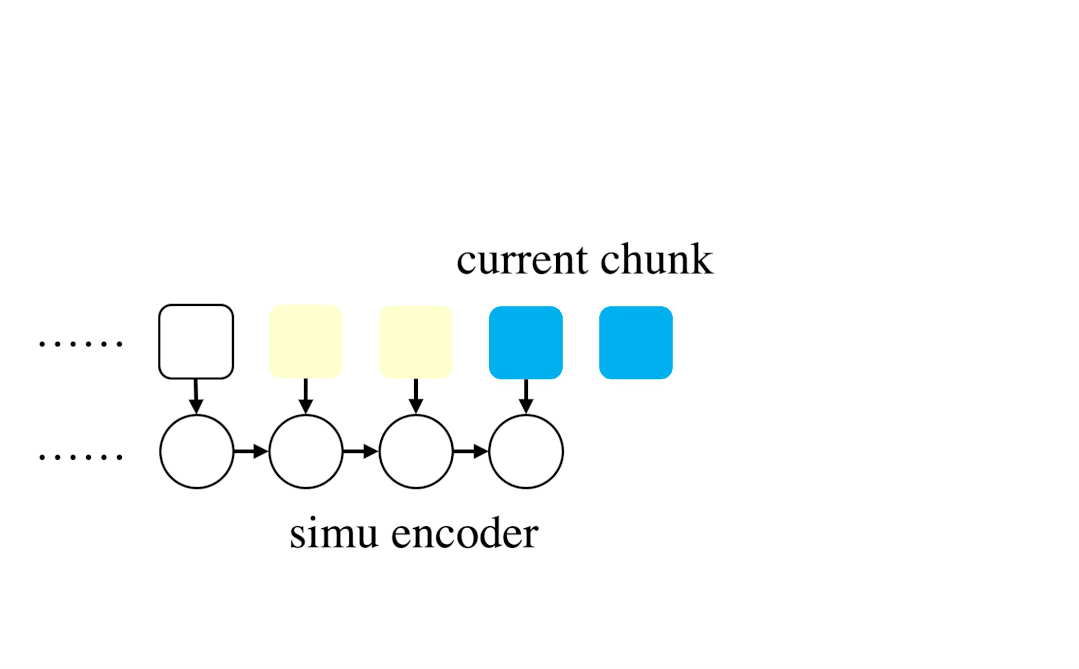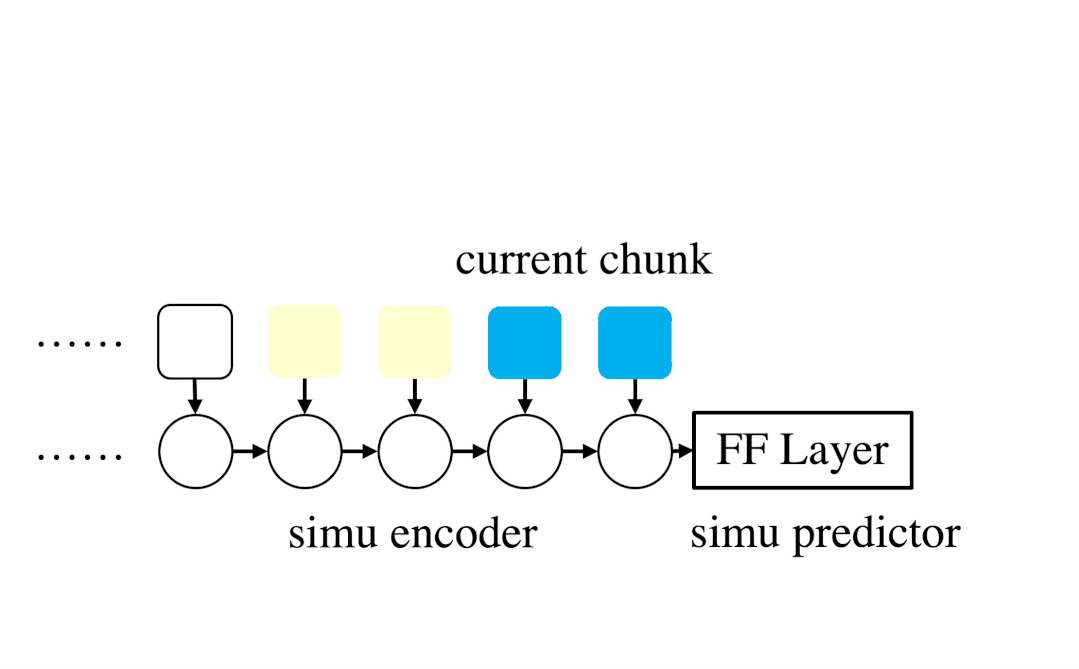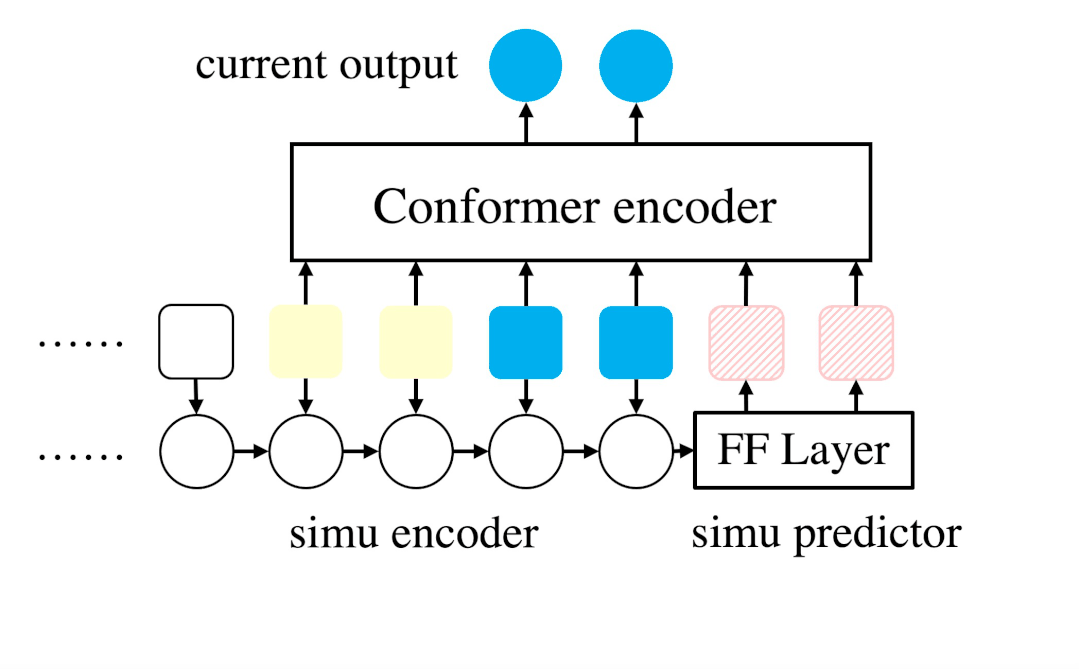
不难看出,CUSIDE思想并不局限于CTC-CRF模型,对其它语音识别模型(如RNN-T、AED),其它语音应用(如语音增强)也类似可用,期待更多探索!
有关CUSIDE方法的更多介绍请见:
三、语言模型融合新方法LODR
Huahuan Zheng, Keyu An, Zhijian Ou, Chen Huang, Ke Ding, Guanglu Wan.An Empirical Study of Language Model Integration for Transducer based Speech Recognition. INTERSPEECH, 2022.
如何利用好海量的纯文本数据,进一步提升识别准确率,是目前端到端语音识别研究的重要问题,也是数据高效的重要特征。像RNN-T、AED这样的端到端语音识别模型,其训练得到后验分布P(Y|X)(给定语音X,文本序列Y的后验分布)的过程中,也隐式学到了一个内部语言模型(Internal Language Model,ILM)。受到贝叶斯公式启发,在融合外部语言模型(External Language Model, ELM)的时候,“减去”ILM,再“加上”ELM的方法最近得到了许多关注,但在端到端系统中,一般无法直接准确计算出ILM,因此如何估计ILM成为一个重要问题。
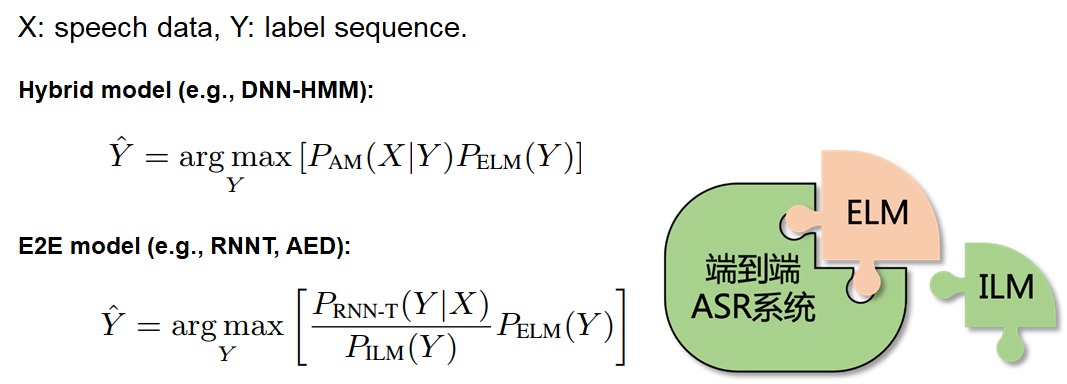
经过一些分析,我们发现RNN-T的ILM,应是一个低阶的比较弱的语言模型,比如在中文时可以用中文字的bi-gram来近似。这就是LODR(Low order density ratio)的基本思想。相比其它的ILM估计方法,LODR计算开销更少,方案更为轻量化,在in-domain、cross-domain均取得了出色的性能。
不难看出,LODR思想并不局限于RNN-T模型,对AED模型也类似可用,期待更多探索!
有关LODR方法的更多介绍请见:
03 CAT-v3功能完善
一、RNN-T的支持
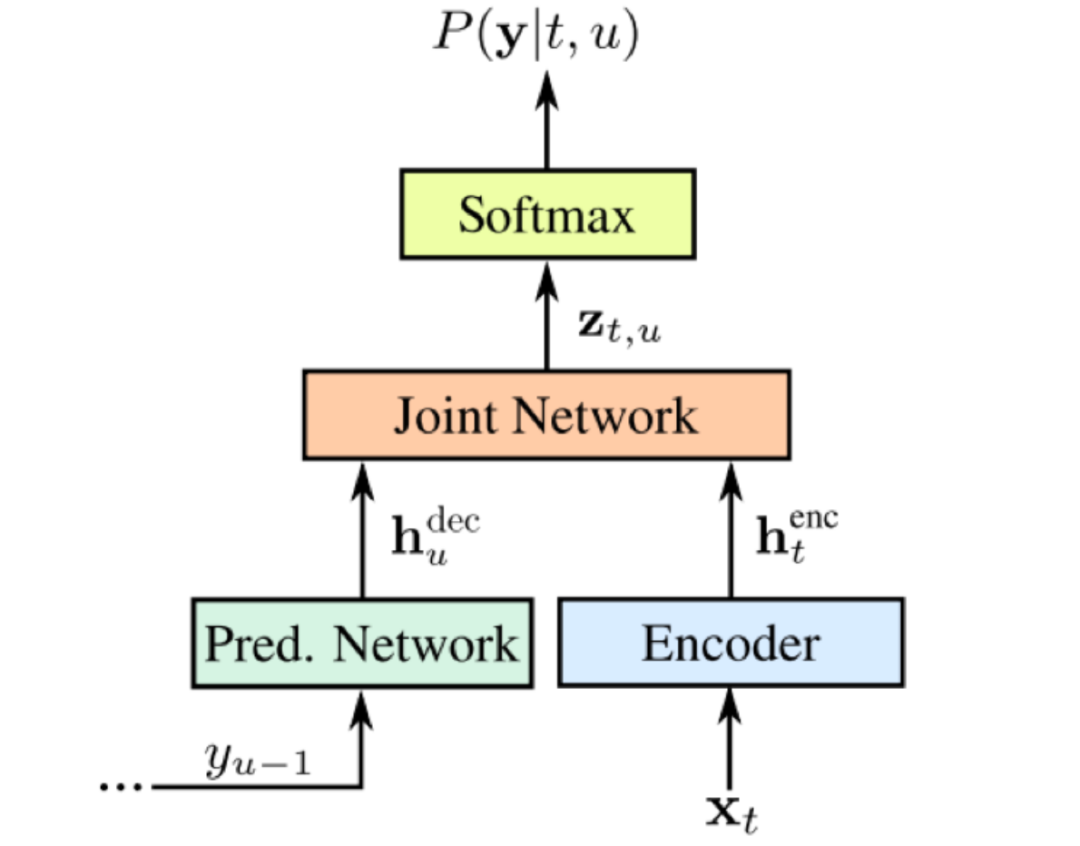
为便于探索与比较,CAT工具包不仅支持CTC、CTC-CRF,本次升级增加了对RNN-T的完整支持,包括训练和解码。
二、语言模型的支持
语言模型是语音识别系统的重要组成部分。本次升级,增加了对语言模型的完整支持,包括不同类型的语言模型的训练、测试和在识别系统中的融合。
支持的语言模型类型包括:n-gram(基于KenLM),自回归神经网络语言模型(支持常用的LSTM, Transformer等神经网络架构,也可自定义)。未来还将加入基于能量模型的语言模型。
支持的语言模型融合方法包括:传统的Shallow Fusion、Density Ratio、ILME,以及最新提出的LODR。
三、torchaudio特征提取
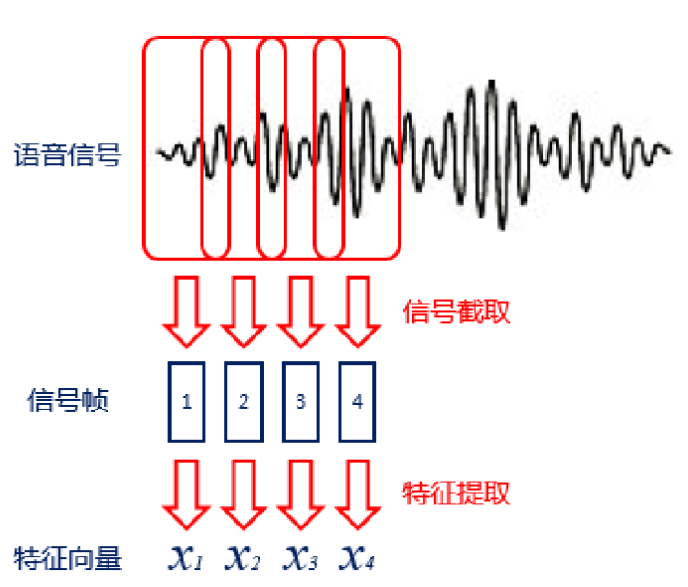
在基于Kaldi的特征提取之外,本次升级增加了基于torchaudio的特征提取。经过验证,二者在性能上基本一致。使用torchaudio提取特征可以免去较复杂的安装Kaldi的步骤,对初学者更为友好。
04 CAT-v3工程优化
一、工业级大数据下的训练
相比v2,本次升级优化了大规模数据下的训练代码。基于webdataset方案,CAT-v3可以方便快速地使用数千、数万小时的语音数据进行训练。
二、更简洁的流程配置
在CAT-v3中,提供了两个配置文件来做实验:
hyper-p.json,包含训练数据集选取,建模单元的选择,评估方式等一些外层超参设置;
config.json,用来定义模型训练用到的超参数。
相比v2使用的老式的 run.sh 脚本,新的基于配置文件的方案,不仅减少了代码的冗余,而且基本上实现了“一站式”配置,让初学者更快、更容易上手使用。
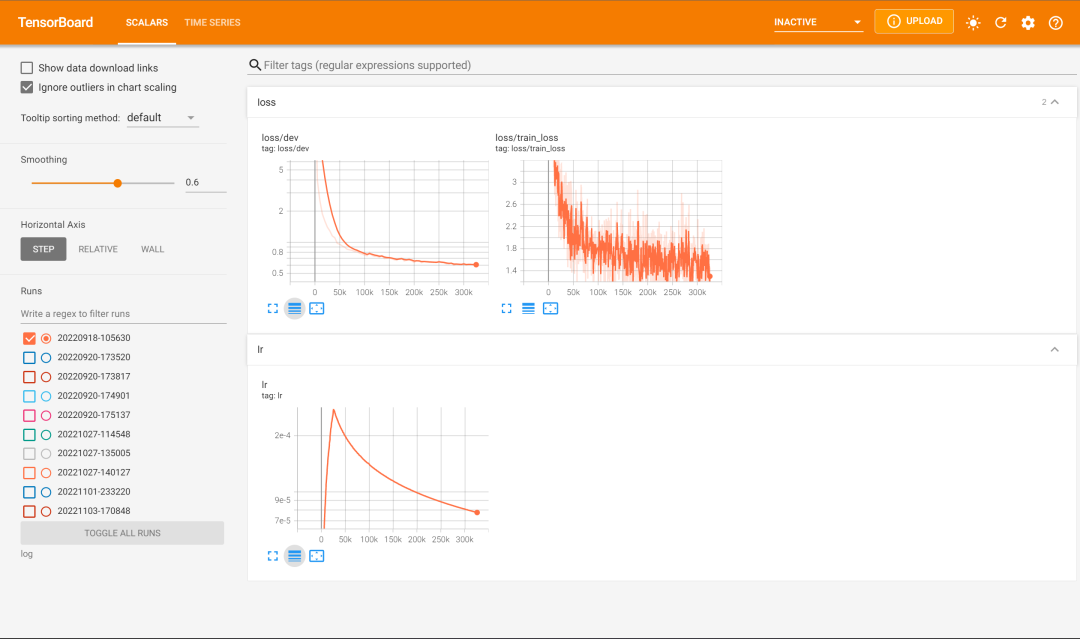
CAT-v3还集成了TensorBoard功能,便于监控实验运行以及做实验分析。
05 展望
CAT将继续在先进性、开放性、灵活性和规范性上助力语音识别研究者!非常欢迎各位同仁批评建议,一起贡献!
注:本文叙述时省去了相关技术细节,感兴趣的读者,请浏览我们的相关文章和Github网址!
Github地址:https://github.com/thu-spmi/CAT