
 智能语音新青年
文章来源于智能语音新青年,作者ttslr
本次分享国立台湾大学李宏毅教授团队与JHU、CMU、MIT、Meta等机构联合发表于ACL2022会议的论文《SUPERB-SG: Enhanced Speech processing Universal PERformanceBenchmark for Semantic and Generative Capabilities》。该论文主要介绍了SUPERB-SG这一个语音处理通用性能的新基准,其侧重通过增加任务的多样性和难度来评估预训练模型的语义和生成能力。
论文作者:
Hsiang-Sheng1*, Tsai, Heng-Jui Chang1*, Wen-Chin Huang2*, Zili Huang3*,Kushal Lakhotia4*, Shu-wen Yang1, Shuyan Dong4, Andy T. Liu1, Cheng-I Jeff Lai5,Jiatong Shi6, Xuankai Chang6, Phil Hall7, Hsuan-Jui Chen1,Shang-Wen Li4, Shinji Watanabe6, Abdelrahman Mohamed4, Hung-yi Lee1
1National Taiwan University, Taiwan
2Nagoya University, Japan
3Johns Hopkins University, USA
4Meta AI, USA
5Massachusetts Institute of Technology, USA
6Carnegie Mellon University, USA
7LXT
0 Abstract
1 Introduction
2 Related work
3 SUPERB-SG
3.1Tasks and Datasets
本节介绍了SUPERB-SG中的任务,还介绍了我们选择这些任务的原因,以及我们如何设计针对特定任务的预测头,和如何对这些预测头进行微调。按照SUPERB的方法,我们采用了一种轻量级的微调方法,即冻结预训练的模型参数,只训练特定任务头的参数。这种设置具有双重目的,一是评估语音表征的鲁棒性和通用性,二是它还可以提高微调模型的效率。我们把预训练的模型称为上游模型,把特定任务头称为下游模型。现在,我们将在以下几个小节中讨论SUPERB-SG中新增加的任务。
3.1.1 Speech Translation
语音翻译(ST)是将源语言的声学语音信号翻译成目标语言的词汇。我们用它来评估SSL模型的语义能力,并且研究它们如何提升翻译任务的能力。我们使用CoVoST En → De作为训练集,并按照官方的切分方法分为训练集、测试集和验证集,同时删除所有含有"REMOVE"的样本,其训练集、验证集和测试集分别包括425.8小时、25.9小时和24.5小时的数据。对于文本,我们保持原始的大小写、规范化标点符号,并建立具有100%训练集覆盖率的字符语料库。我们使用sacreBLEU作为评价标准,它是一个大小写敏感且去符号化的BLEU。我们的下游模型使用一个三层Transformer的编码器-解码器架构,每层的隐藏维度为512。并且还使用了一个卷积子采样器(convolutional subsampler)来减少输入的序列长度,然后再将其送入编码器。我们使用0.1的概率对我们的模型进行标签平滑的训练。推理时的束大小为20。
3.1.2 Out-of-Domain ASR
虽然SUPERB中包含了ASR,但它只在英语语料库LibriSpeech上检验了SSL模型。因此,我们引入了域外ASR(OOD-ASR),旨在评估模型的跨语言能力,以及域外场景。OOD-ASR任务被分为跨语言任务(cross-lingual task)和自发语音任务(spontaneous speech task)。对于跨语言任务,我们从Common Voice 7.0中选取墨西哥西班牙语(es)、普通话(zh)和阿拉伯语(ar)子集,其分别包含21.5、31.2和30.7小时的训练数据,1.2小时、14.4小时和12.24小时大小的验证数据,0.6小时、15.3小时和12.5小时大小的测试数据。对于自发语音任务(spon),我们使用了Santa Barbara Corpus of Spoken American English (SBCSAE) ,其中包括60个不同主题的对话,16.7小时的数据。验证和测试集的大小分别为1.6小时和2.2小时。除普通话使用字符错误率(CER)作为标准之外,其余任务我们使用单词错误率(WER)作为衡量标准。错误率是所有子任务错误率的平均数。ASR模型是一个2层的BLSTM,其隐藏状态维度为1024。训练目标是CTC(Connectionist Temporal Classification)损失。在推理过程中,我们使用CTC贪婪解码,不对语言模型进行重新评分,来简化过程并突出所学到的声学表征的影响。
3.1.3 Voice Conversion
对于语音转换(VC),我们考虑在任意对一(A2O)设置下的VCC2020的内语言VC任务。A2O VC的目的是将任意说话人的语音转换成预定的目标说话人的语音。我们用这个任务来评估说话人的可转移性以及SSL模型的可推广性。我们使用目标说话人的60个时间跨度为5分钟的语料用于训练,25个时间跨度为2分钟的语料用于测试,没有使用验证集。我们使用常用的MCD(mel-cepstrum distortion)、单词错误率(WER)和来自现成的ASR和ASV模型的声纹识别(ASV)接受率作为评价指标。下游模型依赖目标说话人的方式从上游表征中重构声学特征。在转换阶段,将上游提取的表征作为输入,由模型生成转换后的声学特征,然后将其发送到神经声码器合成转换后的波形。我们采用Tacotron2作为下游模型,Tacotron2是一个由卷积层和LSTM层组成的自回归网络。使用Hifi-GAN作为神经声码器。
3.1.4 Speech Separation
语音分离(SS)是将目标语音从背景干扰中分离出来。它是语音处理中的一个重要步骤,尤其是对于嘈杂和多语者的场景十分重要。我们在一个由LibriSpeech和WHAM!噪声模拟的数据集上研究语音分离问题。我们使用包含2个发言人的16kHz版本的数据集,并专注于mix_clean条件。训练和评估集包含43.3和4.2小时的模拟语音,这些语音来自LibriSpeech的train-clean-100和test-clean。这个任务是用来评估SSL模型在输入为混合声学信号时的生成能力。我们使用标度不变的信号失真率改善情况(SI-SDRi)作为评价指标。对于下游模型,我们了使用3层的BLSTM模型,每个方向的维度为896,来预测每个说话人的短时傅里叶变换(STFT)掩码,并使用反短时傅里叶变换(iSTFT)将预测结果转换回时域。并且进行了PIT(Permutation invariant training),以优化预测掩码和理想非负相位敏感掩码(INPSM)之间的均方误差。由于跨度大小的限制和计算成本,我们选择了频域方法而不是基于时域的方法。
3.1.5 Speech Enhancement
语音增强(SE)是指从退化的语音信号中去除背景噪声的任务,其目的是提高信号的感知质量和可懂度。我们使用这个任务评估模型在嘈杂条件下的生成能力。在SUPERB-SG中,我们讨论了Voicebank-DEMAND(V eaux et al, 2013)语料库的语音增强问题。训练、验证和测试集分别包含8.8、0.6和0.6小时的语音。评估指标为语音质量感知评估(PESQ)和短时客观可懂度(STOI)。一个类似于语音分离任务的3层BLSTM模型被训练来预测干净信号的光谱掩码。预测的掩码和INPSM之间的均方误差被作为目标。
3.2 Self-supervised Models
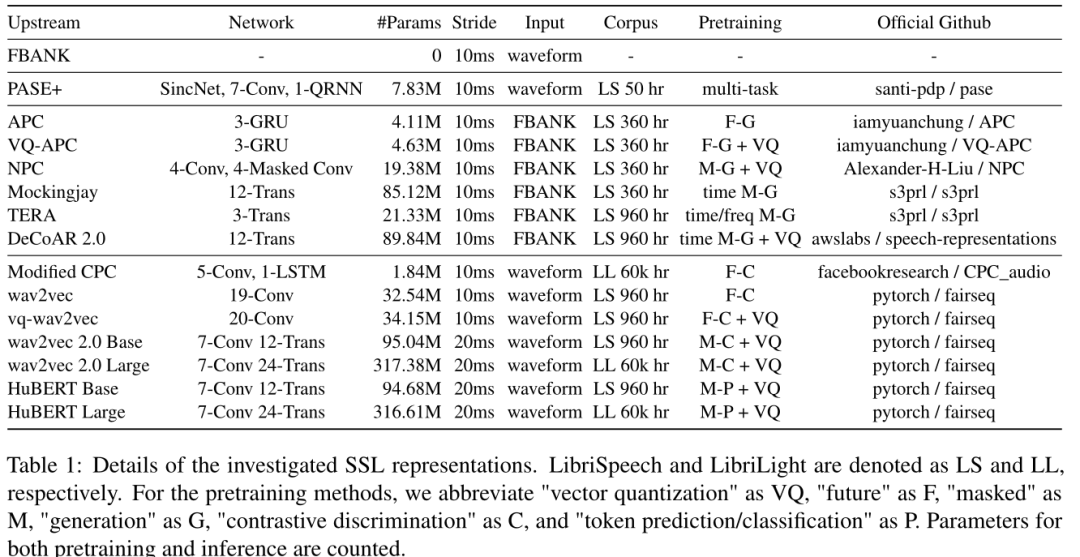
我们在15个上游模型上评估任务,它们是PASE+、APC、VQ-APC、NPC、Mockingjay、TERA、DeCoAR 2.0、Modifile CPC、wav2vec的不同架构以及HuBERT。它们有着不同的架构、规模和学习目标。一些模型还使用了矢量量化,这有一个额外的好处,就是信号压缩。我们还使用Log Mel Filterbank作为基线。表1展示了上游模型的详细属性。
4 Experimental Setup
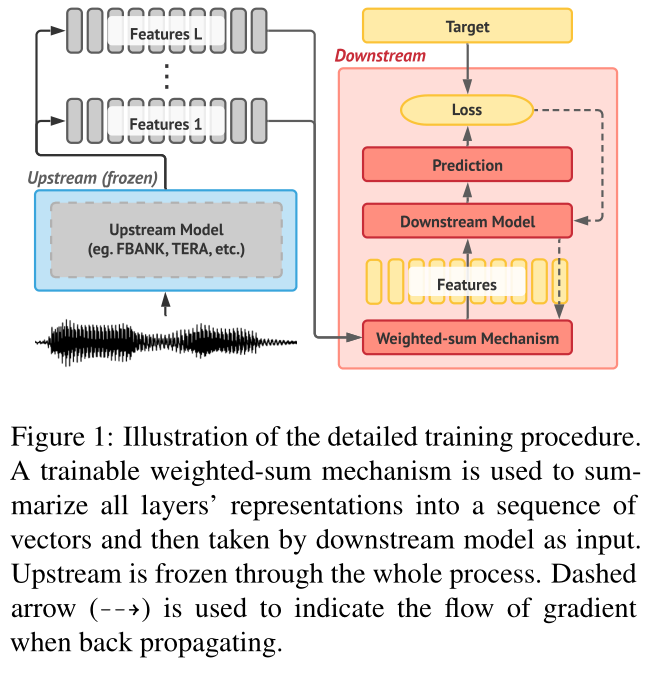
与SUBERP相同,我们为所有下游任务的训练而固定了上游模型的参数。我们从原始波形中提取上游模型每个隐藏层的帧级表征,并使用可训练的特定任务加权机制,将所有层的表征加和为一连串的向量。总结后的表征作为下游模型的输入。图1展示了训练过程的概况。每个实验都使用了相同的种子单次运行完成。所有的实验环境均相同,为所有的上游模型提供一个公平和简单的评估策略。
5 Results and Discussion
5.1 Main result
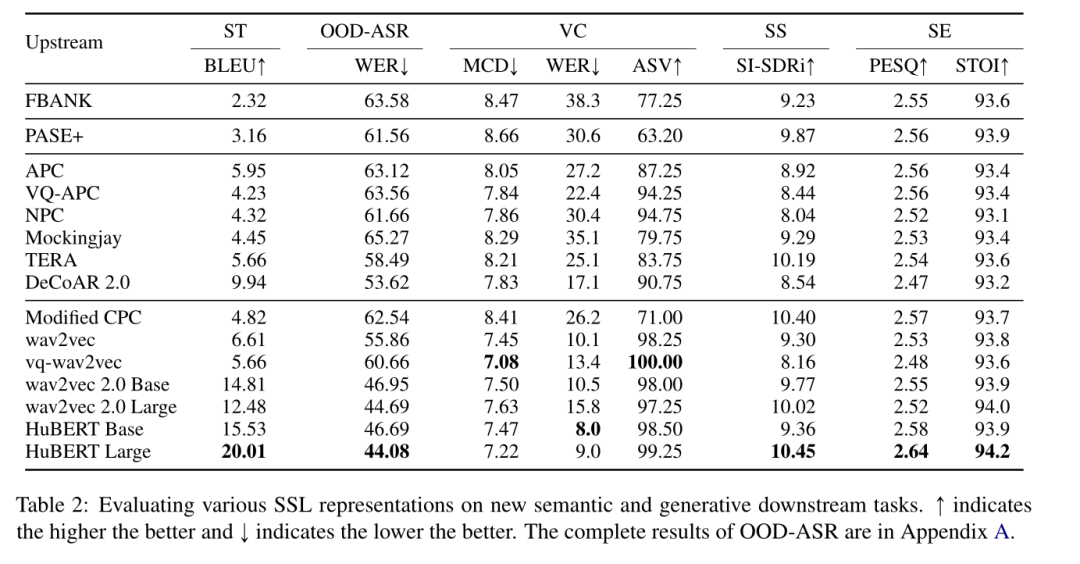
总的来说,没有一个模型在所有的任务上都优于其他所有的模型。但是,HuBERT-Large在所有下游任务中的表现最具竞争力,尤其是对于那些需要语言和语义信号的任务。
5.2 Correlation between tasks
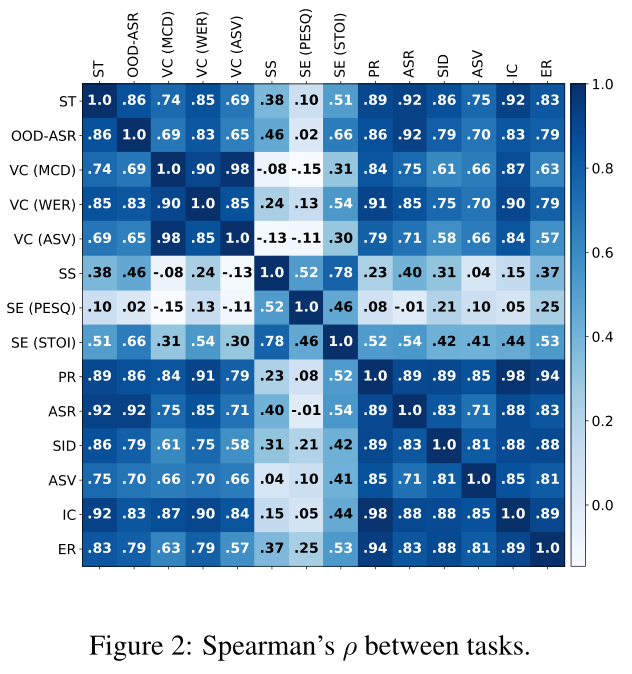
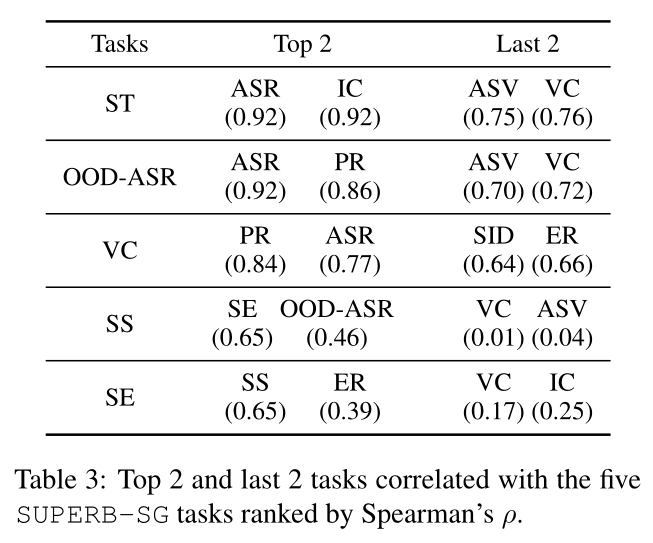
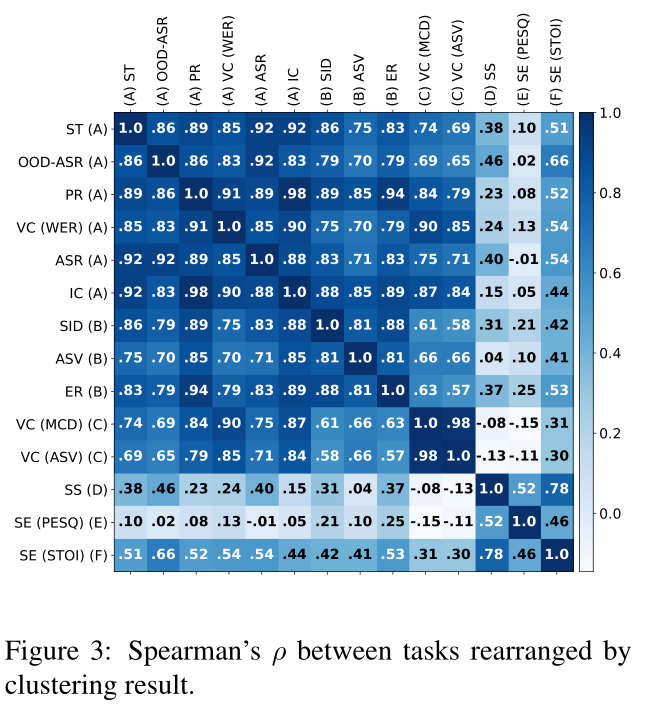
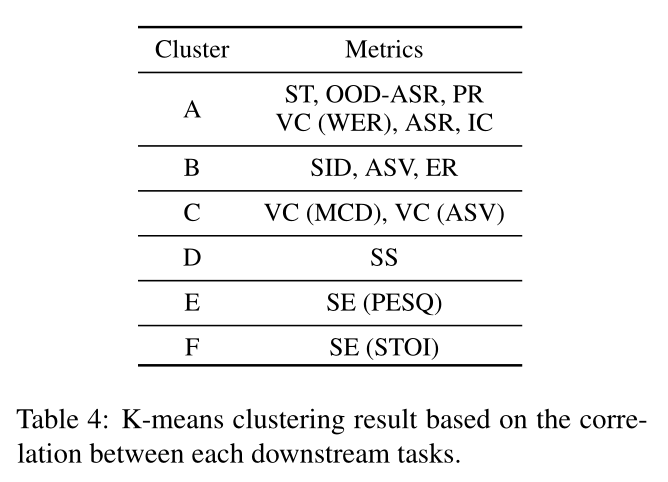
结果显示,任务的聚类与我们的经验知识一致。聚类A包括需要内容信息的任务,而聚类B的任务对说话人和语调特征更敏感。C组包含VC的MCD和ASV指标,它们被用来评估信号质量和说话人的转移率。值得注意的是,VC的WER属于集群A,表明它与内容相关的任务更相似。此外,聚类D、E和F分别包含SS和SE中的一个指标,这与我们的假设一致,即这些任务与其他任务相比利用不同类型的信息。
通过对任务之间相关性的分析,我们从经验上证实了结果的可靠性,并表明我们比SUPERB增加了语音任务之间的异质性。我们进一步用聚类的方法发现了任务之间的共同属性,结果与我们对相关任务的常识理解是一致的。
5.3 Robustness of SUPERB-SG
5.3.1 Downstream model
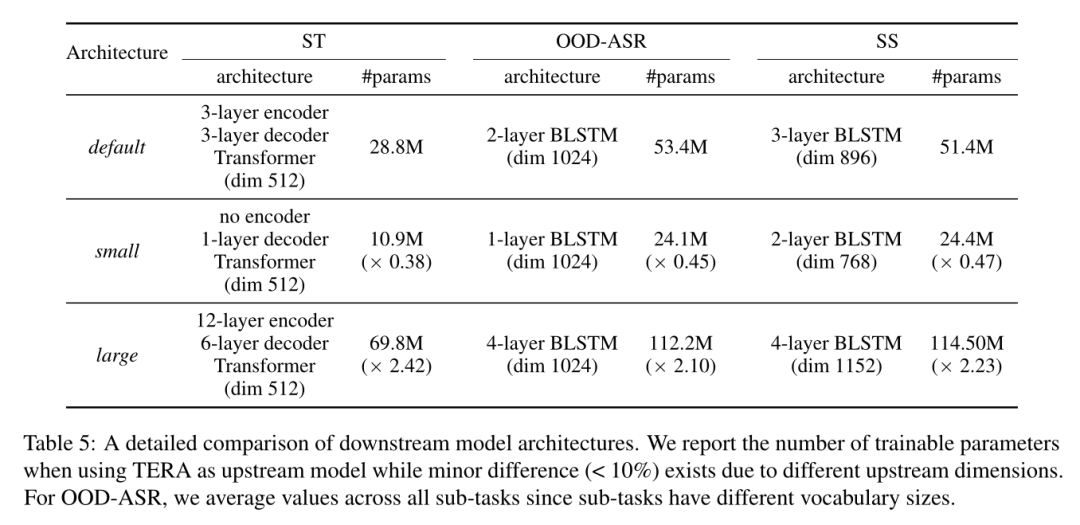
对于每个任务,我们通过修改层数和隐藏维度的方式创建了两个额外的下游架构。与我们的默认设置相比,我们创建的small模型和large模型在可训练参数的数量上大约是默认值的一半和两倍。下游架构的详细比较见表5。结果显示在表6中。
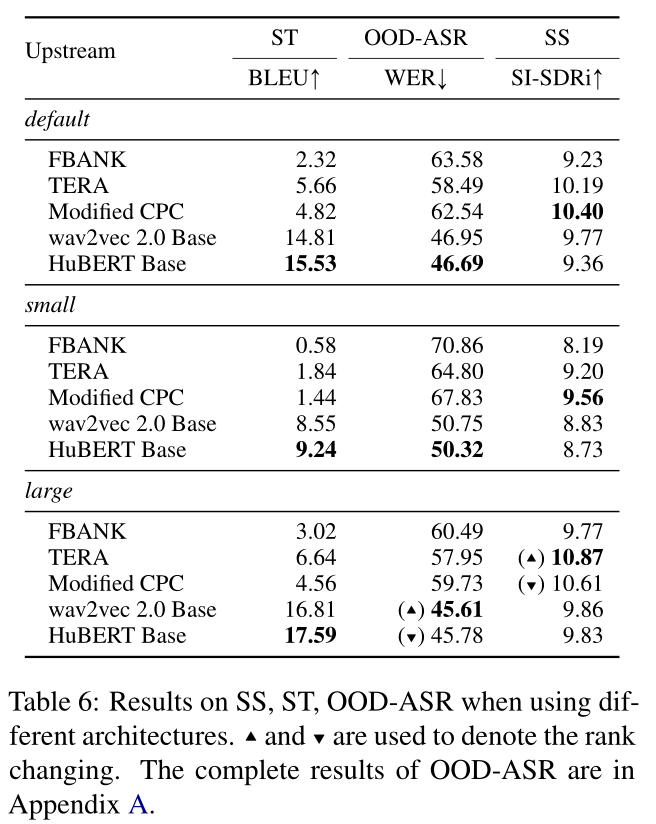
从表中可以看出,当模型大小不同时,上游模型的排名几乎是固定的。与预期相同,小型架构的性能比默认的差,而大型的则更好。此外,导致排名变化的分数可以忽略不计,例如,large架构下SS中的TERA/CPC和OOD-ASR中的wav2vec 2.0 Base/HuBERT Base。结果表明,不同的上游模型所取得的相对性能与下游架构无关,证实了SUPERB-SG中使用的框架的稳健性。
5.3.2 Training data size
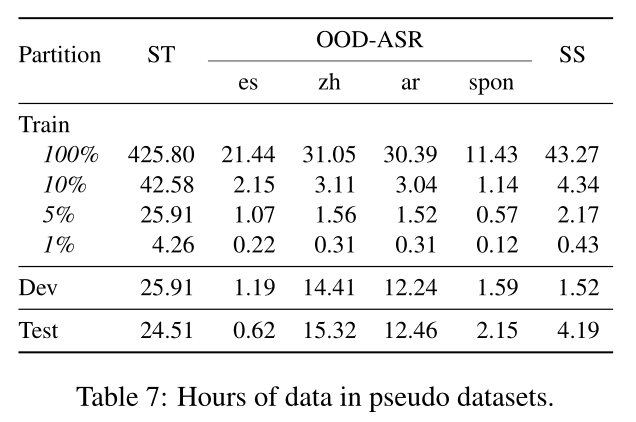
为了研究数据规模的影响,我们在固定验证集和测试集的同时,为每个任务创建3个伪数据集,其大小分别为原始训练集的10%、5%和1%。数据集的统计数据见表7,结果见表8。
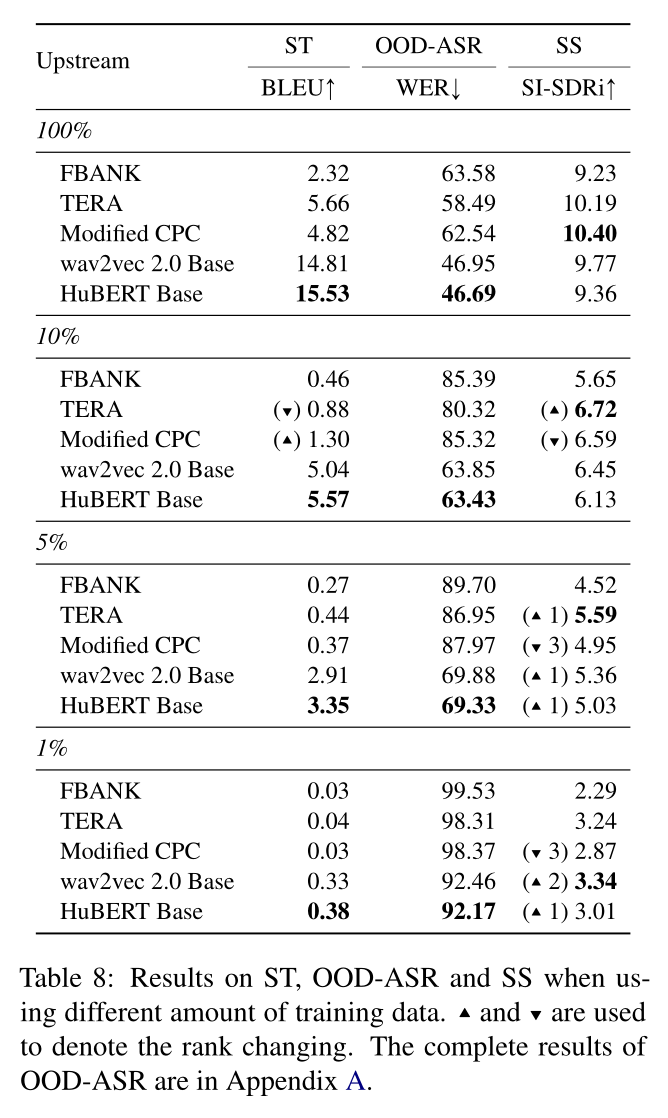
在10%的训练数据下,上游模型的排名几乎保持不变。当进一步减少到5%时,由于Modified CPC的性能下降,SS的排名发生了变化。如果不包括Modified CPC,排名仍然是固定的,这表明上游模型的相对性能与数据大小是无关的。此外,当只使用1%的训练数据时,大多数SSL模型在3个下游任务表现不如基线。这种现象是由有限的训练数据规模导致的特定任务知识获取不足造成的。尽管SSL模型从无标签的语音信号中学习了高水平的表征,但获得特定任务的知识,如ST中的翻译能力、OOD-ASR中的文本级标记映射和SS中的掩码预测,仍然需要非实质性的监督。
6 Conclusion
论文翻译:内蒙古大学计算机学院2022级硕士研究生马泽宁(导师 刘瑞)
