
 语音小管家
12月15日-18日,第十七届全国人机语音通讯学术会议(NCMMSC 2022)在线上举行。作为我国人机语音通讯领域权威性会议之一,NCMMSC 2022也为国内语音领域广大专家、学者和科研工作者提供了最新研究成果的交流平台。
本次会议经过前期论文征稿和专家审稿,共有123篇论文被会议录取。科大讯飞研究院此次入选论文14篇,涵盖语音合成、语音识别、情感识别、说话人确认、声音事件定位和检测等多个方面,展现了讯飞在语音领域深厚的技术底蕴和持续创新能力。
以下为讯飞研究院入选论文的亮点集锦:
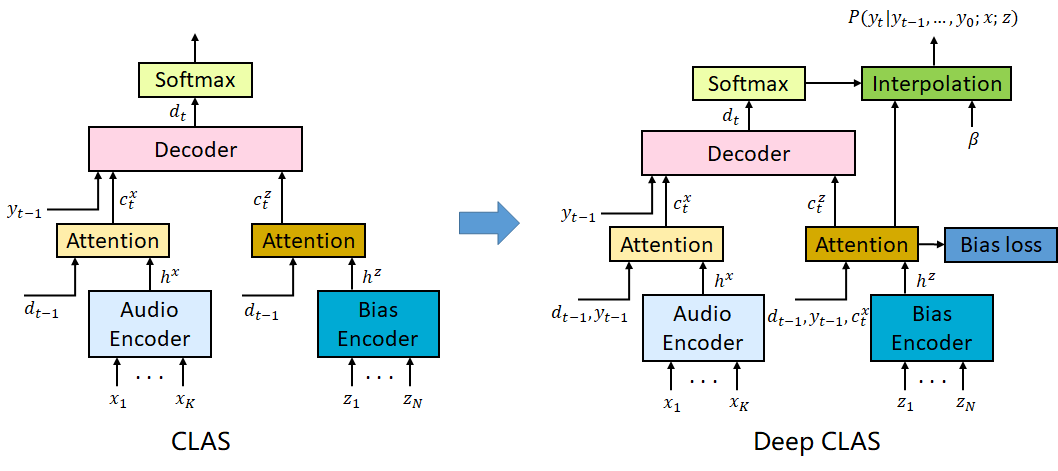
端到端语音识别模型大幅提高了语音识别的准确率,但作为数据驱动的深度学习模型,其在命名实体等稀疏词的识别上仍然表现不佳。而近年来,基于语境信息的端到端语音识别热词方案CLAS通过在训练时提取偏置信息输入模型联合优化、测试时将稀疏词作为偏置信息辅助识别,一定程度上提高了端到端模型稀疏词的识别效果,但整体效果仍难达到工业界推广应用的程度。
为了进一步改善该场景的识别效果,科大讯飞研究院基于CLAS方案提出了结合深度语境的端到端语音识别框架。
首先,通过使用偏置损失强制模型关注偏置信息,解决了CLAS对偏置信息缺乏有效监督的问题;其次,将声学上下文加入偏置attention的查询向量,结合细粒度的偏置信息建模方式以及更强大的偏置编码器,提高偏置分数的准确率;然后,将偏置分数与模型输出加权结合,解决CLAS对偏置信息利用不充分的问题;最后,结合前缀树对无关偏置信息进行过滤,进一步提升长词的偏置效果。
论文2:一种融合激励和颤音建模的端到端歌唱合成方法
An E2E singing voice synthesis method with excitation and vibrato modeling
歌声合成是一种从乐谱中生成歌声的技术,旨在让机器像人类一样可以有感情的歌唱,它在娱乐交互中具有很多应用,例如创建虚拟歌手等。
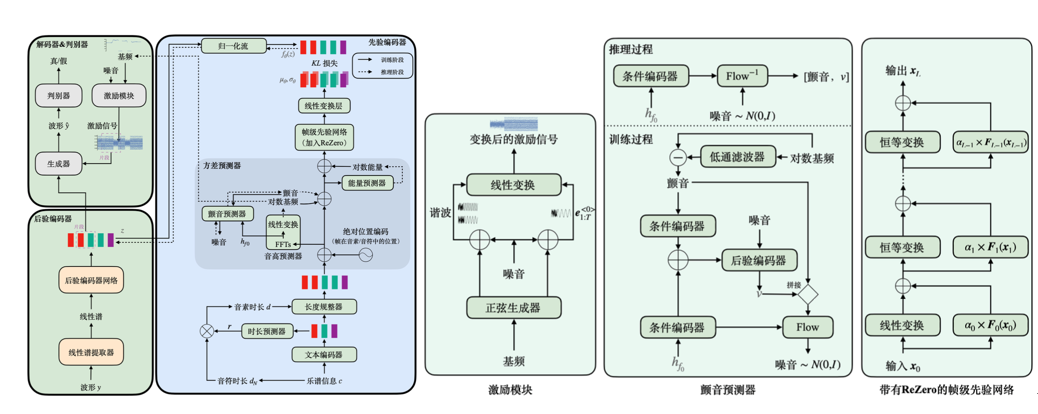
它可以看作是文本到语音技术在音乐中的扩展,也就是不仅需要体现以文本出现的歌词,还需要体现歌曲的旋律和情感。大部分歌声合成方案基于声学模型和声码器的两阶段模型,最近一种基于一体化模型的方案被提出用于歌唱合成,它使用变分自编码器将声学模型和声码器合并到统一的框架中,并展示了相对于两阶段模型的巨大优势。然而该方法合成的歌唱依然存在基频不连续、颤音合成不自然以及发音不稳定的问题。
为解决上述问题,讯飞研究院提出了一系列改进方法:一、针对基频稳定性问题,提出在解码器中增加激励模块,将基频信息以激励信号的形式显式提供给解码器;二、针对颤音合成不自然问题,增加颤音预测模块,通过流式模型和变分数据增强,显式对歌声中的颤音进行建模;三、进一步在先验网络中增加一定策略以辅助模型的训练。
论文3:融合专家知识和模型的多音字消歧方法
字音转换是语音合成系统中的主要模块之一,在中文合成系统中,多音字消歧是字音转换的难点。当前主流多音字消歧方法依赖数据驱动进行模型训练,缺少对词典等专家知识的利用。
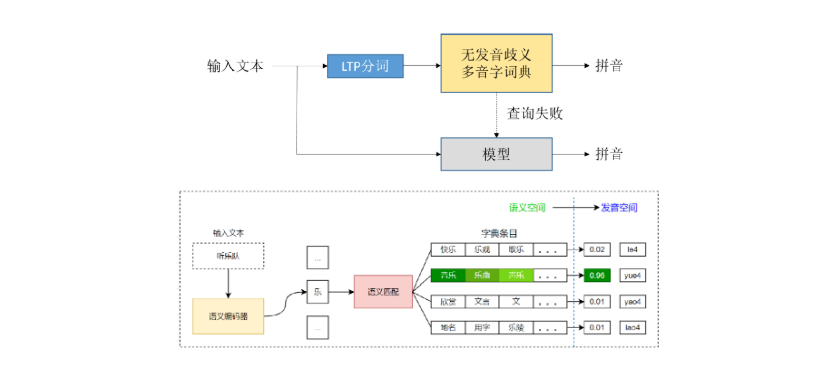
为解决上述问题,讯飞研究院提出一种融合专家知识和模型的多音字消歧方法,设计了两种融合专家知识的策略。
一、通过语义匹配将字典信息融入多音字消歧模型,具体地,通过BERT提取字典中多音字的不同释义的语义表征,将待消歧文本的语义和多音字的字典释义语义表征进行匹配,通过语义匹配相似度确定多音字的释义,利用字典中释义和发音对应关系确定其发音。
二、针对部分多音字在词中的发音无歧义的特性,构建一种无歧义多音字词典,在多音字消歧过程中,结合分词信息和无歧义词典确定多音字的发音。
论文4:一种结合语法信息的语音识别系统
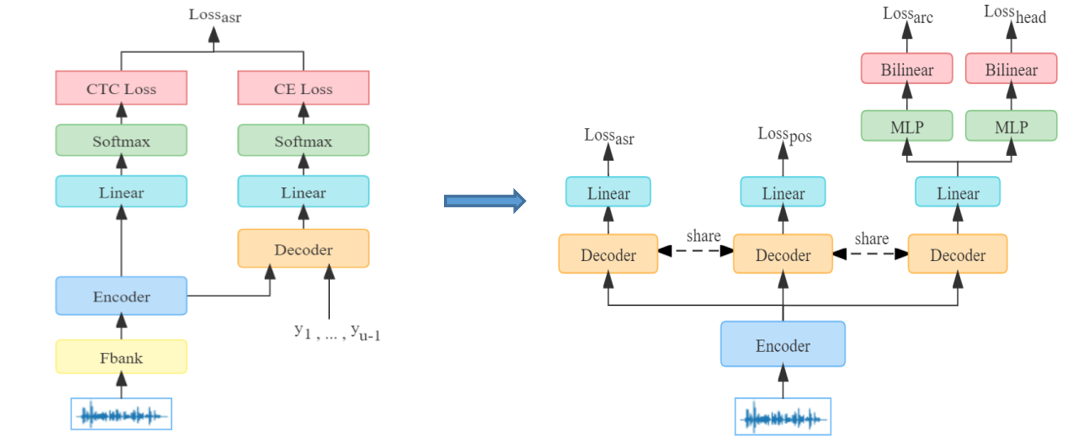
近年来,随着语音识别方案的不断突破,语音输入、语音交互等语音识别相关产品已经在客服、车载、医疗、教育等行业中日臻成熟并得到广泛应用。虽然语音识别的效果指标不断攀升,但是在实际使用过程中,由于应用场景的复杂性,语音识别结果仍然存在一些不可接受错误,大大影响用户的交互体验。
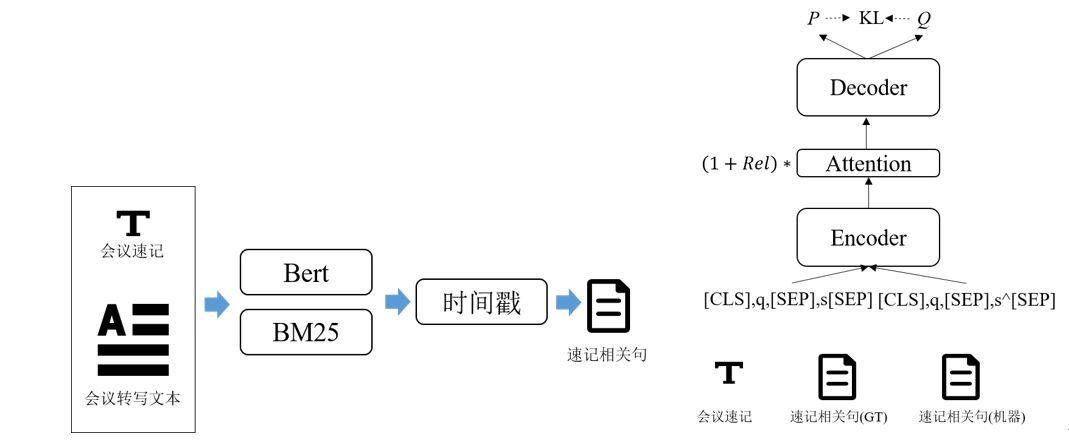
编写会议纪要已成为日常办公必不可少的工作环节,基于文本摘要生成技术的会议纪要方案目前已经在会议场景中使用。但是,由于会议文本篇幅较长、议题较多,容易出现生成的纪要信息不全、文本内容偏离用户关注重点等问题,用户整体体验较差。
为了解决上述问题,讯飞研究院结合参会人员在会议中简要记录的会议重点等先验信息,提出了一种基于速记信息辅助用户高效整理会议纪要的系统。
该系统首先通过语义模糊检索模型,在会议转写文本中检索出与速记相关的原文片段,并通过级联摘要生成模型,将速记及其检索文本片段转换为详细完整的书面化风格文本作为会议纪要。
摘要生成模型使用检索模型输出的语义相似度作为Decoder文本生成的激励,减少对低质量检索文本的关注,同时采用KL loss,约束Ground True检索文本与模型检索文本生成摘要的一致性,降低模型输出的错误检索片段对摘要生成的影响。
Speech Emotion Recognition with Multi-task Learning
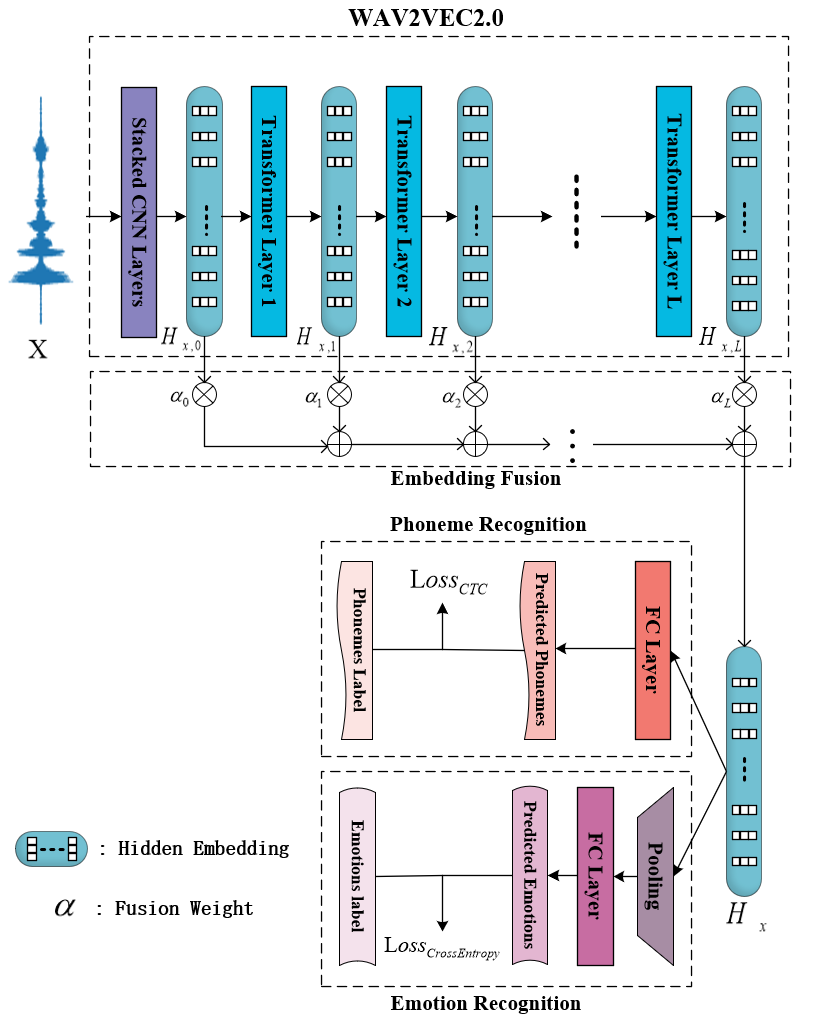
在近期的语音情感识别研究中,研究人员尝试利用深度学习模型从语音信号中识别情感。然而,传统基于单任务学习的模型对语音的声学情感信息关注度不足,导致情感识别的准确率较低。
鉴于此,本文提出了一种基于多任务学习、端到端的语音情感识别网络,以挖掘语音中的声学情感,提升情感识别的准确率。为避免采用频域特征造成的信息损失,本文利用基于时域信号的WAV2VEC2.0自监督网络作为模型的主干网络,提取语音的声学特征和语义特征,并利用注意力机制将两类特征进行融合作为自监督特征。为了充分利用语音中的声学情感信息,使用与情感有关的音素识别作为辅助任务,通过多任务学习挖掘自监督特征中的声学情感。
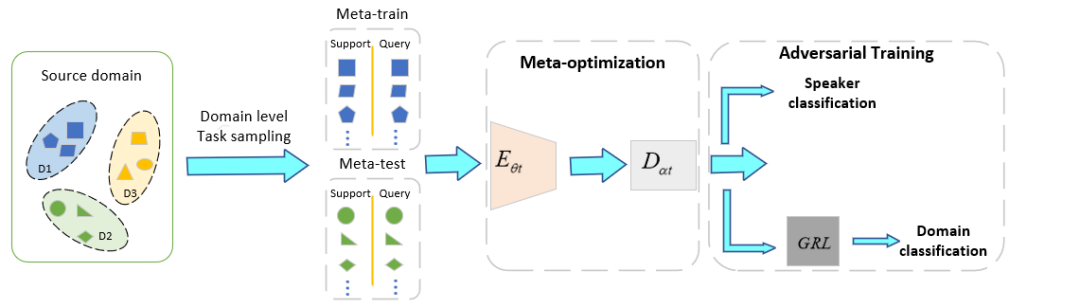
深度嵌入学习(Deep Embedding Learning)是说话人确认(Speaker Verification)研究的主流方法,现实应用中由于复杂且不可控的声学环境和说话风格引起的域偏移会对系统性能带来巨大考验。现有说话人确认系统,在面对场景噪声或者说话风格不可知的情景时,泛化性能表现不佳。
为了解决上述问题,我们提出了基于元学习的对抗训练方法。我们的模型包括一个主干网络和一个额外的域注意力模块,元学习的训练策略,可以提高说话人嵌入空间的泛化能力,在保证说话人正确分类的同时,我们加入了一个域的对抗分类支路,提高模型的域的鲁棒性。
Convolution is all you need for voice activity detection in real production environment
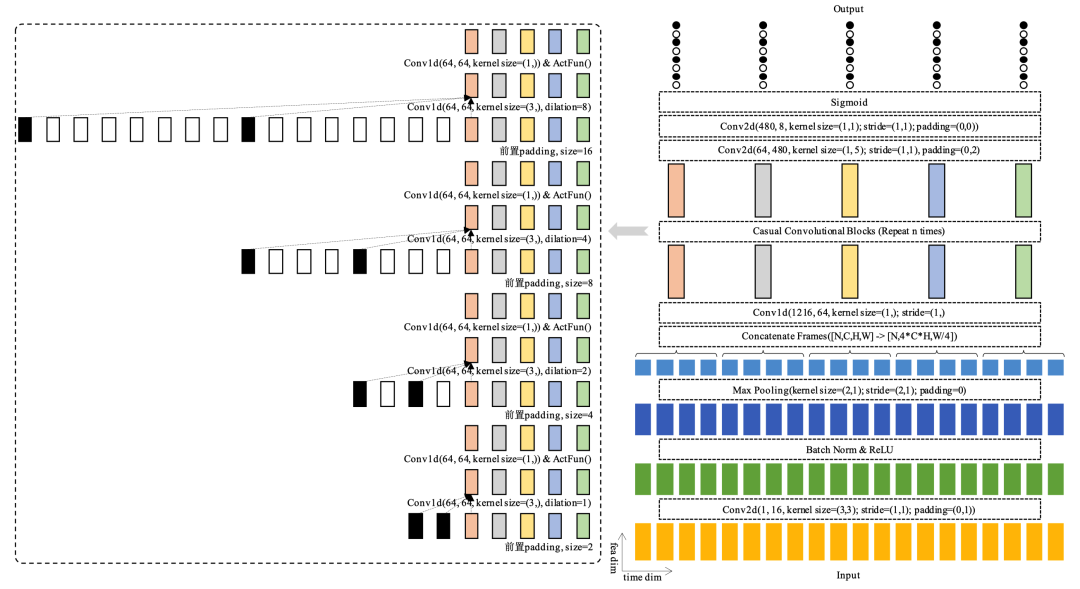
语音活性检测(Voice Activity Detection,VAD)是众多语音相关下游任务的前置步骤,VAD任务由于其应用的特点通常要求采用较小的模型、较快的速度同时达到较高的分类准确率,因此讯飞研究院提出了一种基于扩张因果卷积的全卷积语音活性检测(Full-Conv VAD)算法。
为了能够直接复用声学模型的巨量训练数据,节约人工标注成本,本文采用强制对齐的方式得到 VAD 帧级别标注数据,强制对齐通常会导致右端点漂移问题,进而影响模型总体时延,团队又引入推帧训练(push frame)策略显著改善尾端点漂移带来的时延问题。
在计算开销上通过扩张因果代替LSTM 进行时序建模约降低 45%的计算开销,同时采用两步降采样-池化和拼帧的方式减小特帧图来进一步降低计算开销。在检测准确率上通过消融分析得到一组平衡时延、计算开销和准确率的最优选择。
论文9: 面向真实环境音频事件检测和定位的后处理策略
Post-Processing Strategies for Sound Event Detection and Localization Under Realistic Conditions
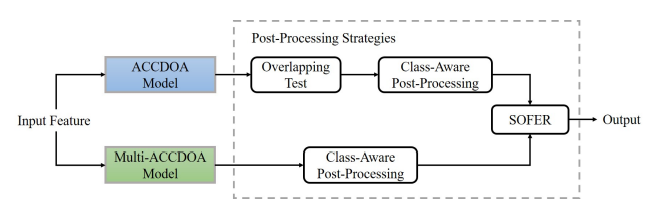
声音事件定位和检测(SELD)旨在检测发生事件的类型并估计它们的位置。最近,随着基于深度学习的方法的兴起,SELD的性能有了很大的提高。然而,现有的研究大多集中在模拟数据集上。
本文探讨了在真实复杂的声学场景下面向SELD任务的后处理策略。首先,利用ACCDOA方法的保守边界估计和multi-ACCDOA的高上限,我们提出了一种SELD输出融合误差减小方法(SOFER)。其次,我们采用了重叠测试方法来减少测试时的方差。最后,利用类相关的后处理进行精确调整。这些后处理方法为我们在DCASE 2022 SELD任务上夺冠做出了贡献。
论文10:关于真实家居场景下的音视频语音识别的研究
An Investigation for Audio-Visual Speech Recognition Under Realistic Home-TV Scenario
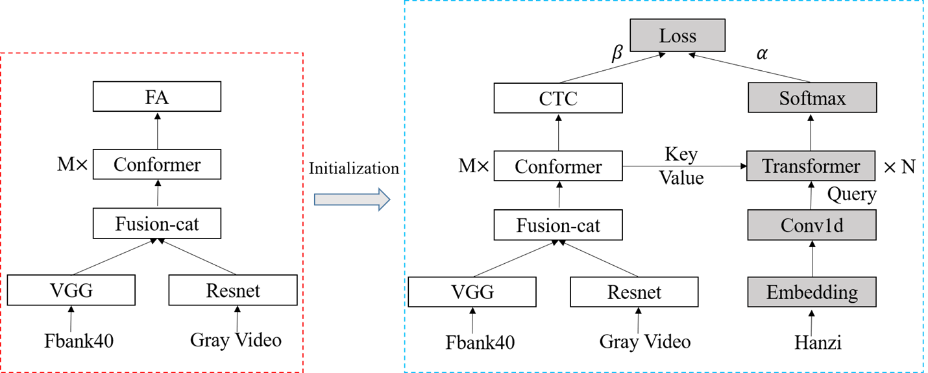
基于hybrid系统的初始化方法
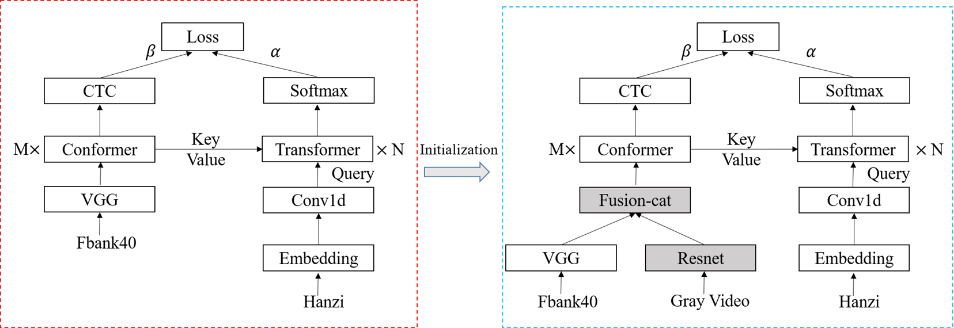
基于端到端系统的初始化方法
近些年来,单音频的语音识别技术得到了广泛的应用,但是由于在进行语音识别时音频信号容易受到现实场景中很多因素的干扰,例如信道传输的损耗、环境噪声及混响,这会导致语音识别性能的下降。
因此,视频信号引起了人们的关注,通过引入视频的信息,可以使得语音信号的识别效果更加鲁棒。然而,相比于音频数据来说,音视频数据更难以获得,这使得音视频很难像音频那样寻找到一个大规模的训练数据集。这导致在训练一些参数量比较大的音视频模型,例如基于端到端框架的模型时,模型倾向于过拟合。
因此,团队针对这个问题探索了一些可以缓解过拟合问题的初始化方法,同时也对音视频语音识别任务中的其他因素,包括模型结构和音视频融合方法做了初步的探索。团队最终在第一届MISP挑战赛测试集上实现了23.98%的字符错误率(CER),优于第一届MISP挑战赛的冠军系统。
论文11:一种对通道剪枝改进的结构化剪枝方法用于设计紧致音视频唤醒词识别系统
An Improved Structured Pruning Approach to Channel-level Pruning for Designing Compact Audio-Visual Wake Word Spotting System
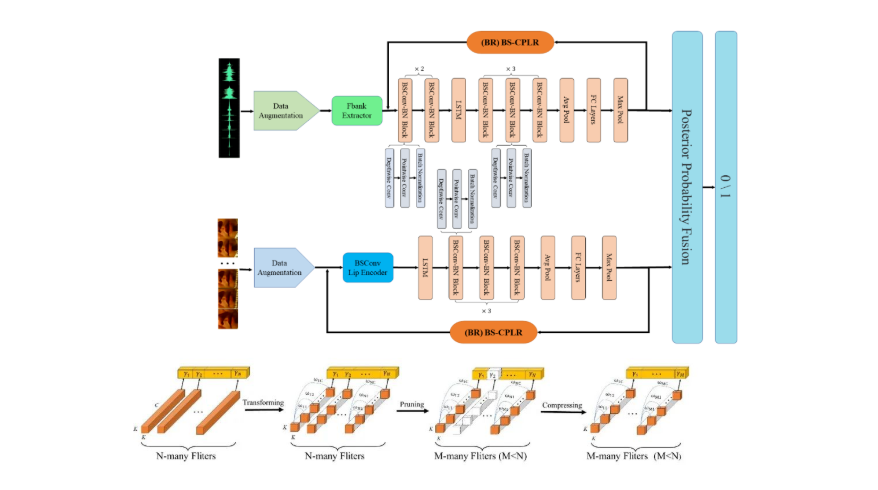
唤醒词识别(Wake word spotting,WWS)任务的目标是让机器识别用户说出的特定唤醒词,从而激活智能设备,进而实现特定功能。受制于噪声环境和信号空间传输损失的影响,WWS任务在高噪环境及远场条件下还存在着不小的挑战。引入视频模态的信息可以辅助单音频WWS系统,但是视频网络的引入会显著增大网络的参数量,导致网络难以部署到小型低功耗设备上,本文能为解决这个问题提供一个很好的解决思路。
为此,本文提出了一种新颖的神经网络压缩方法,该方法融合了通道剪枝、蓝图卷积和彩票假说三种策略,称为“蓝图卷积化学习率回退式通道剪枝(BS-CPLR)”。该策略首先使用蓝图卷积替代原来网络中的卷积核,然后对网络进行预训练,将网络中批归一化层的缩放因子作为通道重要性的衡量标准,再根据缩放因子实施通道剪枝。将预训练-剪枝步骤重复若干轮并使用彩票假说策略中的学习率回退策略进行指导,最终得到最紧致的网络结构。
论文12:一种有效语音情感识别的时频注意力辅助信息机制
A Time-Frequency Attention Mechanism with Subsidiary Information for Effective Speech Emotion Recognition
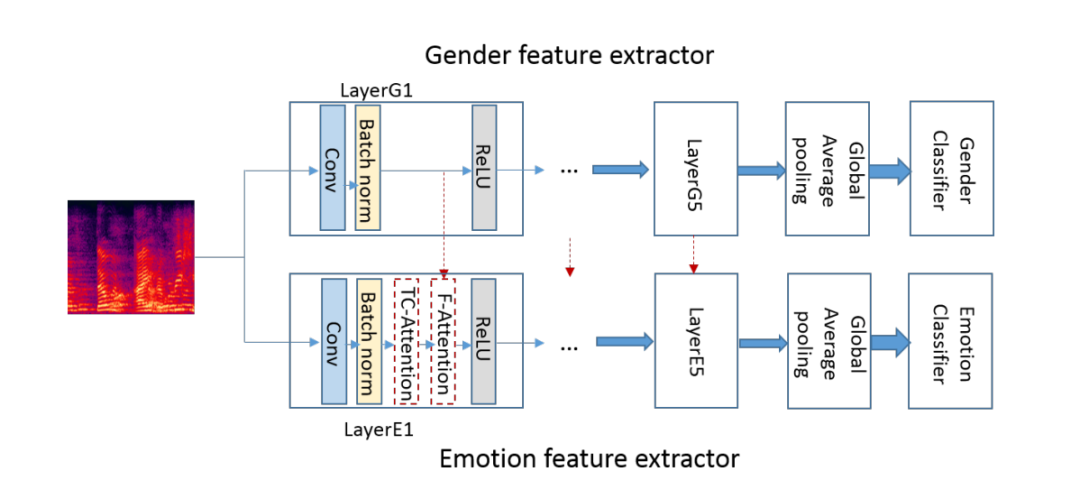
情感识别通过对发出话音分析确定此刻的人类情感。随着人机交互如智能服务机器人、客服中心等广泛的应用,情感识别也有着越来越重要的作用。语音情感信息作为一种心理上自然产生的弱信息,往往会被声纹、语音内容、语种等强信息所干扰而难以准确提取,该任务仍面临着诸多挑战。
已有研究利用文本耦合语音信息的方式提升情感识别的准确性,一些领域适应和多任务学习方法利用多个语料库的情感数据去解决数据稀缺问题,但是领域特定信息的消除也会让部分情感信息不可避免的丢失。
为了可以充分利用辅助信息,同时尽可能保留情感信息,本文提出了一种性别和情感多任务学习网络结构。第一个分支网络作为情感特征提取器,另一个网络作为性别特征提取器。在情感分支网络中,对于时频维度采用两种注意力机制获取权重:在时间和信道维度,对当前特征的关注与该位置的内容有关,因此,利用特征本身来计算注意力权重,得到自注意力模块;在频率维度,当前特征哪些频率被关注与语音中声纹信息有关联,因此,使用性别信息来计算注意力权重,得到联合注意力模块。
论文13:多策略融合的高鲁棒性事件检测
Highly Robust Event Detection Based on Multi Strategy Fusion
事件检测(Event Detection)任务旨在从给定文本中识别事件触发词(trigger)并将其分类到正确的事件类型,触发词是标记事件出现的核心短语,事件类型为数据集中预先定义的类型。事件检测能从非结构化信息中抽取出用户感兴趣的事件,并以结构化呈现给用户,方便各场景下信息分析工作,从广义上看,其在语音、文本、图像、视频等领域都被广泛应用。
事件检测方法有很多,随着深度学习的不断发展,基于预训练模型的事件检测成为了主流方法。虽然基于深度神经网络的模型在事件检测问题上取得了较好的效果,但已知的深度学习方法对训练数据有着高质量要求,在存在数据样本分布不均衡、数据标注质量欠佳、对抗数据污染等问题时,模型有效性往往难以得到保证,缺乏鲁棒性。
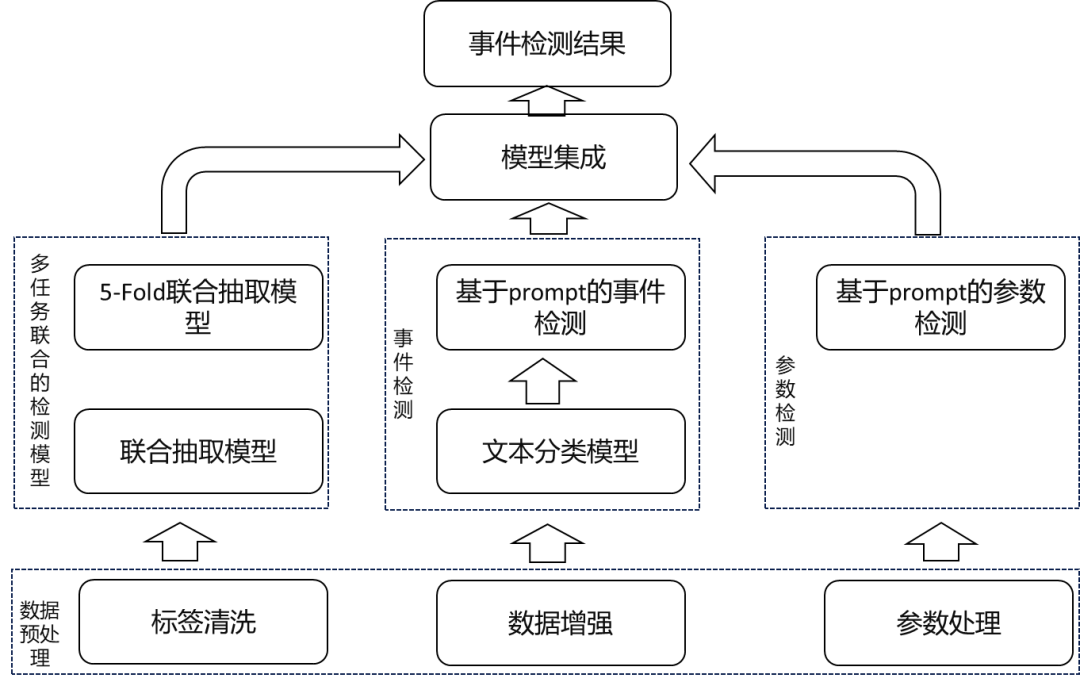
为了更好解决数据质量较差的场景下的事件检测问题,本文针对句子级文本,提出了一种多策略融合的高鲁棒性事件检测方法。该方法主要包括数据预处理、多任务联合事件检测、基于分类引导的prompt事件检测、基于prompt的参数检测以及模型集成五个模块。
数据预处理包括数据清洗、数据增强等过程,初步矫正数据标签错误以及数据不平衡的问题;基于分类引导的prompt事件检测模型在低样本资源下也能实现准确抽取;多任务联合检测模型是将事件检测与事件参数抽取进行联合训练,利用参数信息提高事件检测的准确率;参数检测模型是针对事件中唯一参数构建抽取模型,为事件检测模型集成提供修正策略;模型集成则是按照一定的权重将三个模型的结果进行融合,同时添加参数检测模型的限制,最后输出最优结果。
论文14:基于预测自编码的无监督上下文感知异常声音检测
Predictive AutoEncoders are Context-Aware Unsupervised Anomalous Sound Detectors
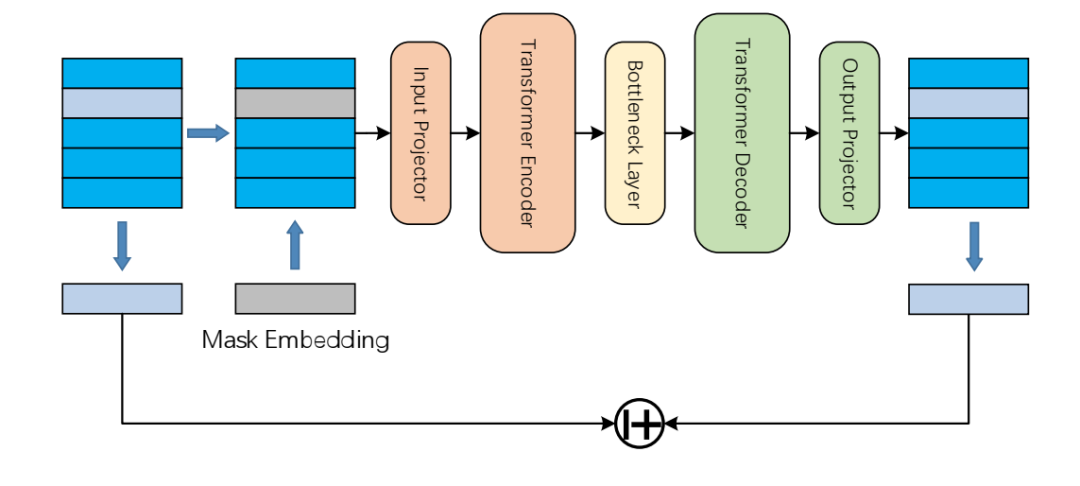
异常声音检测 (ASD)是一种声学相关任务,用于检测从给定机器发出的声音片段是否异常。近年来,由于异常声音检测技术可以广泛应用于工业机械的自动监控,受到越来越多的关注。然而,异常事件的种类繁多但发生频率稀少,导致收集足够的异常声音数据的成本很高。通常来说,仅仅只有正常声音数据可以用来训练异常检测模型,这也是异常声音检测富有挑战性的原因之一。
已有的研究主要可以分成判别类方法和生成类方法,判别类方法仅适用于一些数据没有机器ID标签的异常检测任务,而尽管基于自编码的生成方法对无监督声音事件检测是通用的,但由于深度神经网络的限制,破坏了帧之间的联系。此外,这些方法限制了输入的长度,使得建模长时输入的能力不足。时间关联性已被证明对各种声学任务有效,因此,在声音事件检测中应合理利用帧之间的关系。
相比以往的方法,本文将Transformer结构引入到无监督异常声音检测中,并提出了预测自编码器(Predictive AutoEncoder)作为上下文感知检测器。基于Transformer模块,本文方法利用上下文和内容信息来检测异常声音,通过自注意机制有效地学习更多的上下文信息。通过上下文信息和内容信息的结合,预测自编码器的效果显著优于其他基于自编码器的方法。
