
 语音小管家
文本来自我的个人博客:MikeCaptain - 麦克船长的技术、产品与商业博客,梳理了自己在春节期间对 NLP 基础模型的技术演变学习笔记记录,写就于大年初一在香港过春节时。本文包含 3 个章节:
第一章 · 2017 年之前的几个关键 NLP 语言模型:讲到 N 元文法、MLP、CNN、RNN、Attention. 第二章 · 2017 年横空出世的 Transformer 模型 第三章 · 解读一个基于 TensorFlow 架构的 Transformer 实现源码
春节期间,除了本文,我还梳理了一篇关于「大型语言模型(LLM)在 Transformer 之后的演化综述」和一篇关于「LLM 引领生产力革命,带来的未来几年科技脉搏把控」,但没有时间整理排版,待日后有空再归拢后发出,这些权当是在春节期间消磨时间的技术爱好,因为是偏向学习的技术笔记,所以非常欢迎大家批评、指正、交流。
作者:麦克船长 邮箱:zhongchao.ustc#gmail.com (#->@)
前言
本文试图从技术角度搞清楚一个问题:过去一年 AIGC 爆火、过去五年 NLP(自然语言处理)领域突飞猛进的缘起是什么?
这个问题被解答后,将还有两个问题,但暂时本文没有作答:1)如果认为通过图灵测试代表着 AGI(Artificial General Intelligence,通用人工智能)的话,当下 NLP,乃至 AGI 发展到什么程度了?2)未来一些年内,AGI 的发展路线可能会是怎样的?
利用春节时间,写了这么一篇数万字的长文笔记,希望共同爱好的朋友能读完多多指正。我是船涨,网名一直用「麦克船长」,中科大计算机本科毕业后先是做的 RTC 技术、分布式系统等等,干过 Full Stack,后来创业在技术、产品、运营、营销、供应链等等方面折腾了些年之后来到阿里,在淘系做过产品、运营,现在负责大聚划算运营中心。
1、我来阿里之后第一个新增爱好是「变形金刚模型」,第二个新增爱好是「变形金刚模型」
写了个这么冷的梗,其实想说的是,前者指的是著名 IP「变形金刚」相关的手办玩具模型,后者指的是这个引领革命的人工智能语言模型 Transformer。这两个爱好,都与目前从事的电商工作本职没有表面上的直接联系,权当爱好了。
2022 年「生成式 AI」应用取得了突飞猛进的发展,作为一个「古典互联网」从业者,深切地感到这一次 AI 技术可能会带来的颠覆式变革,这让我兴奋又焦虑。2022 年上半年,我从天天特卖业务负责人到大聚划算运营中心负责人,在去年相当长一段时间里在关注直播带货在营销平台的模式命题,一直在思考一个问题:直播电商的高效(更适合的商品演绎方式 + 私域权益 + 冲动购买等」vs. 直播电商的低效(直播分发无人货匹配 + 直播间内千人一面 + 货品状态未知 + 主播不可控等),能否推动一个保留直播的高效,同时解决直播的低效的模式呢?
这里面有大量的内容值得探讨,不过这不是船涨该系列文章的初衷,但这是我为什么开始非常关注 AI 的引子。直播电商的数字人技术基础,有动作捕捉、面部表情模拟、视觉渲染、直播话术生成、语音合成等等。依据第一性原理抽丝剥茧后,我发现尽管动作捕捉、视觉渲染等等很多技术仍有很大挑战,但是从商业视角看真正最影响用户心智的,是直播话术生成和演绎,除了头部主播,绝大多数直播带货在这方面都做的很糟糕,那么这里面就有巨大的「机器学习」生成内容超越非头部的大多数从业者的市场空间,而这完全依赖自然语言处理(NLP)。
这个问题就属于「生成式 AI」的范畴了,国外科技圈叫它「Gen-AI」,即 Generative AI,中国科技圈都叫它「AIGC」,即 AI Generated Content,与 UGC、PGC 相对应。Gen-AI 的叫法更关注主体,具体地说是「生成式 AI 模型」,它是个「内容引擎」。而中国的叫法更关注「内容应用」。
讲到 AIGC 这里,大家熟悉的 ChatGPT 就在 2022 年年底登场了。也是因为 ChatGPT 的破圈,带来了 AIGC 在国内科技圈的关注度暴涨。我从去年年中开始关注「文生图,text2image」领域的明星 Stable Diffusion 开源,进而关注到了 text2image 应用的爆发,包括 Disco Diffusion、MidJourney、DALL·E 2 等等,这些都源于 CV(计算机视觉)领域因为 Diffusion 模型发展带来的技术突破。
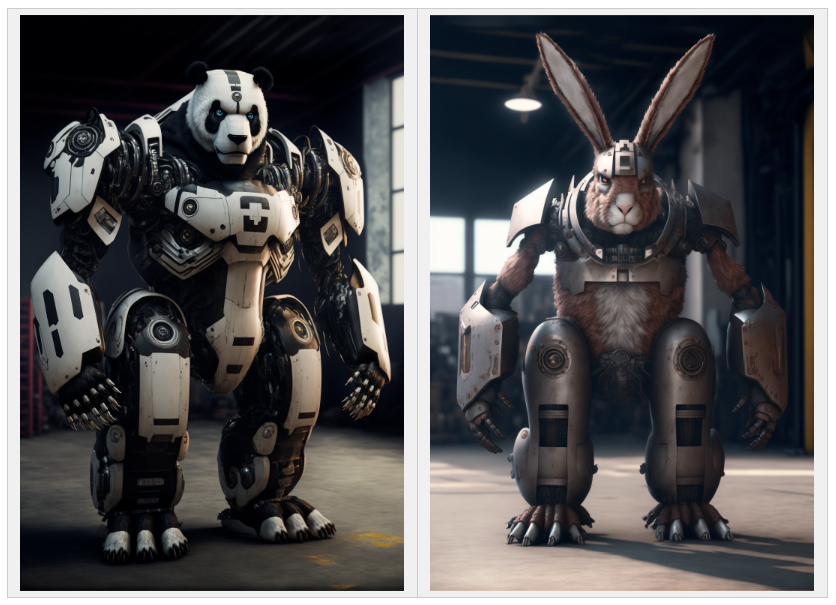
AI 生成图片确实非常惊人。我酷爱变形金刚模玩,进而对机甲类都非常喜欢,所以随手生成了几张图,这里贴一下大家看看,分钟级的创作速度。(注意:当下 AI 生成图片主要是基于 Diffusion 的应用发展,AI 生成文本的核心驱动才是 Transformer 模型,此处只是展示)
但是从第一性原理角度讲,生成图片的应用广度,远远小于生成文本。文本内容的本质是语言文字的理解与生成,人类历史有 600 万年,但是人类文明历史大概就 6000 年,文明的大发展出现在近 2000 多年的原因,主要来自 3500 多年前人类发明了文字。所以 AI 生成文本,意味着 AI 可以用人类熟悉的方式(语言文字)与人类高效协作,这必将引爆生产力革命。而这必将深入影响电商、内容、游戏、云计算、企业服务等众多领域。
2、掌握技术基础,是当下读懂 AI 脉搏的基本功,而这个脉搏将带动各行各业
一旦深入关注 AI、关注 NLP 领域,你就会发现当下仍然处于一个技术发展突破的阶段,不关注技术的情况下来聊 AI、聊 NLP、聊 AIGC,那就只能是一个「爱好者」,而无法深入与这个行业内的弄潮儿对话,更不要提参与其中了。所以这个春节,船涨回归了当年做技术时的初心,翻了一些材料,学习了 NLP 语言模型的关键技术,在此作为技术学习笔记,与大家分享。尽管担心班门弄斧,但是本着费曼老师提倡的输出学习法,我把自己学习梳理的内容抛出来,除了会更帮助到我自己,也能结交一些对此同样在关注的同学们,欢迎感兴趣的同学加我的微信(微信号 sinosuperman)在业余时间和我交流。
本文将包括这几部分:
第一章,主要介绍 Transformer 出现之前的几个主流语言模型,包括 N 元文法(n-gram)、多层感知器(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)。其中 CNN 主要应用领域在计算机视觉,因此没有更详细展开。其他模型也未面面俱到,主要考虑还是一个领域学习者的角度来了解和应用,而非研究。 第二章,是本文的核心,先介绍了注意力机制(Attention Mechanism),然后基于第一章对此前几大语言模型了解后,我们能更好地理解 Transformer 为什么会带来革命性的影响。 第三章,是一个 Transformer 的实现版本,基于 Tensorflow。
阅读本文,先对你过往的基础知识做了一些假设,如果你暂未了解,可能在阅读时遇到以下内容做一些简单地查询即可:
Word Presentation:自然语言处理中的词表示法,主要涉及 embedding。 张量:需要一点基础,比如了解张量的形状、升降维度等。但不会涉及到复杂问题,对一阶张量(向量)、二阶张量(矩阵)的简单运算有数学基础即可。对三阶张量,大概能想象出其空间含义即可。语言模型里理解词之间的距离,是有其空间几何意义的。 技术框架:PyTorch 或 TensorFlow 框架。由于时间和篇幅关系,春节期间梳理这些时,对于框架基础,我主要是 Google 现用现查,询问 ChatGPT 以及在微信读书里直接搜索全文。
作为技术笔记难免有纰漏或理解错误,欢迎指正。文中自绘图片用的是 Graphviz,公式生成用的是 KaTeX,贴到公众账号后难免有一些没有兼容的部分(发现的已做了 fix),望见谅。
第一章 · 2017 年之前的几个关键 NLP 语言模型
NLP 的技术基础方面,我认为主要是这两部分:词表示法(Word Presentation)、语言模型(Language Model)。对于词表示法,这里不做详细介绍,基本的思路就是把词表示为向量(一维张量),最基本的 One-Hot、Word2Vec、GloVe、fastText 等。这部分的技术演进也在不断前进,比如本文将要重点介绍的 Transformer 模型里,用到的词表示法是「引入上下文感知的词向量」。
语言模型从早期的 N 元文法(N-Gram,本文要介绍的),到神经网络被提出后最早期的感知器(Perceptron),再到后来席卷计算机视觉(CV)领域的卷积神经网络(CNN),然后出现考虑序列特征的循环神经网络(RNN,包括 Encoder-Decoder 模型),直到 2017 年横空出世的 Transformer,大概分这五个主要阶段。因为本文的重点是 Transformer,所以前面四个模型我会快速概览一下,然后介绍下最朴素的注意力(Attention)机制,基于此再详细介绍下 Transformer,并对一个完整的、精炼实现的代码实例进行精讲。
第 1 节 · N 元文法语言模型
1.1、马尔科夫假设(Markov Assumption)与 N 元文法语言模型(N-gram Language Model)
下一个词出现的概率只依赖于它前面 n-1 个词,这种假设被称为「马尔科夫假设(Markov Assumption」。N 元文法,也称为 N-1 阶马尔科夫链。
一元文法(1-gram),unigram,零阶马尔科夫链,不依赖前面任何词; 二元文法(2-gram),bigram,一阶马尔科夫链,只依赖于前 1 个词; 三元文法(3-gram),trigram,二阶马尔科夫链,只依赖于前 2 个词; ……
通过前 t-1 个词预测时刻 t 出现某词的概率,用最大似然估计:
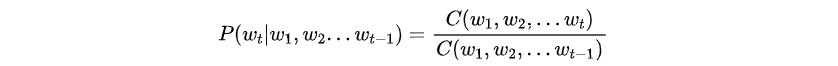
进一步地,一组词(也就是一个句子)出现的概率就是:
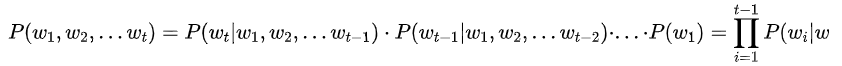
为了解决句头、尾逇概率计算问题,我们再引入两个标记 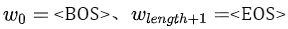 ,其中 length 是词的数量。
具体地,比如对于 bigram,该模型表示如下:
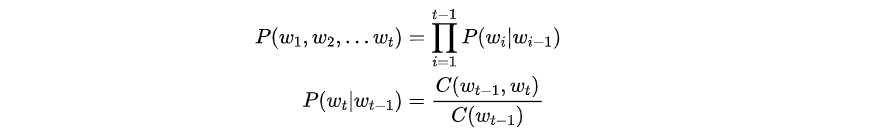
如果有词出现次数为了 0,这一串乘出来就是 0 了,咋办? 因为基于马尔科夫假设,所以 N 固定窗口取值,对长距离词依赖的情况会表现很差。 如果把 N 值取很大来解决长距离词依赖,则会导致严重的数据稀疏(零频太多了),参数规模也会急速爆炸(高维张量计算)。
上面的第一个问题,我们引入平滑 / 回退 / 差值等方法来解决,而后面两个问题则是在神经网络模型出现后才更好解决的。
1.2、平滑(Smoothing)/ 折扣(Discounting)
虽然限定了窗口 n 大小降低了词概率为 0 的可能性,但当 n-gram 的 n 比较大的时候会有的未登录词问题(Out Of Vocabulary,OOV)。另一方面,训练数据很可能也不是 100% 完备覆盖实际中可能遇到的词的。所以为了避免 0 概率出现,就有了让零平滑过渡为非零的补丁式技术出现。
最简单的平滑技术,就是折扣法(Discounting)。这是一个非常容易想到的办法,就是把整体 100% 的概率腾出一小部分来,给这些零频词(也常把低频词一起考虑)。常见的平滑方法有:加 1 平滑、加 K 平滑、Good-Turing 平滑、Katz 平滑等。
1.2.1、加 1 平滑 / 拉普拉斯平滑(Add-One Discounting / Laplace Smoothing)
加 1 平滑,就是直接将所有词汇的出现次数都 +1,不止针对零频词、低频词。如果继续拿 bigram 举例来说,模型就会变成:
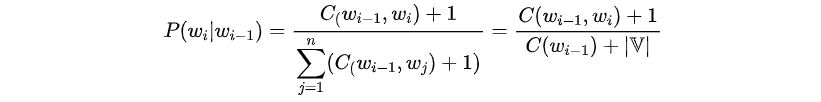
其中 表示所有词的词频之和,
 表示词汇表的大小。
如果当词汇表中的词,很多出现次数都很小,这样对每个词的词频都 +1,结果的偏差影响其实挺大的。换句话说,+1 对于低频词很多的场景,加的太多了,应该加一个更小的数( 1 < δ < 1)。所以有了下面的「δ 平滑」技术。
1.2.2、加 K 平滑 / δ 平滑(Add-K Discounting / Delta Smoothing)
把 +1 换成 δ,我们看下上面 bigram 模型应该变成上面样子:
{% raw %}
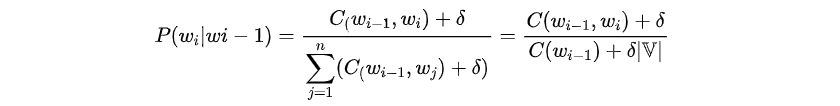
δ 是一个超参数,确定它的值需要用到困惑度(Perplexity,一般用缩写 PPL)。另外,有些文章里也会把这个方法叫做「加 K 平滑,Add-K Smoothing」。
1.2.3、困惑度(Perplexity)
对于指定的测试集,困惑度定义为测试集中每一个词概率的几何平均数的倒数,公式如下:
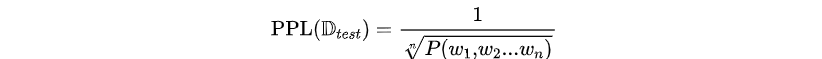
把 $ P(w_1,w_2,...w_t) = \displaystyle\prod_i=1}^{t-1}P(w_i) $ 带入上述公式,就得到了 PPL 的计算公式:
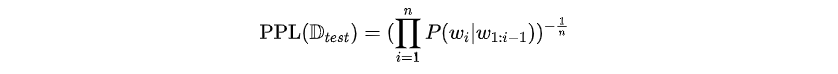
1.3、回退(Back-off)
在多元文法模型中,比如以 3-gram 为例,如果出现某些三元语法概率为零,则不使用零来表示概率,而回退到 2-gram,如下。
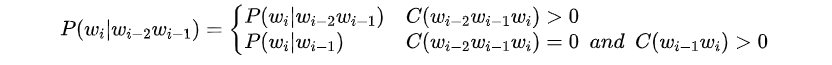
1.4、差值(Interpolation)
N 元文法模型如果用回退法,则只考虑了 n-gram 概率为 0 时回退为 n-1 gram,那么自然要问:n-gram 不为零时,是不是也可以按一定权重来考虑 n-1 gram?于是有了插值法。以 3-gram 为例,把 2-gram、1-gram 都考虑进来:
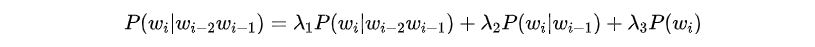
第 2 节 · 感知器(Perceptron)
N 元文法模型的显著问题,在「马尔科夫假设与 N 元文法语言模型」小节已经提到了。这些问题基本在神经网络模型中被解决,而要了解神经网络模型,就要从感知器(Perceptron)开始。1957 年感知机模型被提出,1959 年多层感知机(MLP)模型被提出。MLP 有时候也被称为 ANN,即 Artificial Neural Network,接下来我们来深入浅出地了解一下,并有一些动手的练习。
2.1、感知器(Perceptron):解决二元分类任务的前馈神经网络
x 是一个输入向量,w 是一个权重向量(对输入向量里的而每个值分配一个权重值所组成的向量)。举一个具体任务例子,比如如果这两个向量的内积超过某个值,则判断为 1,否则为 0,这其实就是一个分类任务。那么这个最终输出值可以如下表示:
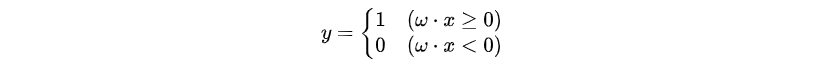
这就是一个典型的感知器(Perceptron),一般用来解决分类问题。还可以再增加一个偏差项(bias),如下:
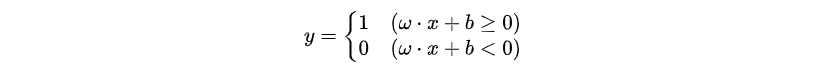
感知器其实就是一个前馈神经网络,由输入层、输出层组成,没有隐藏层。而且输出是一个二元函数,用于解决二元分类问题。
2.2、线性回归(Linear Regression):从离散值的感知器(解决类问题),到连续值的线性回归(解决回归问题)
一般来说,我们认为感知器的输出结果,是离散值。一般来说,我们认为离散值作为输出解决的问题,是分类问题;相应地,连续值解决的问题是回归(Regression)。比如对于上面的感知器,如果我们直接将 作为输出值,则就变成了一个线性回归问题的模型了。
下面我们用 PyTorch 来实现一个线性回归的代码示例,首先我们要了解在 PyTorch 库里有一个非常常用的函数:
nn.Linear(in_features, out_features)这个函数在创建时会自动初始化权值和偏置,并且可以通过调用它的forward函数来计算输入数据的线性变换。具体来说,当输入为x时,forward函数会计算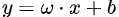 ,其中
 和
 分别是
nn.Linear图层的权值和偏置。
我们来一个完整的代码示例:
import torch
import torch.nn as nn

# 定义模型
class LinearRegression(nn.Module):
    def __init__(self, input_size, output_size):
        super(LinearRegression, self).__init__()
        self.linear = nn.Linear(input_size, output_size)

    def forward(self, x):
        return self.linear(x)

# 初始化模型
model = LinearRegression(input_size=1, output_size=1)

# 定义损失函数和优化器
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

# 创建输入特征 X 和标签 y
X = torch.Tensor([[1], [2], [3], [4]])
y = torch.Tensor([[2], [4], [6], [8]])

# 训练模型
for epoch in range(100):
    # 前向传播
    predictions = model(X)
    loss = criterion(predictions, y)

    # 反向传播
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

# 创建测试数据 X_test 和标签 y_test
X_test = torch.Tensor([[5], [6], [7], [8]])
y_test = torch.Tensor([[10], [12], [14], [16]])

# 测试模型
with torch.no_grad():
    predictions = model(X_test)
    loss = criterion(predictions, y_test)
    print(f'Test loss: {loss:.4f}')
上述代码,一开始先创建一个
LinearRegression 线性回归模型的类,其中有一个 forward 前向传播函数,调用时其实就是计算一下输出值 y。
主程序,一开始创建一个线性回归模型实例,然后定义一个用于评价模型效果的损失函数评价器,和用随机梯度下降(Stochastic Gradient Descent)作为优化器。
然后创建一个输入特征张量,和标签张量。用这组特征和标签进行训练,训练的过程就是根据 X 计算与测试 predictions 向量,再把它和 y 一起给评价器算出损失 loss,然后进行反向传播。注意反向传播的三行代码:
optimizer.zero_grad()
loss.backward()
optimizer.step()epoch 就是一次训练过程,有时也称为 iteration 或者 step,不断根据 loss 训练优化模型参数。然后我们创建了一组测试特征值张量 X_test,和测试标签张量 y_test,然后用它们测试模型性能,把测试特征得到的 predictions 与 y_test 共同传给评价器,得到 loss。在这个例子中我们会得到如下结果:
Test loss: 0.00342.3、逻辑回归(Logistic Regression):没有值域约束的线性回归,到限定在一个范围内的逻辑回归(常用于分类问题)
可以看到线性回归问题,输出值是没有范围限定的。如果限定(limit)在特定的 范围内,则就叫做逻辑回归了。那么如何将一个线性回归变成逻辑回归呢?一般通过如下公式变换:
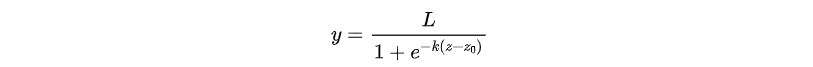
这样原来的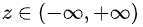 就被变换成了
 了。
激活函数:这种把输出值限定在一个目标范围内的函数,被叫做激活函数(Activation Function)。 函数的陡峭程度由  控制,越大越陡。
当 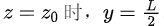 。
下面给出一个基于 Python 的 scikit-learn 库的示例代码:
from sklearn.linear_model import LogisticRegression
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# 这是 scikit-learn 库里的一个简单的数据集
iris = load_iris()

# 把 iris 数据集拆分成训练集和测试集两部分
X_train, X_test, y_train, y_test = train_test_split(iris.data, iris.target, test_size=0.25, random_state=42)

# 用 scikit-learn 库创建一个逻辑回归模型的实例
lr = LogisticRegression()

# 用上边 split 出来的训练集数据,训练 lr 模型实例
lr.fit(X_train, y_train)

# 用训练过的模型,拿测试集的输入数据做测试
predictions = lr.predict(X_test)

# 用测试集的数据验证精确性
accuracy = lr.score(X_test, predictions)
print(accuracy)
2.4、Sigmoid 回归(Sigmoid Regression):归一化的逻辑回归,一般用于二元分类任务
当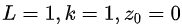 ,此时的激活函数就是
 函数,也常表示为
 函数,如下:
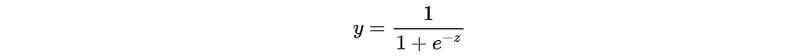
Sigmoid 回归的值域,恰好在 (0, 1) 之间,所以常备作为用来归一化的激活函数。而一个线性回归模型,再用 sigmoid 函数归一化,这种也常被称为「Sigmoid 回归」。Sigmoid 这个单词的意思也就是 S 形,我们可以看下它的函数图像如下:
因为归一化,所以也可以把输出值理解为一个概率。比如我们面对一个二元分类问题,那么输出结果就对应属于这个类别的概率。
这样一个 sigmoid 模型可以表示为:
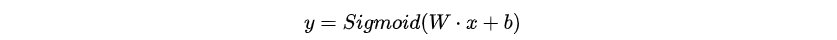
另外 函数的导数(即梯度)是很好算的:
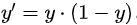 。这非常方便用于「梯度下降算法」根据 loss 对模型参数进行优化。Sigmoid 回归,一般用于二元分类任务。那么对于超过二元的情况怎么办呢?这就引出了下面的 Softmax 回归。
2.5、Softmax 回归(Softmax Regression):从解决二元任务的 sigmoid,到解决多元分类任务的 Softmax
相对逻辑回归,Softmax 也称为多项逻辑回归。上面说 Sigmoid 一般用于解决二元分类问题,那么多元问题就要用 Softmax 回归了。我们来拿一个具体问题来解释,比如问题是对于任意输入的一个电商商品的图片,来判断这个图片所代表的的商品,属于哪个商品类目。假设我们一共有 100 个类目。那么一个图片比如说其所有像素值作为输入特征值,输出就是一个 100 维的向量 ,输出向量中的每个值
 表示属于相对应类目的概率
 :
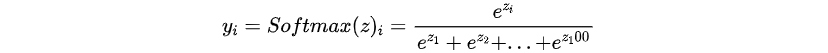
那么最后得到的 向量中的每一项就对应这个输入
 属于这 100 个类目的各自概率了。所以如果回归到一般问题,这个 Softmax 回归的模型就如下:
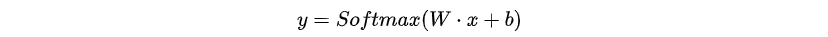
对于上面电商商品图片的例子,假设每个图片的尺寸是 512x512,这个模型展开式如下:
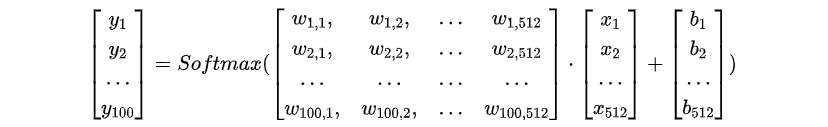
这个对输入向量 执行
 运算,一般也常称为「线性映射/线性变化」。
2.6、多层感知器(Multi-Layer Perceptron)
上面我们遇到的所有任务,都是用线性模型(Linear Models)解决的。有时候问题复杂起来,我们就要引入非线性模型了。
这里我们要介绍一个新的激活函数 —— (Rectified Linear Unit)—— 一个非线性激活函数,其定义如下:
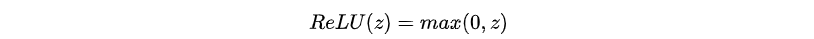
比如对于 MNIST 数据集的手写数字分类问题,就是一个典型的非线性的分类任务,下面给出一个示例代码:
import torch
import torch.nn as nn
import torchvision
import torchvision.transforms as transforms

# 定义多层感知器模型
class MLP(nn.Module):
    def __init__(self, input_size, hidden_size, num_classes):
        super(MLP, self).__init__()
        self.fc1 = nn.Linear(input_size, hidden_size)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_size, num_classes)

    def forward(self, x):
        out = self.fc1(x)
        out = self.relu(out)
        out = self.fc2(out)
        return out

# 超参数
input_size = 784
hidden_size = 500
num_classes = 10
num_epochs = 5
batch_size = 100
learning_rate = 0.001

# 加载 MNIST 数据集
train_dataset = datasets.MNIST(root='../../data',
                               train=True,
                               transform=transforms.ToTensor(),
                               download=True)

test_dataset = datasets.MNIST(root='../../data',
                              train=False,
                              transform=transforms.ToTensor())

# 数据加载器
train_loader = torch.utils.data.DataLoader(dataset=train_dataset,
                                           batch_size=batch_size,
                                           shuffle=True)

test_loader = torch.utils.data.DataLoader(dataset=test_dataset,
                                          batch_size=batch_size,
                                          shuffle=False)

model = MLP(input_size, hidden_size, num_classes)

# 定义损失函数和优化器
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)

# 训练模型
for epoch in range(num_epochs):
    for images, labels in train_loader:
        # 前向传播
        outputs = model(images)
        loss = criterion(outputs, labels)

        # 反向传播
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    # 输出训练损失
    print(f'Epoch {epoch + 1}, Training Loss: {loss.item():.4f}')
这段代码里,我们能看到 MLP 的模型定义是:
nn.Linear(input_size, hidden_size)
nn.ReLU()
nn.Linear(hidden_size, num_classes)
与前面的模型示例代码类似,也都用到了反向传播、损失函数评价器、优化器。如果用公式表示的话,就是如下的模型定义:
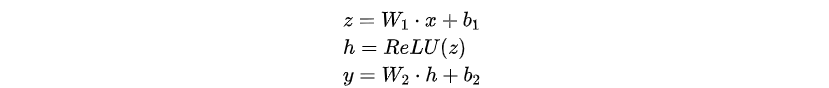
我们知道 MLP 通常是一个输入和输出长度相同的模型,但少数情况下也可以构建输入和输出长度不同的 MLP 模型,比如输入一组序列后,输出是一个离散的分类结果。
2.7、简述如何训练一个模型:正向传播与反向传播
这是个很重要的议题。但是春节时间有限,这部分只能简写了,我们更多聚焦在语言模型本身。这里简述一下,后续可能会再补全。
训练神经网络,主要包括前向传播、反向传播这两步。 正向传播,就是将数据输入给模型,基于已确定的一组参数(比如 MLP 中的权重 W、偏置 b 等),得到输出结果。根据输出结果计算损失函数,衡量当前参数下的模型性能。 反向传播最常用到的是梯度下降法(这里不讨论其他方法),依托损失函数,将其中的参数当做变量来求偏导(计算梯度),沿着梯度下降的方向求解损失函数的极小值,此时的参数可替代此前的参数。这就是对模型优化训练的一个典型过程。
引申问题 —— 梯度消失、梯度爆炸问题:因为对损失函数的求偏导,是从输出层向输入层反向基于「数学上的链式法则」计算的,数学上这是个连乘计算,层数越多越容易出现这个问题。这个求导过程可能会出现梯度为零的情况,即梯度消失。也有可能出现梯度值特别大的情况。
解决梯度消失、梯度爆炸问题,又是一个重要议题,这里篇幅所限也难以展开做技术笔记。粗暴的方式比如梯度剪切,Hinton 提出的逐层预训练后再整体精调理论上也 work,本文后续提到的 LSTM、ResNet 等也可以解决问题,我们也还能了解到业界各种解决手段,有机会再与朋友们交流学习。
2.8、MLP 的一个显著问题,帮我们引出 CNN 模型
我们可以看到,在 MLP 中,不论有多少层,某一层的输出向量 中的每个值,都会在下一层计算输出向量
 的每个值时用到。具体来说,如果对于某一层的输出值如下:
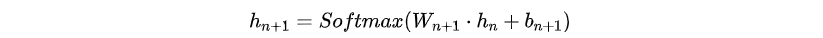
上一段话里所谓的「用到」,其实就是要针对 生成相应的特征值
 权重矩阵中的每个行列里的数值和
 偏差向量里的每个值。如果用图画出来,就是:
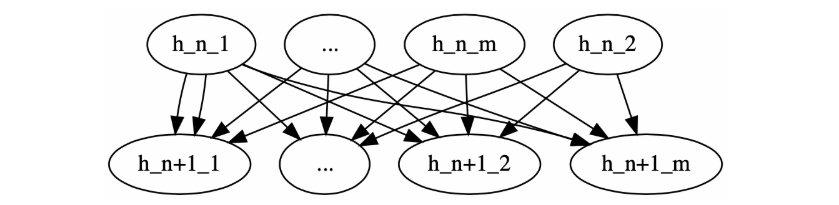
可以看到,输入的所有元素都被连接,即被分配权重 w 和偏差项 b,所以这被称为一个「全连接层(Fully Connected Layer)」或者「稠密层(Dense Layer)」。但是对于一些任务这样做是很蠢的,会付出大量无效的计算。
因此我们需要 focus 在更少量计算成本的模型,于是有了卷积神经网络(CNN)。
第 3 节 · 卷积神经网络(CNN)
MLP 里每一层的每个元素,都要乘以一个独立参数的权重 W,再加上一个偏执 b,这样的神经网络层常被我们叫做「全连接层(Fully Connected Layer)或稠密层(Dence Layer)。但是这样有个显著问题:如果输入内容的局部重要信息只是发生轻微移动并没有丢失,在全连接层处理后,整个输出结果都会发生很大变化 —— 这不合理。
于是我们会想到,如果我们用一个小一些的全连接层,只对重要的局部输入进行处理呢?其实这个思路和 n-gram 是类似的,都是用一个窗口来扫描局部。卷积神经网络(Convolutional Neural Network,CNN)就是基于此诞生的。
卷积核:卷积核是一个小的稠密层,用于提取局部特征,又称其为卷积核(kernel)/ 滤波器(filter)/ 感受野(receptive field / field of view)。 池化层(Pooling,或称汇聚层):经过卷积核处理的结果,进一步聚合的过程。对于输入大小不一样的样本,池化后将有相同个数的特征输出。 提取多个局部特征:一个卷积核只能提取单一类型的局部特征,需要提取多种局部特征则需要多个卷积核。有些文章里你看提到「多个模式」、「多个通道」,其实指的就是多个 kernel 识别多个特征。 全连接分类层:多个卷积核得到的多个特征,需经过一个全连接的分类层用于最终决策。
这样做有几个特性:
本地性(Locality):输出结果只由一个特定窗口大小区域内的数据决定。 平移不变性(Translation Invariant):对同一个特征,扫描不同区域时只用一个 kernel 来计算。 卷积层的参数规模,与输入输出数据大小无关。
CNN 主要的适用领域是计算机视觉。而在 NLP 中,文本数据的维度很高,并且语言的结构比图像更复杂。因此,CNN 一般不适用于处理 NLP 问题。
第 4 节 · 循环神经网络(RNN)
RNN(循环神经网络),这是一种强大的神经网络模型,能够预测序列数据,例如文本、语音和时间序列。我们将通过生动的代码示例和实际案例来演示如何使用 RNN,并在日常生活中真实地体验它的功能。您将学习到如何使用 RNN 解决各种机器学习问题,并动手尝试运用 RNN 解决实际问题。这篇文章将为您提供一个完整的 RNN 入门指南,并使您对 RNN 有更深入的了解。
RNN(Recurrent Neural Network)的 R 是 Recurrent 的意思,所以这是一个贷循环的神经网络。首先要明白一点,你并不需要搞懂 CNN 后才能学习 RNN 模型。你只要了解了 MLP 就可以学习 RNN 了。
4.1、经典结构的 RNN
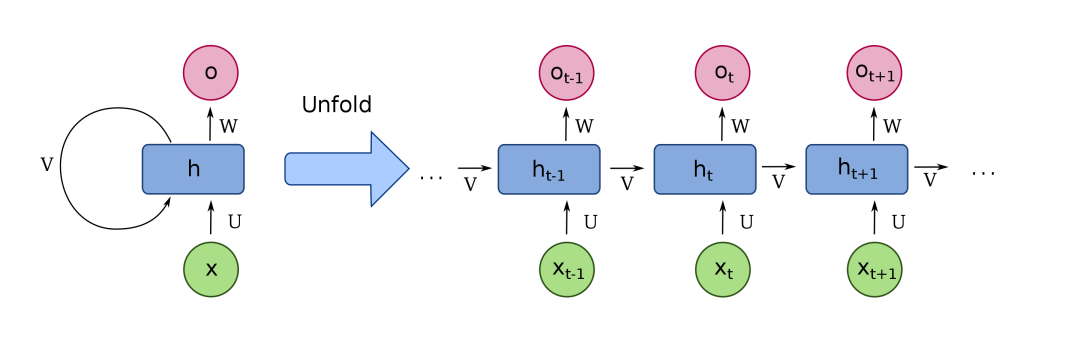
上图这是一个经典结构的 RNN 示意图,Unfold 箭头右侧是展开示意。输入序列(这里用 表示)传递给隐藏层(hidden layer,这里用
 表示),处理完生成输出序列(这里用
 表示)。序列的下一个词输入时的、上一步隐藏层会一起影响这一步的输出。
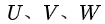 都表示权重。在这个经典结构理,你可以看到非常重要的一点,就是输入序列长度与输出序列长度是相同的。
这种经典结构的应用场景,比如对一段普通话输入它的四川话版本,比如对视频的每一帧进行处理并输出,等等。
我们知道 RNN 是一个一个序列处理的,每个序列中的数据项都是有序的,所以对于计算一个序列内的所有数据项是无法并行的。但是计算不同序列时,不同序列各自的计算则是可以并行的。如果我们把上一个时刻 t 隐藏层输出的结果 传给一个激活函数(比如说用正切函数
tanh函数),然后和当下时刻 t 的这个输入 一起,处理后产生一个时刻
 的输出
 。然后把隐藏层的输出通过多项逻辑回归(Softmax)生成最终的输出值
 ,我们可以如下表示这个模型:
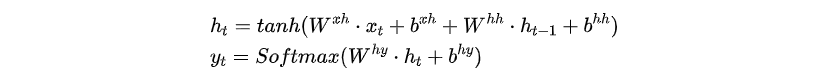
对应的示意图如下:
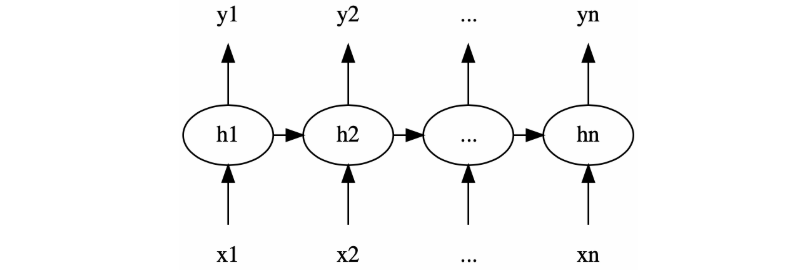
这种输入和输出数据项数一致的 RNN,一般叫做 N vs. N 的 RNN。如果我们用 PyTorch 来实现一个非常简单的经典 RNN 则如下:
import torch
import torch.nn as nn

# 创建一个 RNN 实例
# 第一个参数
rnn = nn.RNN(10, 20, 1, batch_first=True)  # 实例化一个单向单层RNN

# 输入是一个形状为 (5, 3, 10) 的张量
# 5 个输入数据项(也可以说是样本)
# 3 个数据项是一个序列,有 3 个 steps
# 每个 step 有 10 个特征
input = torch.randn(5, 3, 10)

# 隐藏层是一个 (1, 5, 20) 的张量
h0 = torch.randn(1, 5, 20)

# 调用 rnn 函数后,返回输出、最终的隐藏状态
output, hn = rnn(input, h0)

print(output)
print(hn)
我们来解读一下这段代码:
这段代码实例化了一个带有 1 个隐藏层的 RNN 网络。
它的输入是一个形状为 (5, 3, 10) 的张量,表示有 5 个样本,每个样本有 3 个时间步,每个时间步的特征维度是 10。
初始隐藏状态是一个形状为 (1, 5, 20) 的张量。
调用 rnn 函数后,会返回输出和最终的隐藏状态。
输出的形状是 (5, 3, 20),表示有 5 个样本,每个样本有 3 个时间步,每个时间步的输出维度是 20。
最终的隐藏状态的形状是 (1, 5, 20),表示最后的隐藏状态是 5
但是上面的代码示例,并没有自己编写一个具体的 RNN,而是用了默认的 PyTorch 的 RNN,那么下面我们就自己编写一个:
class MikeCaptainRNN(nn.Module):
    def __init__(self, input_size, hidden_size):
        super().__init__()

        # 对于 RNN,输入维度就是序列数
        self.input_size = input_size

        # 隐藏层有多少个节点/神经元,经常将 hidden_size 设置为与序列长度相同
        self.hidden_size = hidden_size

        # 输入层到隐藏层的 W^{xh} 权重、bias^{xh} 偏置项
        self.weight_xh = torch.randn(self.hidden_size, self.input_size) * 0.01
        self.bias_xh = torch.randn(self.hidden_size)

        # 隐藏层到隐藏层的 W^{hh} 权重、bias^{hh} 偏置项
        self.weight_hh = torch.randn(self.hidden_size, self.hidden_size) * 0.01
        self.bias_hh = torch.randn(self.hidden_size)

    # 前向传播
    def forward(self, input, h0):

     # 取出这个张量的形状
        N, L, input_size = input.shape

        # 初始化一个全零张量
        output = torch.zeros(N, L, self.hidden_size)

        # 处理每个时刻的输入特征
        for t in range(L):

         # 获得当前时刻的输入特征,[N, input_size, 1]。unsqueeze(n),在第 n 维上增加一维
            x = input[:, t, :].unsqueeze(2)
            w_xh_batch = self.weight_xh.unsqueeze(0).tile(N, 1, 1)  # [N, hidden_size, input_size]
            w_hh_batch = self.weight_hh.unsqueeze(0).tile(N, 1, 1)  # [N, hidden_size, hidden_size]

            # bmm 是矩阵乘法函数
            w_times_x = torch.bmm(w_xh_batch, x).squeeze(-1)  # [N, hidden_size]。squeeze(n),在第n维上减小一维
            w_times_h = torch.bmm(w_hh_batch, h0.unsqueeze(2)).squeeze(-1)  # [N, hidden_size]
            h0 = torch.tanh(w_times_x + self.bias_ih + w_times_h + self.bias_hh)
            output[:, t, :] = h0
        return output, h0.unsqueeze(0)
上述代码中 weight_xh、bias_xh。weighthh
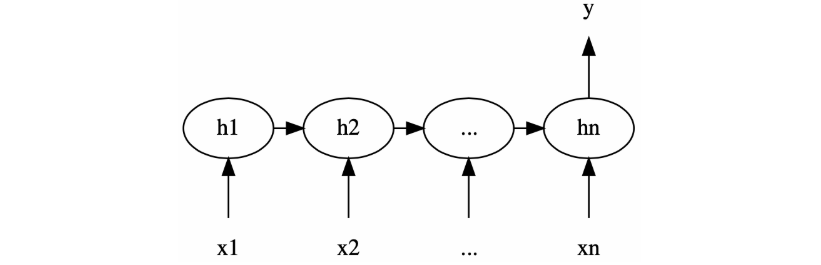
4.2、N vs.1 的 RNN
上面那个图里,如果只保留最后一个输出,那就是一个 N vs. 1 的 RNN 了。这种的应用场景,比如说判断一个文本序列是英语还是德语,比如根据一个输入序列来判断是一个正向情绪内容还是负向或者中性,或者比如根据一段语音输入序列来判断是哪一首曲子(听歌识曲)。
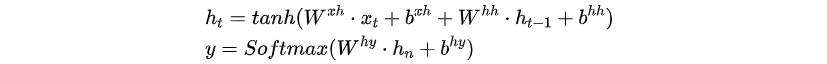
即这个模型里,每个序列只有隐藏层对最后一个数据项进行处理时才产生输出 如果用示意图表示,则是如下结构:
4.3、1 vs. N 的 RNN
反过来,上面那个图里,如果只保留一个 x,那么就是一个 1 vs. N 的 RNN 了。这种场景的应用,比如 AI 创作音乐,还有通过一个 image 提炼或识别某些文本内容输出。
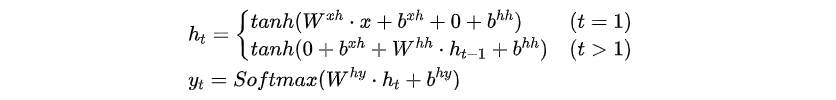
示意图如下:
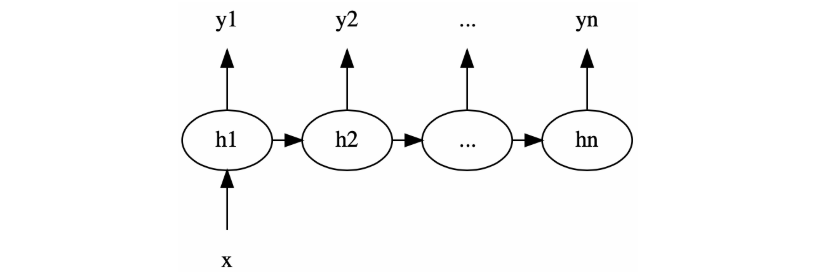
到这里我们可以看到,在 RNN 的隐藏层是能够存储一些有关于输入数据的一些相关内容的,所以也常把 RNN 的隐藏层叫做记忆单元。
4.4、LSTM(Long Short-Term Memory)长短时记忆网络
4.4.1、如何理解这个 Short-Term 呢?
1997 年论文《Long Short-Term Memory》中提出 LSTM 模型。我们先从模型的定义,精确地来理解一下:
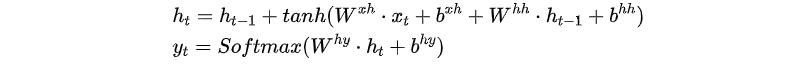
上式中与经典结构的 RNN(输入与输出是 N vs. N)相比,唯一的区别是第一个式子中多了一个 。如果我们把第一个式子的
 部分记作
 :
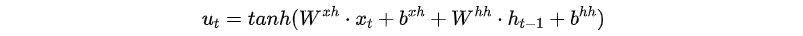
所以:
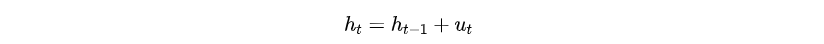
那么可以展开出如下一组式子:
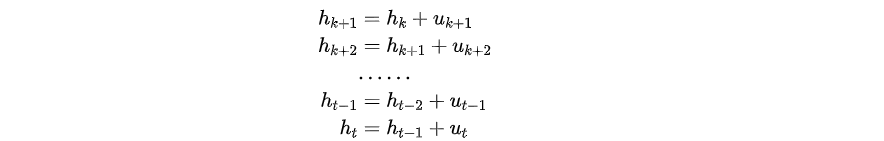
如果我们从 到
 的所有式子左侧相加、右侧相加,我们就得到如下式子:
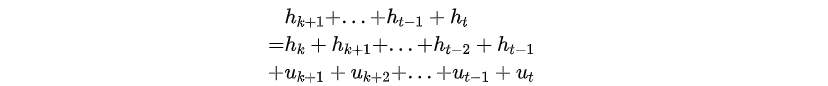
进而推导出:
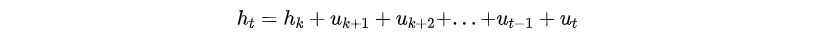
从这里我们就可以看到,第 t 时刻的隐藏层输出,直接关联到第 k 时刻的输出,t 到 k 时刻的相关性则用 到
 相加表示。也就是有 t-k 的短期(Short Term)记忆。
4.4.2、引入遗忘门 f、输入门 i、输出门 o、记忆细胞 c
如果我们为式子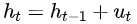 右侧两项分配一个权重呢?就是隐藏层对上一个数据项本身被上一个数据项经过隐藏层计算的结果,这两者做一对权重考虑配比,如下:
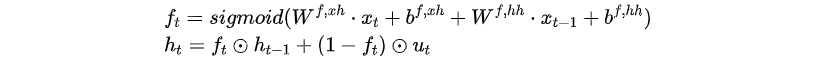
其中:
 是 Hardamard 乘积,即张量的对应元素相乘。
 是「遗忘门(Forget Gate)」,该值很小时 t-1 时刻的权重就很小,也就是「此刻遗忘上一刻」。该值应根据 t 时刻的输入数据、t-1 时刻数据在隐藏层的输出计算,而且其每个元素必须是 (0, 1) 之间的值,所以可以用 sigmoid 函数来得到该值:
但这种方式,对于过去 和当下
 形成了互斥,只能此消彼长。但其实过去和当下可能都很重要,有可能都恨不重要,所以我们对过去继续采用
 遗忘门,对当下采用
 输入门(Input Gate):
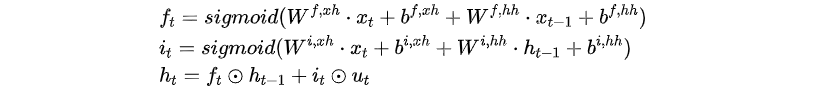
其中:
与  类似地,定义输入门
 ,但是注意
 与
 而非
 有关。
再引入一个输出门:
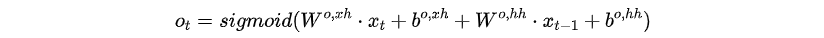
再引入记忆细胞 ,它是原来
 的变体,与 t-1 时刻的记忆细胞有遗忘关系(通过遗忘门),与当下时刻有输入门的关系:
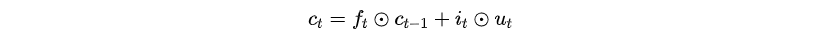
那么此时 ,我们可以把
 变成:
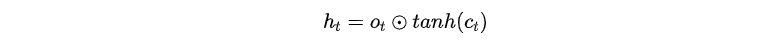
记忆细胞这个概念还有有一点点形象的,它存储了过去的一些信息。OK,到此我们整体的 LSTM 模型就变成了这个样子:
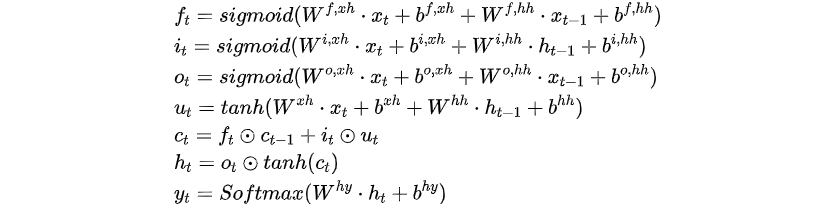
4.5、双向循环神经网络、双向 LSTM
双向循环神经网络很好理解,就是两个方向都有,例如下图:
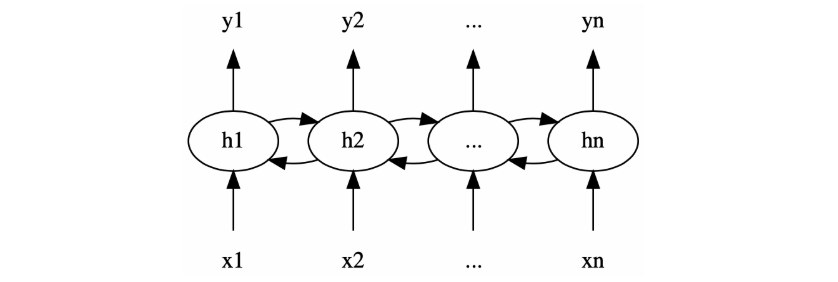
在 PyTorch 中使用nn.RNN就有参数表示双向:
bidirectional– If True, becomes a bidirectional RNN. Default: False
bidirectional:默认设置为False。若为True,即为双向 RNN。
4.6、堆叠循环神经网络(Stacked RNN)、堆叠长短时记忆网络(Stacked LSTM)
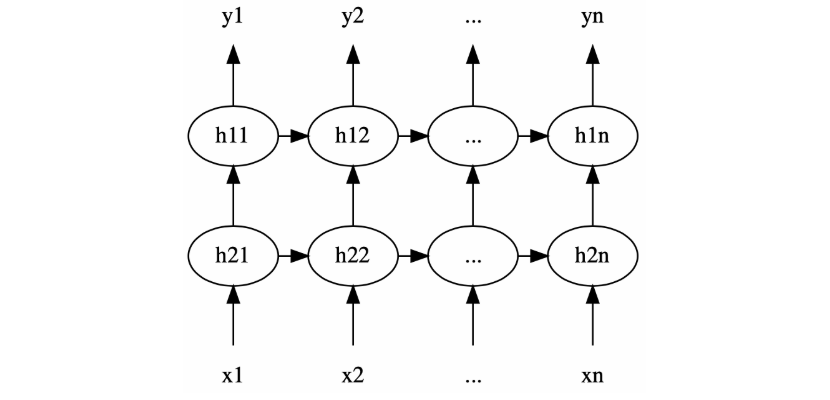
在 PyTorch 中使用nn.RNN就有参数表示双向:
num_layers – Number of recurrent layers. E.g., setting num_layers=2 would mean stacking two RNNs together to form a stacked RNN, with the second RNN taking in outputs of the first RNN and computing the final results. Default: 1
num_layers:隐藏层层数,默认设置为 1 层。当num_layers>= 2 时,就是一个 stacked RNN 了。
4.7、N vs. M 的 RNN
对于输入序列长度(长度 N)和输出序列长度(长度 M)不一样的 RNN 模型结构,也可以叫做 Encoder-Decoder 模型,也可以叫 Seq2Seq 模型。首先接收输入序列的 Encoder 先将输入序列转成一个隐藏态的上下文表示 C。C 可以只与最后一个隐藏层有关,甚至可以是最后一个隐藏层生成的隐藏态直接设置为 C,C 还可以与所有隐藏层有关。
有了这个 C 之后,再用 Decoder 进行解码,也就是从把 C 作为输入状态开始,生成输出序列。
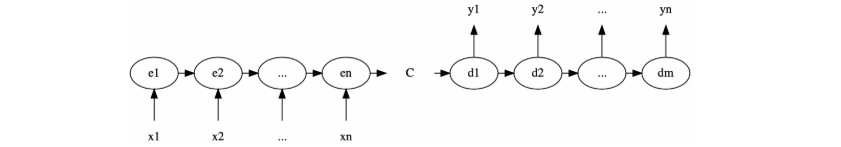
具体地,可以如下表示:
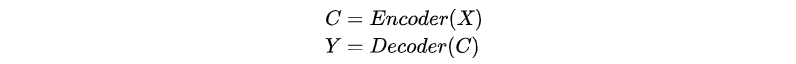
进一步展开:
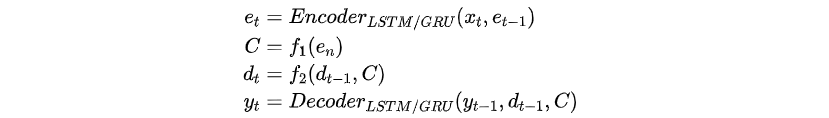
这种的应用就非常广了,因为大多数时候输入序列与输出序列的长度都是不同的,比如最常见的应用「翻译」,从一个语言翻译成另一个语言;再比如 AI 的一个领域「语音识别」,将语音序列输入后生成所识别的文本内容;还有比如 ChatGPT 这种问答应用等等。
Seq2Seq 模型非常出色,一直到 2018 年之前 NLP 领域里该模型已成为主流。但是它有很显著的问题:
当输入序列很长时,Encoder 生成的 Context 可能就会出现所捕捉的信息不充分的情况,导致 Decoder 最终的输出是不尽如人意的。具体地,毕竟还是 RNN 模型,其词间距过长时还是会有梯度消失问题,根本原因在于用到了「递归」。当递归作用在同一个 weight matrix 上时,使得如果这个矩阵满足条件的话,其最大的特征值要是小于 1 的话,就一定出现梯度消失问题。后来的 LSTM 和 GRU 也仅仅能缓解问题,并不能根本解决。 并行效果差:每个时刻的结果依赖前一时刻。
第 5 节 · 为什么说 RNN 模型没有体现「注意力」?
Encoder-Decoder 的一个非常严重的问题,是依赖中间那个 context 向量,则无法处理特别长的输入序列 —— 记忆力不足,会忘事儿。而忘事儿的根本原因,是没有「注意力」。
对于一般的 RNN 模型,Encoder-Decoder 结构并没有体现「注意力」—— 这句话怎么理解?当输入序列经过 Encoder 生成的中间结果(上下文 C),被喂给 Decoder 时,这些中间结果对所生成序列里的哪个词,都没有区别(没有特别关照谁)。这相当于在说:输入序列里的每个词,对于生成任何一个输出的词的影响,是一样的,而不是输出某个词时是聚焦特定的一些输入词。这就是模型没有注意力机制。
人脑的注意力模型,其实是资源分配模型。NLP 领域的注意力模型,是在 2014 年被提出的,后来逐渐成为 NLP 领域的一个广泛应用的机制。可以应用的场景,比如对于一个电商平台中很常见的白底图,其边缘的白色区域都是无用的,那么就不应该被关注(关注权重为 0)。比如机器翻译中,翻译词都是对局部输入重点关注的。
所以 Attention 机制,就是在 Decoder 时,不是所有输出都依赖相同的「上下文 」,而是时刻 t 的输出,使用
 ,而这个
 来自对每个输入数据项根据「注意力」进行的加权。
第 6 节 · 基于 Attention 机制的 Encoder-Decoder 模型
2015 年 Dzmitry Bahdanau 等人在论文《Neural Machine Translation by Jointly Learning to Align and Translate》 中提出了「Attention」机制,下面请跟着船涨,船涨会深入浅出地为你解释清楚。
下图中 表示编码器的隐藏层输出,
 表示解码器的隐藏层输出
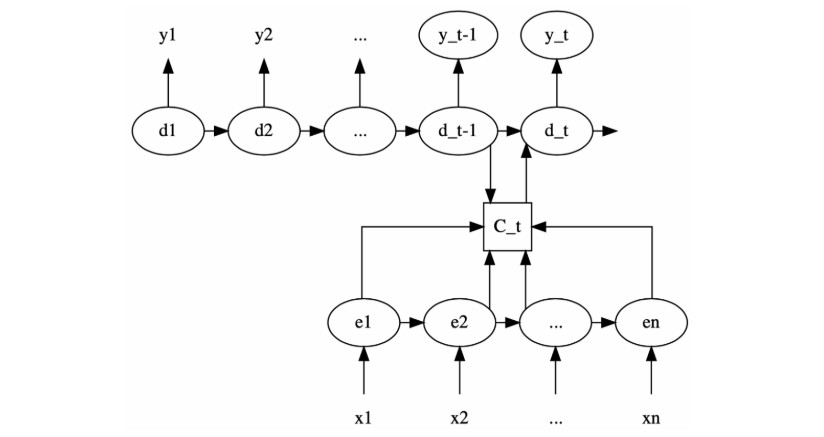
更进一步细化关于 部分,船涨在此引用《基于深度学习的道路短期交通状态时空序列预测》一书中的图:

这个图里的 与上一个图里的
 对应,
 与上一个图里的
 对应。
针对时刻 要产出的输出,隐藏层每一个隐藏细胞都与
 有一个权重关系
 其中
 ,这个权重值与「输入项经过编码器后隐藏层后的输出
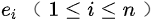 、解码器的前一时刻隐藏层输出
 两者有关:
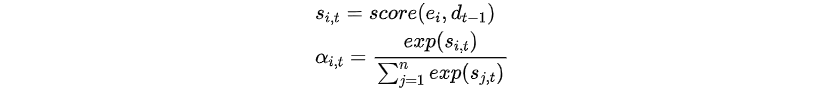
常用的 函数有:
点积(Dot Product)模型: 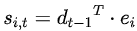
缩放点积(Scaled Dot-Product)模型: 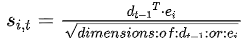 ,可避免因为向量维度过大导致点积结果太大
然后上下文向量就表示成:
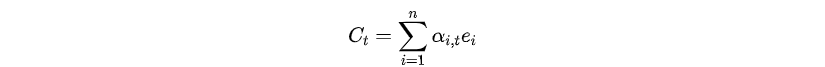
还记得 RNN 那部分里船涨讲到的 Encoder-Decoder 模型的公式表示吗?
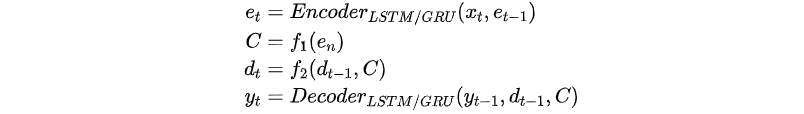
加入 Attention 机制的 Encoder-Decoder 模型如下。
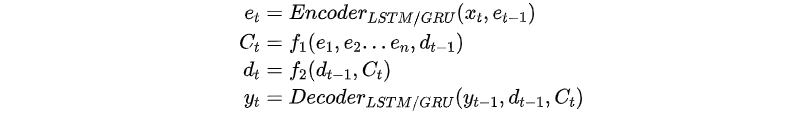
这种同时考虑 Encoder、Decoder 的 Attention,就叫做「Encoder-Decoder Attention」,也常被叫做「Vanilla Attention」。可以看到上面最核心的区别是第二个公式 。加入 Attention 后,对所有数据给予不同的注意力分布。具体地,比如我们用如下的函数来定义这个模型:
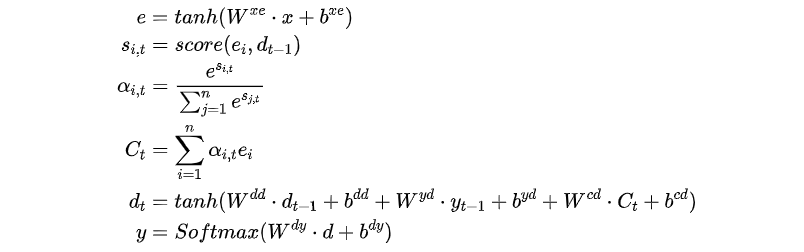
到这里你能发现注意力机制的什么问题不?这个注意力机制忽略了位置信息。比如 Tigers love rabbits 和 Rabbits love tigers 会产生一样的注意力分数。
更多详细内容,可点击链接查看原文:
