
 语音小管家
WeSpeaker正式更新C++部署链路,推理引擎使用OnnxRuntime,支持从语音中提取Speaker Embedding信息,代码详见WeSpeaker/runtime[1]。
Libtorch和onnx的选择?
Speaker Embedding提取任务流程简单,并且声纹模型(如ResNet\ECAPA-TDNN)相对简单,只需简单几行代码即可导出Onnx模型; Libtorch包过大,并且使用过程中需要和pytorch的版本一致,OnnxRuntime相对轻便,只需12M左右;
整体包含四部分:frontend、speaker、utils、bin
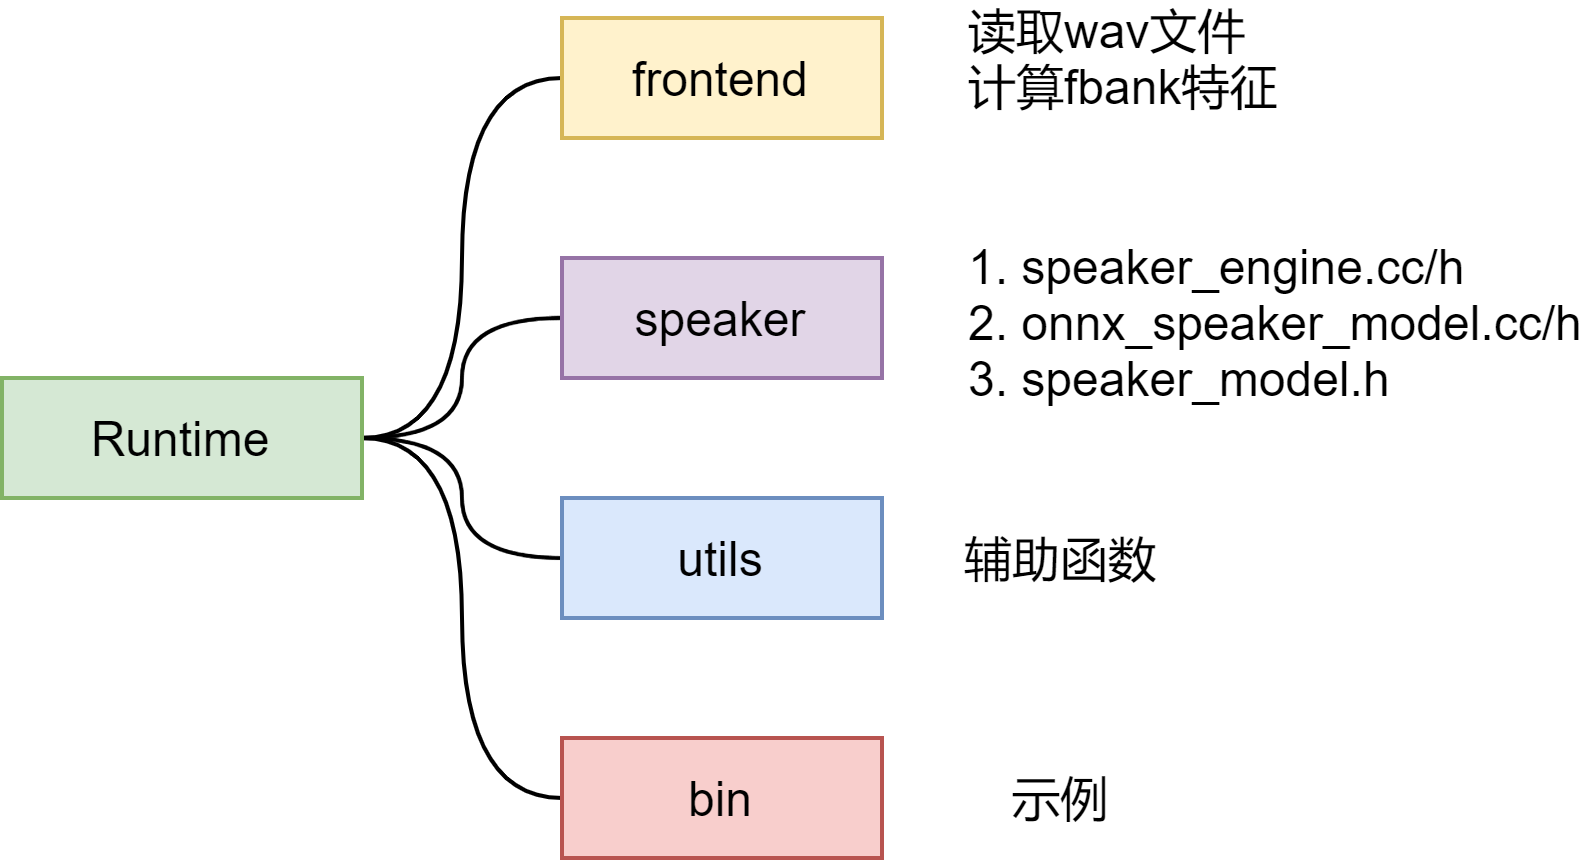
frontend
speaker
speaker_model.h: 定义基类 SpeakerModel:便于实现对不同推理引擎的支持。onnx_speaker_model.cc/h:继承基类 SpeakerModel,基于OnnxRuntime推理引擎。speaker_engine.cc /h: 实现 SpeakerEngine类,供外部调用:
intEmbeddingSize();返回Embedding的大小,用于推理前申请空间。
void ExtractFeature(const int16_t* data, int data_size,
  std::vector>>* chunks_feat);
提取fbank特征,如果SamplesPerChunk<=0, 对整个句子提取特征,否则分块计算特征,块大小为SamplesPerChunk。
data:输入数据的地址,数据类型为int16 data_size: 输入数据的长度 chunks_feat: 输出特征,大小为[n, T, D]
void ExtractEmbedding(const int16_t* data, int data_size,
                      std::vector* avg_emb);
输入音频数据,提取Embedding特征。注意:对每个chunk提取embedding,最终取平均输出。 data: 输入数据地址,数据类型为int16 data_size: 输入数据的长度 avg_emb: 输出embedding特征
float CosineSimilarity(const std::vector& emb1,
                       const std::vector& emb2)
计算两个embedding之间的余弦相似度得分。
utils
WriteToFile、ReadToFile将embedding信息写入文件或读取文件。bin
asv_main.cc: 计算两条语音的相似度export GLOG_logtostderr=1
export GLOG_v=2
onnx_dir=your_model_dir
./build/bin/asv_main \
--enroll_wav wav1_path \
--test_wav wav2_path \
--threshold 0.5 \
--speaker_model_path $onnx_dir/final.onnx
2、extract_emb_main.cc: 批量提取embedding并保存到txt文件中,同时计算RTF
export GLOG_logtostderr=1
export GLOG_v=2
wav_scp=your_test_wav_scp
onnx_dir=your_model_dir
embed_out=your_embedding_txt
./build/bin/extract_emb_main \
  --wav_list $wav_scp \
  --result $embed_out \
  --speaker_model_path $onnx_dir/final.onnx
  --SamplesPerChunk  80000  # 5s
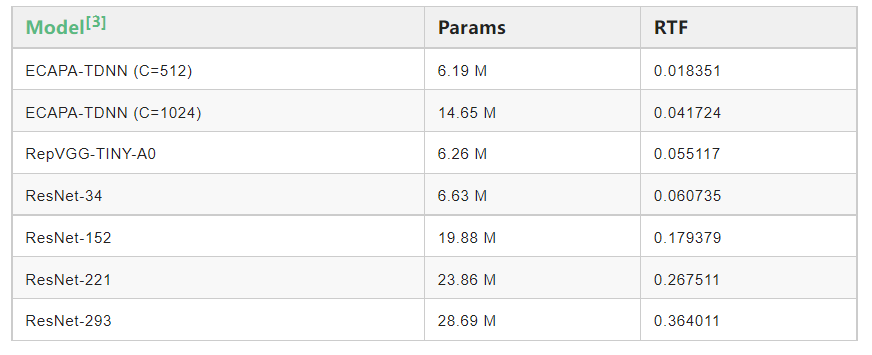
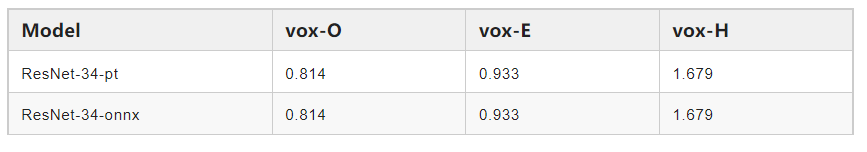
benchmark
num_threads = 1
SamplesPerChunk = 80000
CPU: Intel(R) Xeon(R) Platinum 8160 CPU @ 2.10GHz
欢迎大家使用WeSpeaker,服务于各种下游任务,也欢迎社区的贡献和宝贵建议!
参考资料
[1] WeSpeaker/runtime:https://github.com/wenet-e2e/wespeaker/tree/master/runtime/onnxruntime
[2] WeNet-frontend:https://github.com/wenet-e2e/wenet/tree/main/runtime/core/frontend
[3] Model:https://github.com/wenet-e2e/wespeaker/blob/master/docs/pretrained.md
