语音小管家
INTERSPEECH是由国际语音通讯协会创办的顶级语音信号处理领域的国际会议,备受全球各地语音语言领域人士的广泛关注。此次会议的主题是:INCLUSIVE SPOKEN LANGUAGE SCIENCE AND TECHNOLOGY – BREAKING DOWN BARRIERS。
论文链接:https://arxiv.org/abs/2305.13700
首次提出了发音特征和音素持续时间特征用于伪造语音检测。 采用了注意力机制方法,有效地将韵律特征和发音特征与wav2vec特征融合在一起。
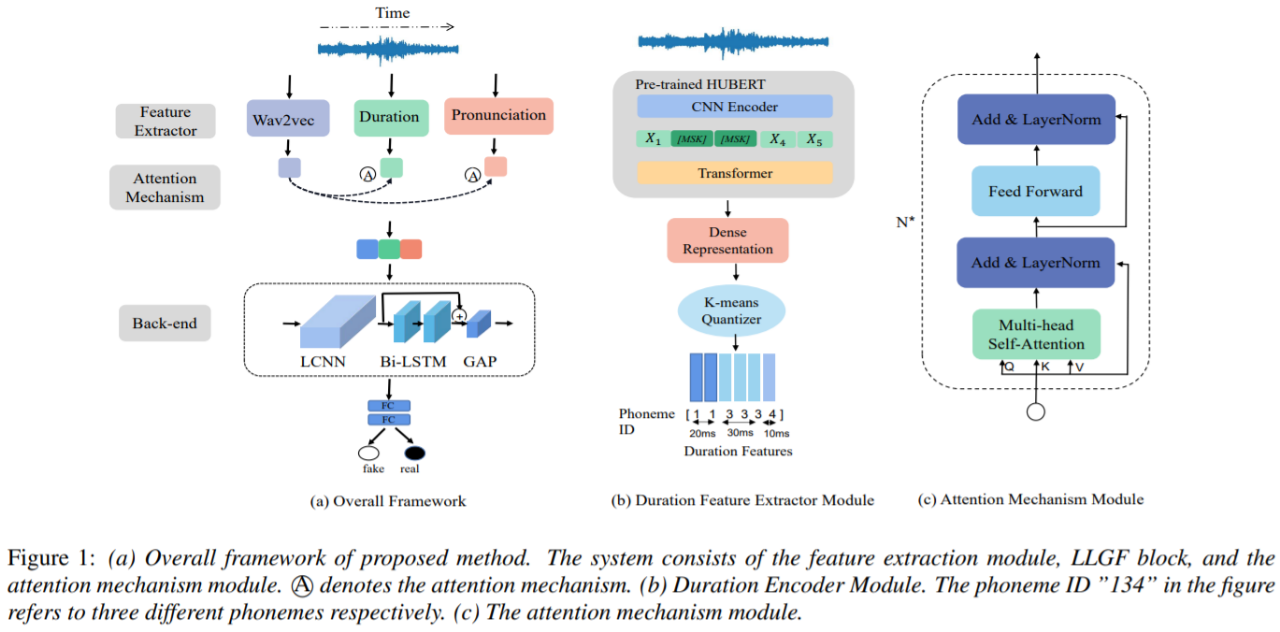
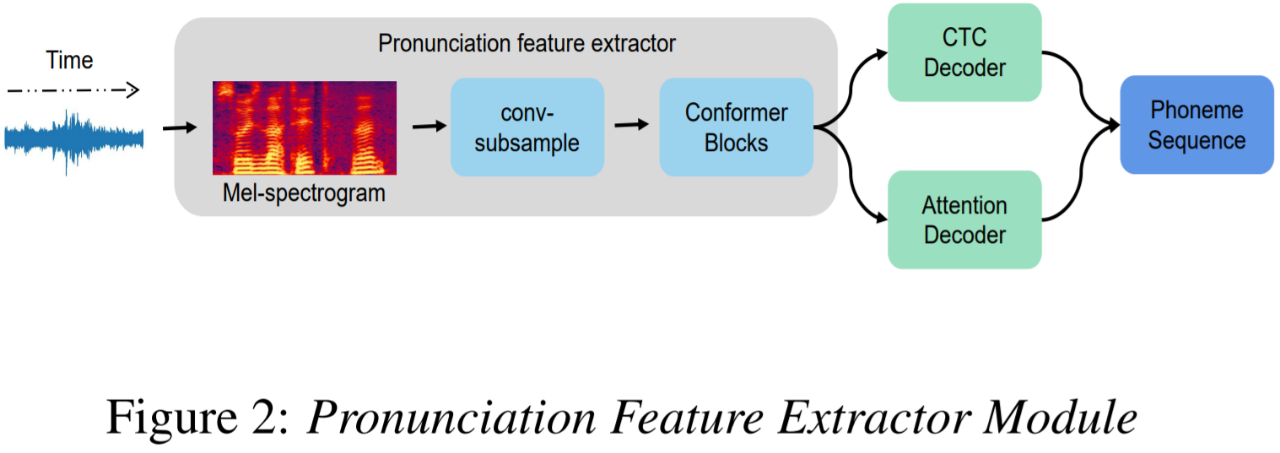
我们的模型由三个主要模块组成。首先,我们使用特征提取器提取三种类型的特征,包括wav2vec特征、音素持续时间特征和发音特征。需要注意的是,我们认为音素的持续时间可以反映韵律信息,因此在本文中,“韵律特征”指的是音素的持续时间。其次,注意力模块将韵律和发音特征与不同的权重融合到wav2vec特征中。最后,后端学习语音的深度表示。我们的方法的架构如图1(a)所示,我们在接下来的内容中提供更多细节。
特征:
持续时间:由于现有的公开可用的伪造语音数据集(如ASVspoof、ADD2022等)没有提供音频对应的转录,因此我们无法通过强制对齐来提取伪造语音的持续时间信息。受到启发,我们使用预训练模型HuBERT编码语音,并得到的编码向量类似于语音音素。如图1(b)所示,第一步是使用在LibriSpeech语料库上预训练的HuBERT模型将原始音频编码为编码向量。我们选择k-means作为量化操作,将编码器的输出从连续值转换为离散值。形式上,Di = Q(Ci),其中Q是量化函数k-means,Ci是一个向量序列,Di = [d1, d2, . . ., dT],其中di ∈ {1, 2, . . ., K},K是音素词汇表的大小,我们将K设置为100。我们将最终获得的Di(例如[1, 1, 3, 3, 3, 4])称为音素持续时间向量。
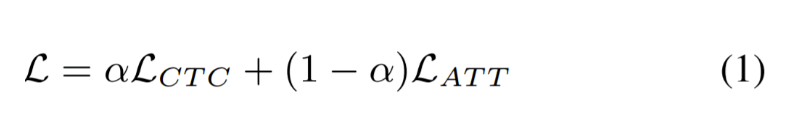
数据集:
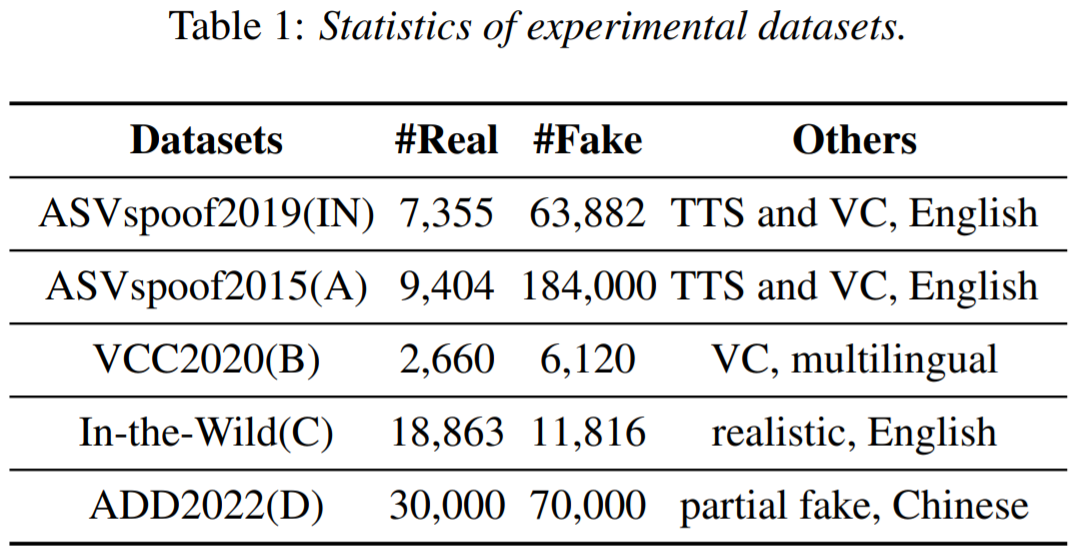
我们使用了五个伪造语音数据集。所有模型都在ASVspoof2019 LA训练集上进行了训练。ASVspoof2015与ASVspoof2019 LA最相似,因为它们的音频来自相同的数据集或转换算法。VCC2020数据集是多语言的。In-the-Wild数据集来自真实世界。ADD2022 track2数据集是中文的,并且部分是伪造的。
实验结果与讨论:
基线结果:
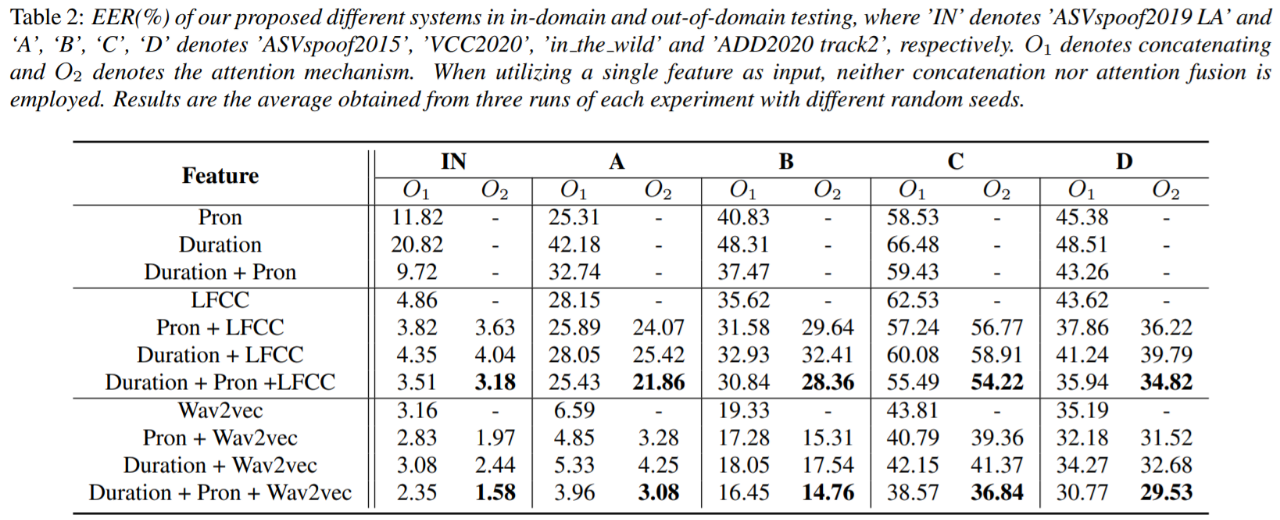
表2的前几行展示了各种数据集上单个特征的结果。值得注意的是,本文讨论的所有模型仅在ASVspoof2019 LA数据集上进行了训练,然后在不同的数据集上进行了测试。根据我们的观察,跨数据集测试是一项具有挑战性的任务。例如,在评估LFCC时,在ASVspoof2019 LA集合上的EER为4.86%,但在所有其他四个数据集上的表现都有所下降。相比之下,Wav2vec表现出比LFCC更好的泛化能力,在ASVspoof2015 LA测试集上的EER为6.59%,但在VCC2020、In-the-Wild和ADD2022数据集上表现不佳。这是因为不同数据集的虚假语音生成和真实语音录制环境的差异。这些发现支持我们论文的动机,即增强检测模型在不同数据集上的泛化能力。第二个观察是,单个韵律或发音特征在域内和域外测试中表现不佳。这可能是因为韵律特征是一维的,而wav2vec特征是128维的,LFCC特征是60维的。由于它们的维度有限,韵律特征相较于短时频谱特征和wav2vec特征包含的信息较少,导致语音中的声学相关信息丢失。此外,发音特征的表现不佳可能是由于发音提取器的训练数据较小,仅包含960小时的数据,而wav2vec的训练数据为436k小时。
所提方法结果:
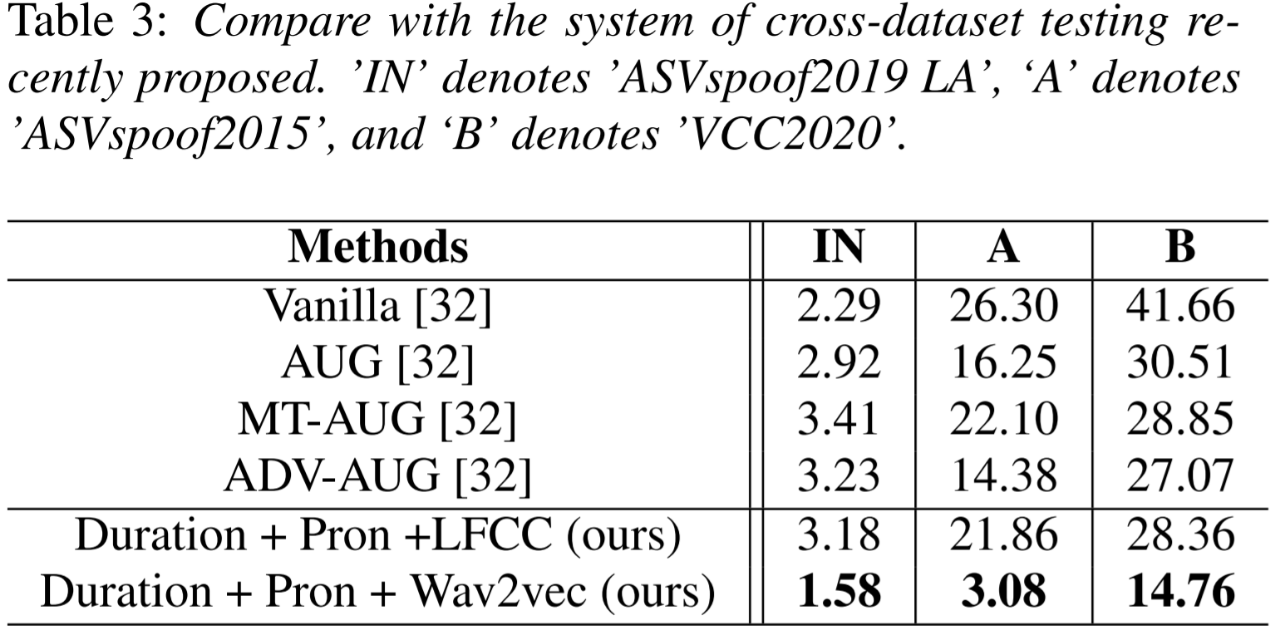
表2的最后几行展示了所提出方法在各种数据集上的结果。我们可以得出以下结论:首先,对于内域和外域测试,将韵律特征和发音特征与wav2vec特征相结合的性能优于仅使用wav2vec特征的性能。这表明将韵律和发音特征作为辅助特征使用具有积极影响。具体而言,将这两个特征与wav2vec特征连接起来,可以获得最显著的性能改进,在ASVspoof2015测试集上,EER从6.59%降至3.96%。这是由于从韵律和发音维度添加了wav2vec信息。其次,使用注意力机制的融合方法比直接连接方法具有更好的性能。例如,当前端输入为“duration + pron+ wav2vec”时,在VCC2020测试集上,注意力机制方法的性能比直接连接方法好1.69%。这是因为注意力机制分配韵律特征和发音特征的权重,使模型更加关注能够区分真实和伪造语音的特征,从而提高模型的泛化能力。第三,在跨数据集测试中,所提出的方法比其他三个数据集改进了ASVspoof2015。例如,当前端输入为“duration + pron+ wav2vec”时,与WAV2VEC特征相比,ASVspoof2015的相对改进率为53.26%,而VCC2020、in the wild和ADD2022的相对改进率分别为23.64%、15.90%和15.76%。这是因为ASVspoof2015数据集的组成与ASVspoof2019相似。此外,对于LFCC,可以得出与wav2vec类似的结论。首先,对于内域和外域测试,将韵律特征和发音特征与LFCC特征相结合的性能优于仅使用LFCC特征的性能。其次,使用注意力机制的融合方法比直接连接方法具有更好的性能。第三,在跨数据集测试中,所提出的方法比其他三个数据集改进了ASVspoof2015。