当前,对于语音信号进行离散化处理并使用离散语音token,已经成为语音合成(Text-to-speech, TTS)任务中最具有潜力的方向之一。上海交通大学X-LANCE实验室继去年首次提出了基于离散语音token的语音合成模型VQTTS,并在ICASSP 2023 LIMMITS Challenge中取得自然度评测第一名后,近日推出了更加强大的基于上下文语音信息的语音合成模型UniCATS。UniCATS提出Contextual VQ-Diffusion和Contextual vocoding技术,打破了现有模型性能受制于audio codec模型的框架,使用3秒的语音prompt即可准确地复制未见说话人的音色并实现了极高质量的合成语音。此外,UniCATS还支持同时基于上文和下文语音的语音片段编辑,实现与上下文语音的连贯衔接。在这两个任务上,UniCATS均实现了新的SOTA性能。
论文地址
https://arxiv.org/abs/2306.07547
Demo网页
https://cpdu.github.io/unicats
合成样例
通过语音续写实现零样本说话人自适应(黑色为Context,橙色为合成)
[Prompt] Yet the two have often been confused in the popular mind.[Continuation] He was unjustly charged with favoring secession; but the charge was soon disproved.[Prompt] A sudden wave of scarlet swept over Eliza's face.[Continuation] Then he deliberately locked Kenneth and Beth in with the forger, and retreated along the passage.语音编辑(黑色为Context,橙色为合成)
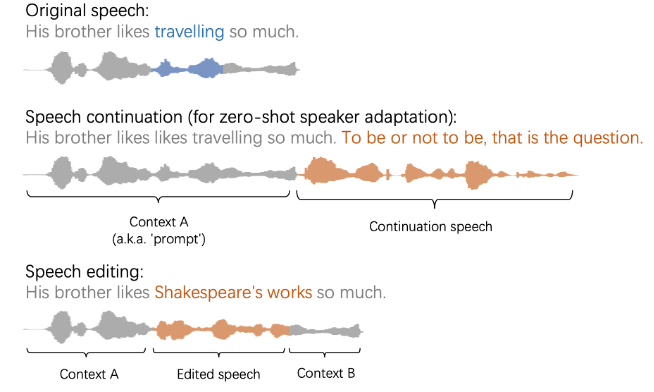
If the prosecution were withdrawn and the casesettled with the victim of the forged check, then the young man would be allowed his freedom. But under the circumstances I doubt if such an arrangement could be made.I remained there alone for manyhours, but I must acknowledge that before I leftthe chambers I had gradually brought myself to look at the matter in another light.目前已有多个工作通过从一个短语音片段(也称为语音prompt)使用自回归模型进行向后续写(Speech continuation)来实现TTS中的零样本说话人音色的克隆(Zero-shot Speaker Adaptation),例如较著名的VALL-E和SPEAR-TTS。同时,还有另一个需要考虑上下文语音的合成任务,即语音编辑(Speech editing)。语音编辑需要给定上文和下文的语音后,根据指定的文本合成中间部分的语音,同时保持和上下文语音的连贯衔接。这两个任务的图示如下:
当前的基于自回归(Auto-regressive, AR)的语音合成模型有三重困境。
首先,它们自回归的特性使得它们仅能从左向右单向生成,因此只能实现语音续写,对于同时需要考虑下文语音的语音编辑任务则难以实现。
此外,它们均使用语音编码(audio codec)模型所产生的acoustic token作为特征。这样的token需要在离散条件下描述整个巨大的声学空间,因此需要使用残差量化(Residual vector quantization, RVQ)的方式来实现。这样会导致每一帧语音都对应多个离散的index,使得生成任务变得非常复杂和困难。例如,VALL-E中在自回归模块之外,还引入了一个额外的非自回归(Non-auto-regressive, NAR)模块来生成残差的index。SPEAR-TTS中,将残差index展开到了一个序列,因此序列长度变为了数倍长,使得高质量建模变得更加困难。
最后,也是最重要的是,使用acoustic token会使得整个TTS系统的性能上限受制于audio codec模型的解码性能。而这样带来的性能损失是巨大的。所以,如何解决上述难题就成为了一个具有挑战性的问题。
三、UniCATS:一个统一的基于上下文语音的合成框架
我们提出UniCATS,在一个统一的框架下同时实现语音续写和语音编辑任务。它包括两个模块,称为CTX-txt2vec和CTX-vec2wav。
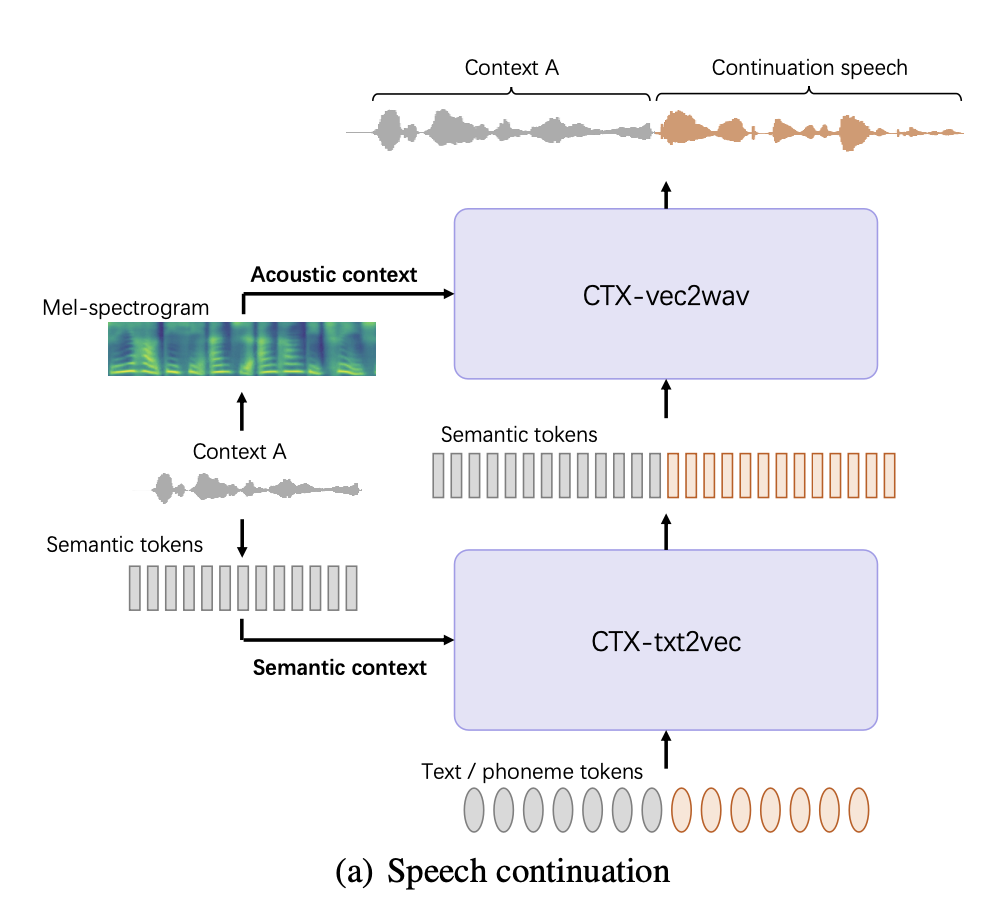
CTX-txt2vec根据文本或音素生成semantic token后,由CTX-vec2wav再从semantic token中生成语音。和acoustic token不同,semantic token是由用于语音识别的预训练模型提取的,例如vq-wav2vec, wav2vec 2.0, HuBERT等。因此,这样的特征中声学细节信息较少,其主要包含的是发音内容的信息,也没有使用残差量化。本文使用公开的预训练的vq-wav2vec作为semantic token的提取器。在UniCATS的合成过程中,CTX-txt2vec和CTX-vec2wav分别负责在semantic token层面和声学细节层面引入上下文信息。整个系统在语音续写和语音编辑任务下的流程图如下图所示:
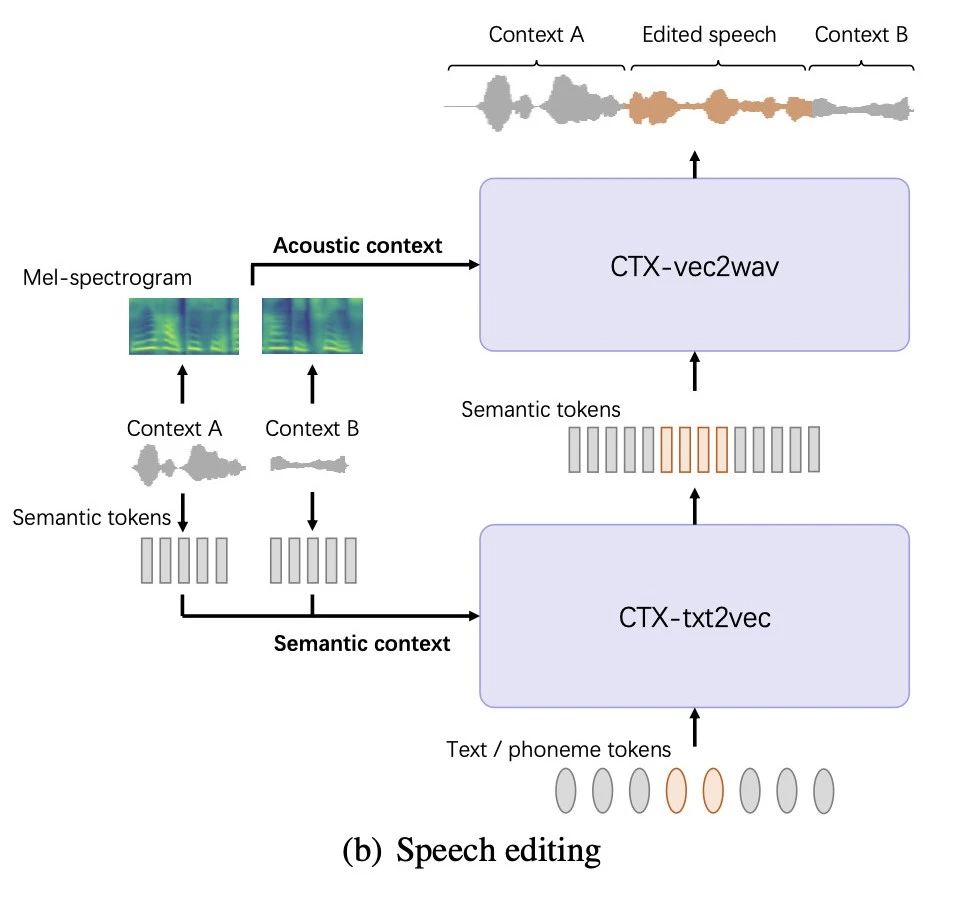
我们可以发现,我们使用了同一个UniCATS模型实现语音续写和编辑的合成流程。唯一的区别仅仅在于合成过程中是否提供下文信息。因此,UniCATS的推理算法中,仅需将语音编辑的算法中去除下文信息,即可轻松得到语音续写的算法。为了实现引入上下文信息的目标,我们在CTX-txt2vec和CTX-vec2wav中分别提出并使用contextual VQ-diffusion和contextual vocoding技术。下面我们详细介绍这两项技术的细节。四、Contextual VQ-diffusion
VQ-diffusion是一项使用扩散模型的思路来生成离散token序列的技术。和连续空间上的扩散模型不同点在于,它的数据破坏过程不是添加高斯噪声,而是对离散token逐渐进行mask和随机替换,最终使其信息完全丢失。生成过程则是相反,从完全被破坏的离散token序列中逐步重建出原始的数据。具体来说,VQ-diffusion的输入是经过破坏t步的离散token序列xt,输出则是预测的原始数据x0。生成过程中则通过已知的xt和预测的x0计算出xt-1的分布,再从中通过采样得到xt-1。进而,可以逐步迭代最终得到生成结果。
因为VQ-diffusion的输入xt和输出x0为长度相同的离散序列,因此VQ-diffusion的模型结构采用堆叠Transformer block的结构。
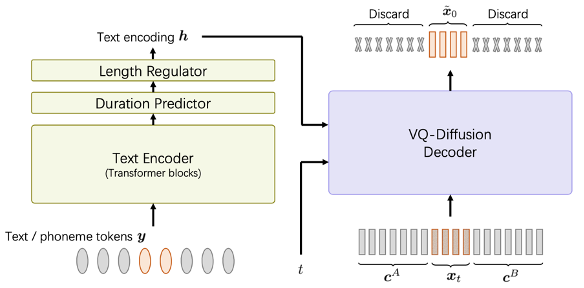
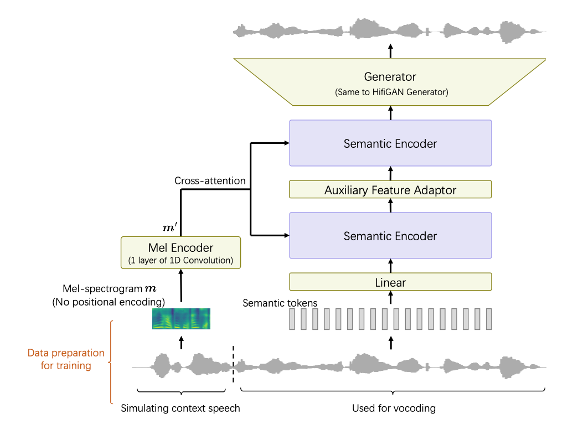
CTX-txt2vec的模型结构如上图所示。除了包含常规的文本encoder和时长处理模块,我们使用VQ-diffusion作为语音的semantic token的生成器。和既有的VQ-diffusion不同的是,我们需要基于上下文语音来进行生成。因此,我们对上文A和下文B的语音分别提取semantic token得到cA和cB后,将其按时间顺序拼接在输入xt的两侧,得到[cA, xt, cB]。我们将这个拼接后的序列作为我们的VQ-diffusion模块的输入。由于Transformer模型结构的特点,其输出序列和输入序列长度相同,我们仅使用xt部分对应的输出作为预测的x0,而cA和cB对应的输出部分则直接丢弃。这样,通过Transformer中的多头自注意力(multi-head self-attention)层,即可将上下文信息融合进生成过程。这个融合上下文信息的方法,我们称之为contextual VQ-diffusion。我们使用CTX-vec2wav从semantic token生成语音,其模型结构如下图所示。
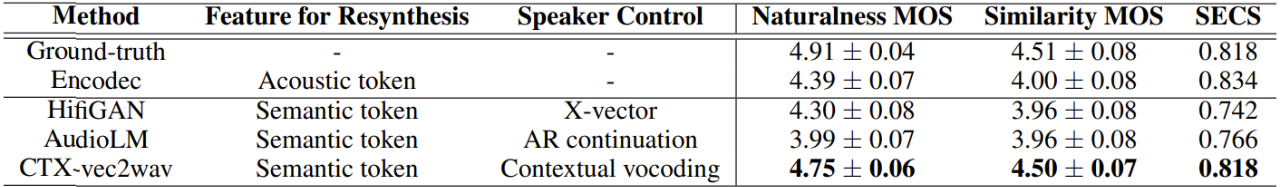
它基本上由2个结构相同的semantic encoder和一个HifiGAN的生成器组成。此外,我们使用上下文语音的梅尔频谱来提供从semantic token生成的语音过程中所需要的声学细节信息,尤其是说话人音色的细节。具体来说,CTX-vec2wav中的semantic encoder是由基于Conformer的模块组成的。和普通的Conformer不同的是,我们在其中添加了多头交叉注意力(multi-head cross-attention)层。上下文的梅尔频谱在经过一层简单的1D卷积层后,通过semantic encoder中的这些交叉注意力层,融合进语音的生成过程。这个方法,我们称之为contextual vocoding。考虑到有些数据集不带有说话人标签,或者说话人标签不准确,CTX-vec2wav使用完全无监督的训练方法。具体来说,我们假设训练数据中的每句语音内部的说话人均不变。我们将训练语音中每句话的前2~3秒截取出来,用于模拟上下文的语音,并提取梅尔频谱。再将剩下部分的语音提取semantic token用于语音反合成。反合成的过程中,使用前2~3秒的语音的梅尔频谱提供声学细节。需要指出的是,这里的梅尔频谱完全没有使用位置编码(position encoding),因此在交叉注意力层看来,它们只是一个没有顺序关系的特征向量的集合。因此,即便训练中仅使用了2~3秒的语音模拟上下文语音,在实际测试中可以使用任意长度的上下文语音,而不存在网络在训练和测试时不匹配的问题。我们使用LibriTTS数据训练UniCATS,并首先测试了CTX-vec2wav在从semantic token重构语音(Resynthesis)上的性能,并与HifiGAN和AudioLM进行了对比。实验发现,CTX-vec2wav不仅在自然度和说话人相似度上超越了两者,甚至优于从acoustic token进行语音重构的Encodec。
我们在基于语音续写的零样本说话人自适应任务上,我们将UniCATS与当前的SOTA模型VALL-E进行了对比,并发现实现了更优的性能。更有趣的是,UniCATS合成的自然度和说话人相似度依然优于使用Encodec进行语音重构的性能,而它是众多依赖于acoustic token的模型的性能上界。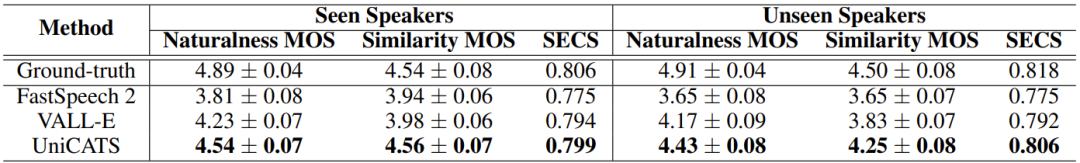
此外,在语音编辑任务上,相比于近期提出的语音编辑模型RetrieverTTS,我们也同样实现了更优的性能。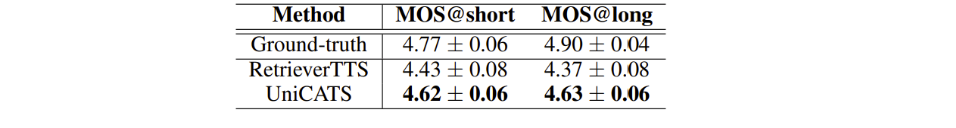

 语音小管家