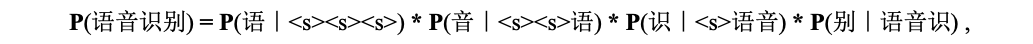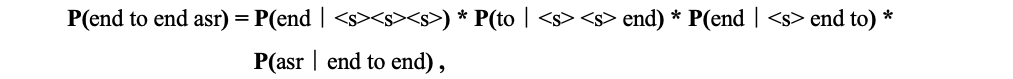3.1 WeNet GPU Runtime中使用
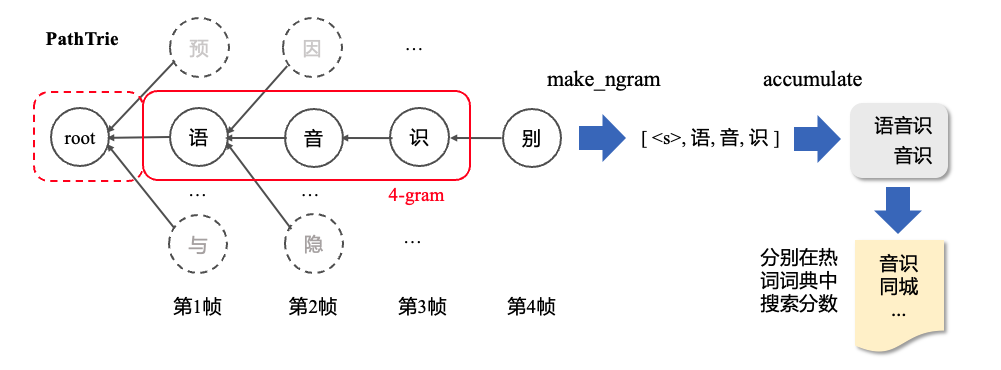
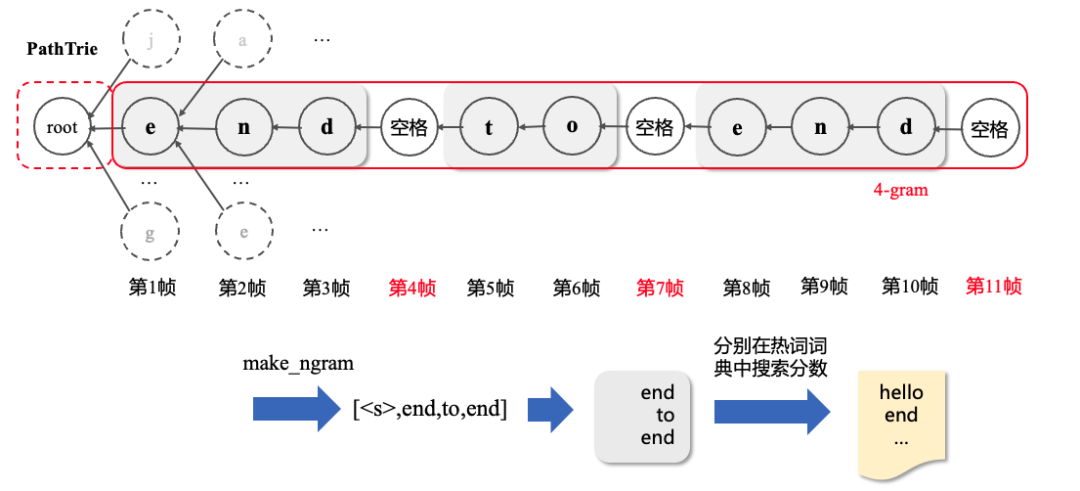
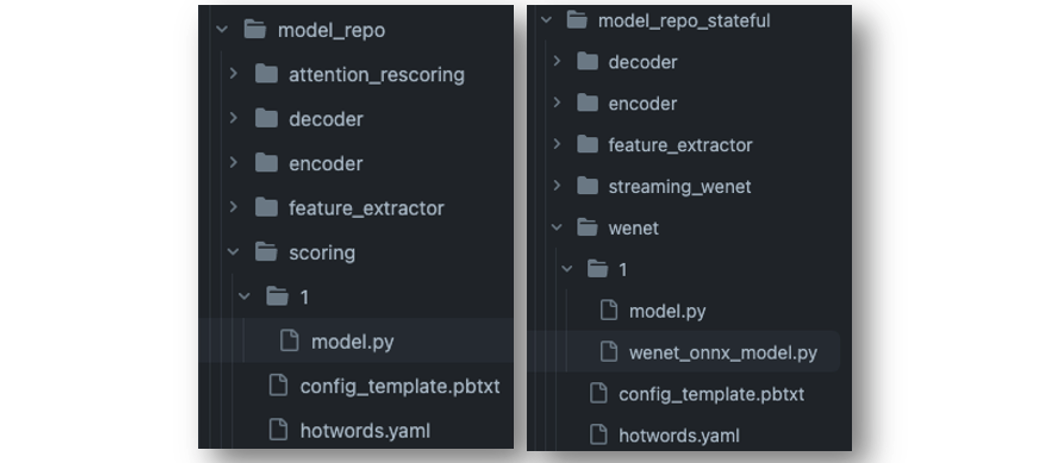
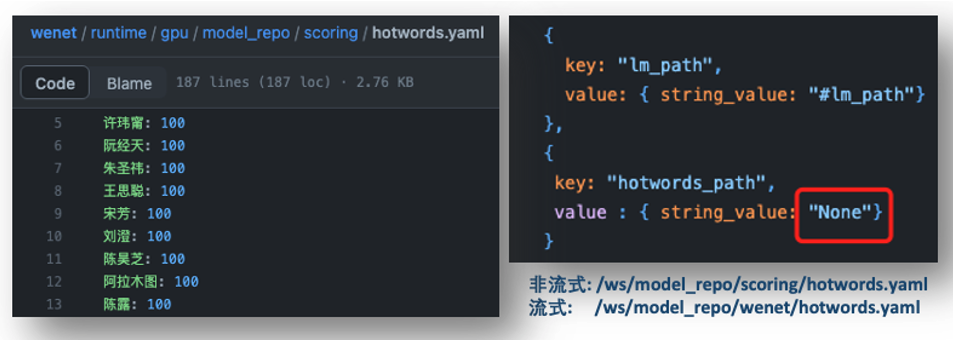
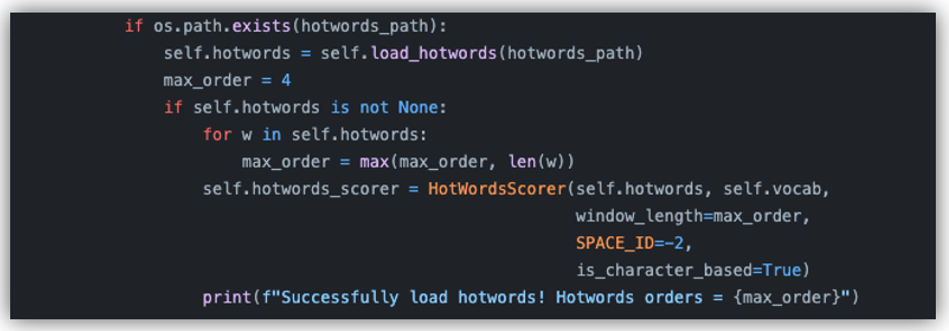
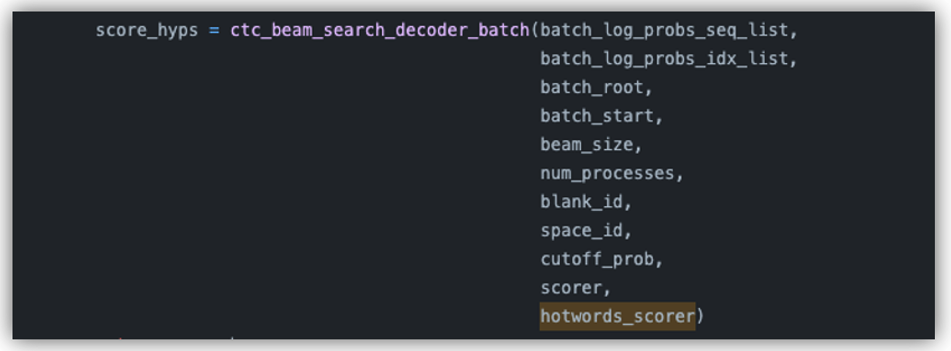
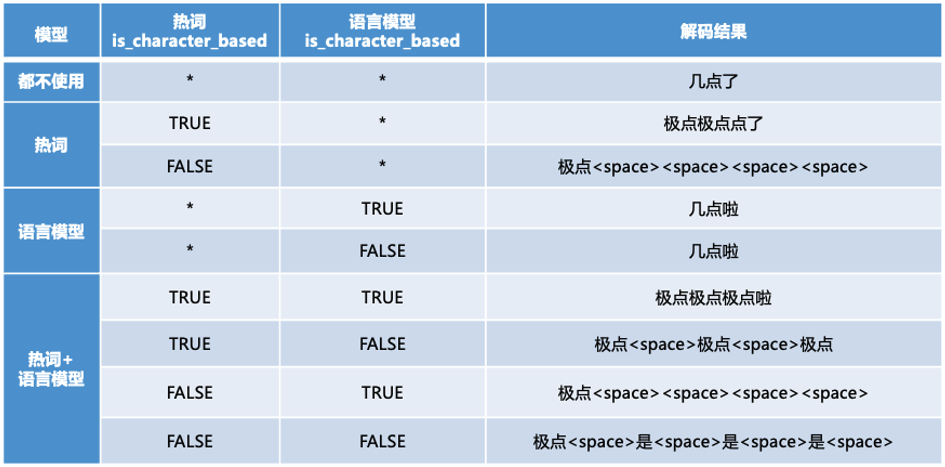
在WeNet GPU Runtime中,包含model_repo(非流式)和model_repo_stateful(流式)两个文件夹,我们主要修改scoring/1/model.py和wenet/1/wenet_onnx_model.py文件,使其能够使用热词增强。Step1:构造热词词典 hotwords.yaml,将其路径写在config.pbtxt文件中,服务会判断config.pbtxt中hotwords_path是否存在,如果存在则加载热词字典;Step2:根据已经加载的热词字典,自动确定热词的最大长度;Step3:初始化HotWordsScorer,初始化hotwords_scorer时必须输入热词字典和词汇表vocab,window_length默认长度为4,SPACE_ID为-2,is_character_based为True;Step4:将hotwords_scorer作为参数输入到ctc_beam_search_decoder_batch进行解码。接下来以一条音频为例,测试热词效果,可以参考ctc_decoder中的test_zh.py文件。在测试时,一些解码参数设置为:beam_size=10, blank_id=0, space_id=45,cutoff_prob=1(增大cutoff_prob概率使其能够输出空格字符),alpha=0.5, beta=0.5, window_length=4。热词为“极点”,权重为550(hot_words={'极点': 550}),如果想减少某些词出现的概率,可以设置为负值,权重的数据类型为float。从上表的解码结果来看,加入热词“极点”后,都能够解码出该词。注意,在语言模型is_character_based为False时,这时候使用热词时,需要确保热词在语言模型unigram中或者作为unigram的前缀。因为当语言模型is_character_based为False时,首先会将语言模型unigram词用fst进行存储,然后在解码过程中,每一帧生成的新前缀要在fst中找到一条路径才会生成出真的有效前缀。3.2 经验之谈
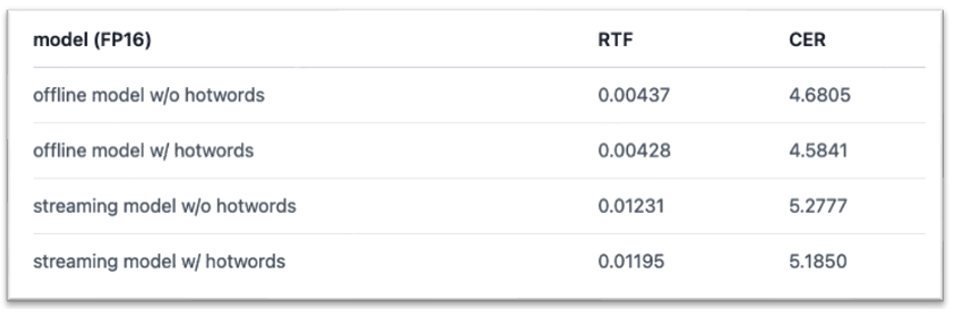
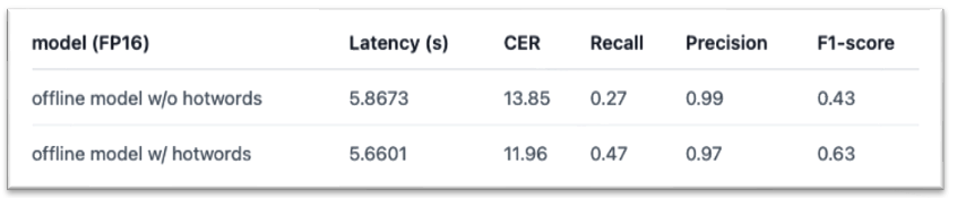
1、在使用WeNet GPU Runtime时,启动tritonserver服务可以添加--model-control-mode=poll --repository-poll-secs=60参数,可以实时热加载热词文件;2、面对业务场景比较多时,可以设置分业务场景做热词增强。第一种方案是将scoring模块复制几份得到scoring1,scoring2等,然后再将attention_rescoring复制几份得到attention_rescoring1,attention_rescoring2等,不同的业务场景请求不同的attention_rescoring;第二种方案为在ctc_beam_search_decoder_batch解码时,遍历每一个业务线分别进行解码。3、在使用热词时,先要确定声学模型输出的top beam_size(默认beam_size=10)汉字中有无热词中的汉字,如果没有可以使用TTS合成一部分数据来微调声学模型,或者增大beam_size(10->20);4、解码器在解码搜索时,在每帧只会保存beam_size条最优路径,有可能加了热词,但是包含热词的路径在中间某一步被剪枝了,这种情况可以增大beam_size(10->20),但是解码耗时会有些上升;5、一般热词权重设置到10左右,可以先对热词设置一个比较大的权重,看看能否解码出热词,然后再逐步减少权重直到找到最低权重。6、ctc_decoder中默认的空格为“ ”,如果训练声学模型时将空格用“_”或者“”进行表示,需要将空格[6]改为对应符号。7、在热词实现2.1节Step2的例子中,我们选择使用了[语音识,音识]的组合方式,当然此处也可以使用 [语音识,语音]的组合,但测试效果不如前者。我们分别在AISHELL-1的测试集[7]上,以及AISHELL-1热词测试子集[8]上进行了热词实验,分别对流式与非流式服务是否使用热词进行了比较。实验结果如下:AISHELL-1 hostwords sub-testsets
实验结果显示,增加热词可以在几乎不影响解码速度的情况下修复badcase,提升测试集整体准确率。热词文件以及详细实验结果可以参考[9]。2. 支持语言模型部分神经网络语言模型和ngram语言模型一起打分;参考资料
[1] https://github.com/wenet-e2e/wenet/pull/1860
[2] https://github.com/Slyne/ctc_decoder
[3] ctc_decoder/swig/scorer.cpp#LL176C34-L176C44
[4] ctc_decoder/swig/hotwords.cpp#L43
[5] ctc_decoder/swig/hotwords.cpp#LL91C9-L91C9
[6] ctc_decoder/swig/scorer.cpp#L166
[7] https://www.openslr.org/33/
[8]https://www.modelscope.cn/datasets/speech_asr/speech_asr_aishell1_hotwords_testsets
[9] https://huggingface.co/58AILab/wenet_u2pp_aishell1_with_hotwords
作者介绍
杨焦,58同城TEG-AI Lab语音算法部算法高级工程师,主要负责端到端语音识别模型开发、语音识别GPU服务开发与性能优化等工作。周维,58同城TEG-AI Lab算法架构师,语音算法部负责人,负责语音识别、语音合成算法研发。
 语音小管家