在语音和一般音频场景下,自监督学习 (SSL) 已经显示出了强大的表征能力。但通过 SSL 方法表征音乐音频仍是一片亟待探索的「蓝海」。
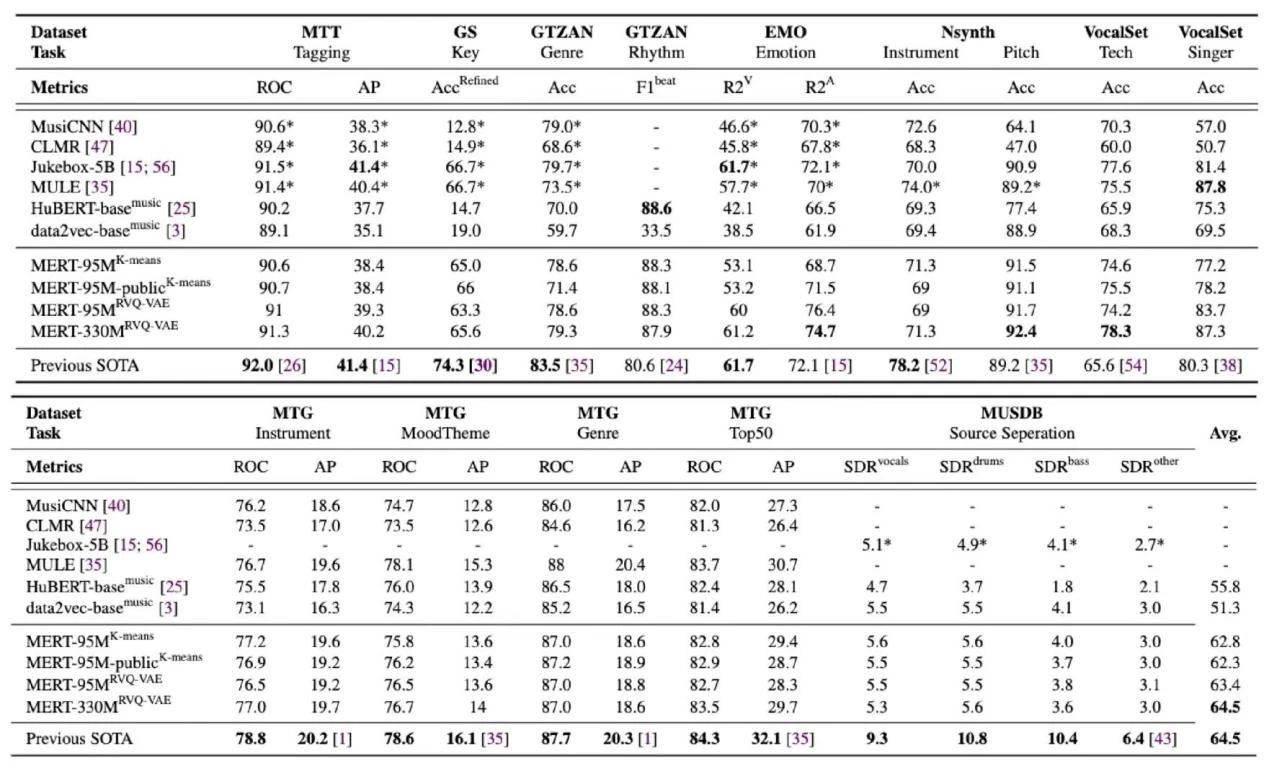
近期,北京智源人工智能研究院联合英国谢菲尔德大学、CMU、密歇根大学、纽约大学、香港科技大学等顶尖高校提出了大规模自监督声学音乐理解模型MERT。该模型基于残差向量量化的声学变分自动编码器 (RVQ-VAE) 和常量 Q 变换 (CQT) 提取了两种音乐信息特征,并将其作为伪标签用于掩码语言建模 (MLM)预训练。这些伪标签能够指导训练 BERT 风格的transformer编码器。实验结果表明,MERT模型在 14 项音乐理解任务上表现良好,获得了目前最先进 (SOTA) 的总分。音乐是一种特殊的语言,它能够让不同文化背景的人们相互交流。音乐信息检索(MIR)是人工智能与艺术的一个交叉领域,涉及到音乐标签、节拍跟踪、音乐转谱、声源分离等重要子任务。音乐信息检索技术具有巨大的应用价值,其应用场景包括:改善音乐推荐效果,促进音乐产业蓬勃发展;促成 AI 辅助练琴,为音乐教育提供便利;查找相同和弦进行的流行音乐,为音乐创作和维权提供帮助;保护文化多样性和音乐遗产等。然而,受限于标注数据的质量和规模,有关的 AI 算法(特别是深度学习方法)研究也面临巨大瓶颈。一方面,由于版权问题,音乐数据通常不能随意使用;另一方面,音乐信息标注门槛较高,只有受过专业训练的人才能完成该工作。如果能够使用更广泛的音乐数据训练算法,将有助于研发新的音乐检索系统。预训练语言模型 (PLM) 技术可通过自监督学习 (SSL) 方式在没有人工注释的数据上学习通用表示,在自然语言处理领域取得了惊艳的效果。音乐和语言有较强的内在相似性,基于预训练语言模型的相关方法可能同样适用于标注数据集受限的音乐信息检索任务。本文首先基于预训练大模型开发出一种普适的音乐表征,进而在下游任务的小型数据集上微调即取得优异的性能,大幅减少了对标注数据规模的依赖。在这一领域中,大多数现有研究主要针对「为音乐打标签」展开,缺乏对其他任务的关注。此外,许多预训练模型并未提供开源代码库或模型参数,难以进一步评估。虽然OpenAI 的音乐生成模型 Jukebox的参数或许也适用于音乐信息检索任务,但6B 的模型参数却让人望而却步。相关研究依然处于起步阶段。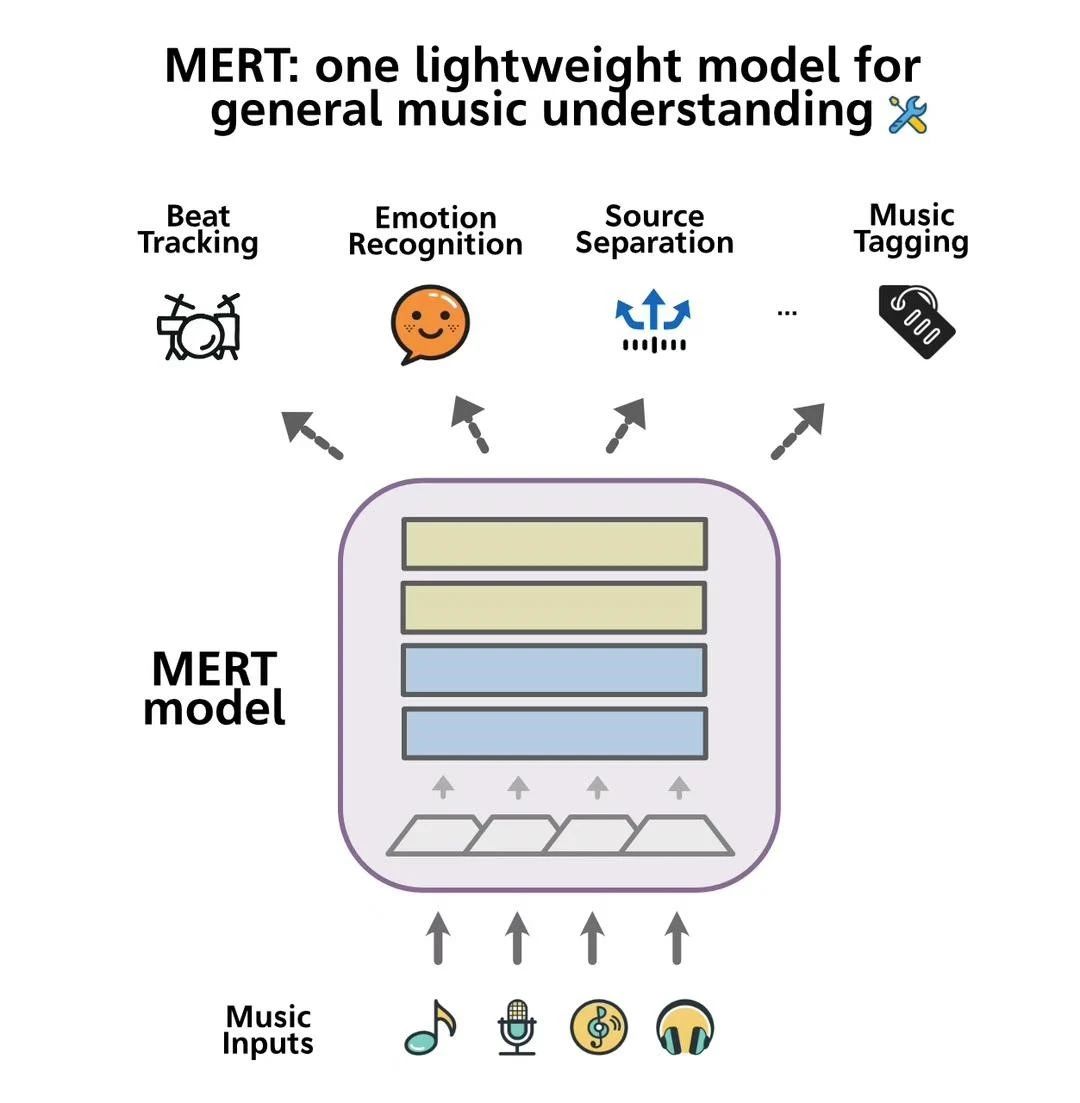
图注: MERT 模型可以把音乐输入转换成多种不同音乐信息检索输出
为此,本文提出了《MERT: Acoustic Music Understanding Model with Large-Scale Self-supervised Training》,首次填补了相关任务上的空白。文章开创性地介绍了一种新的自监督音乐理解模型(MERT),该模型在 14 种音乐信息检索任务上实现了最先进的 (SOTA) 性能。与以前的方法不同,MERT 仅使用一个消费级 GPU 即可实现即时推理,还能高效处理序列标记任务(例如,节拍跟踪和声源分离等)。目前,模型已在 huggingface上获得了数万下载量。相关论文和代码链接如下:论文:
https://arxiv.org/abs/2306.00107
https://[github.com/yizhilll/MERT](http://github.com/yizhilll/MERT%E3%80%82)https://huggingface.co/spaces/m-a-p/Music-Descriptor
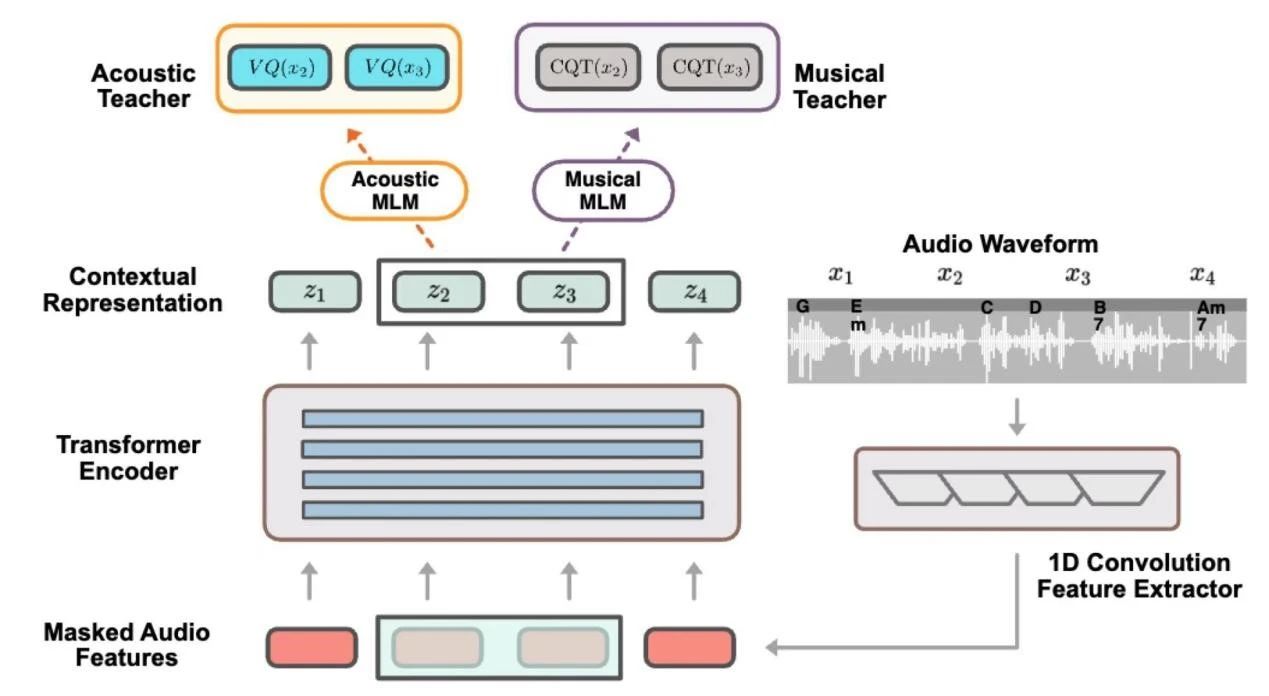
就数据而言,音乐音频包含声学和音高等不同维度的信息。为了同时建模上述两种特征,MERT采用基于残差向量量化的声学特征 - 变分自编码器 (RVQ-VAE) 和基于常量 Q 变换 (CQT) 的音乐特征构造预训练伪标签。BERT 式转换器(transformer)编码器通过上述特征对16 万小时的音乐录音进行建模。为了增强音乐表征的鲁邦性,本文引入了 batch 内噪声混合技术,即使存在不相关音频的情况下,它也有助于模型学习更鲁棒的表征。此外,本文探索了 Transformer 和 1D 卷积编码器的各种设置,以克服声学模型预训练期间的不稳定性,将 MERT 模型的参数规模从 95M 扩展到 330M。实验结果表明,MERT 模型效果超过了很多基线预训练模型和针对具体任务设计的方法,在多个下游任务上取得了 SOTA 的结果。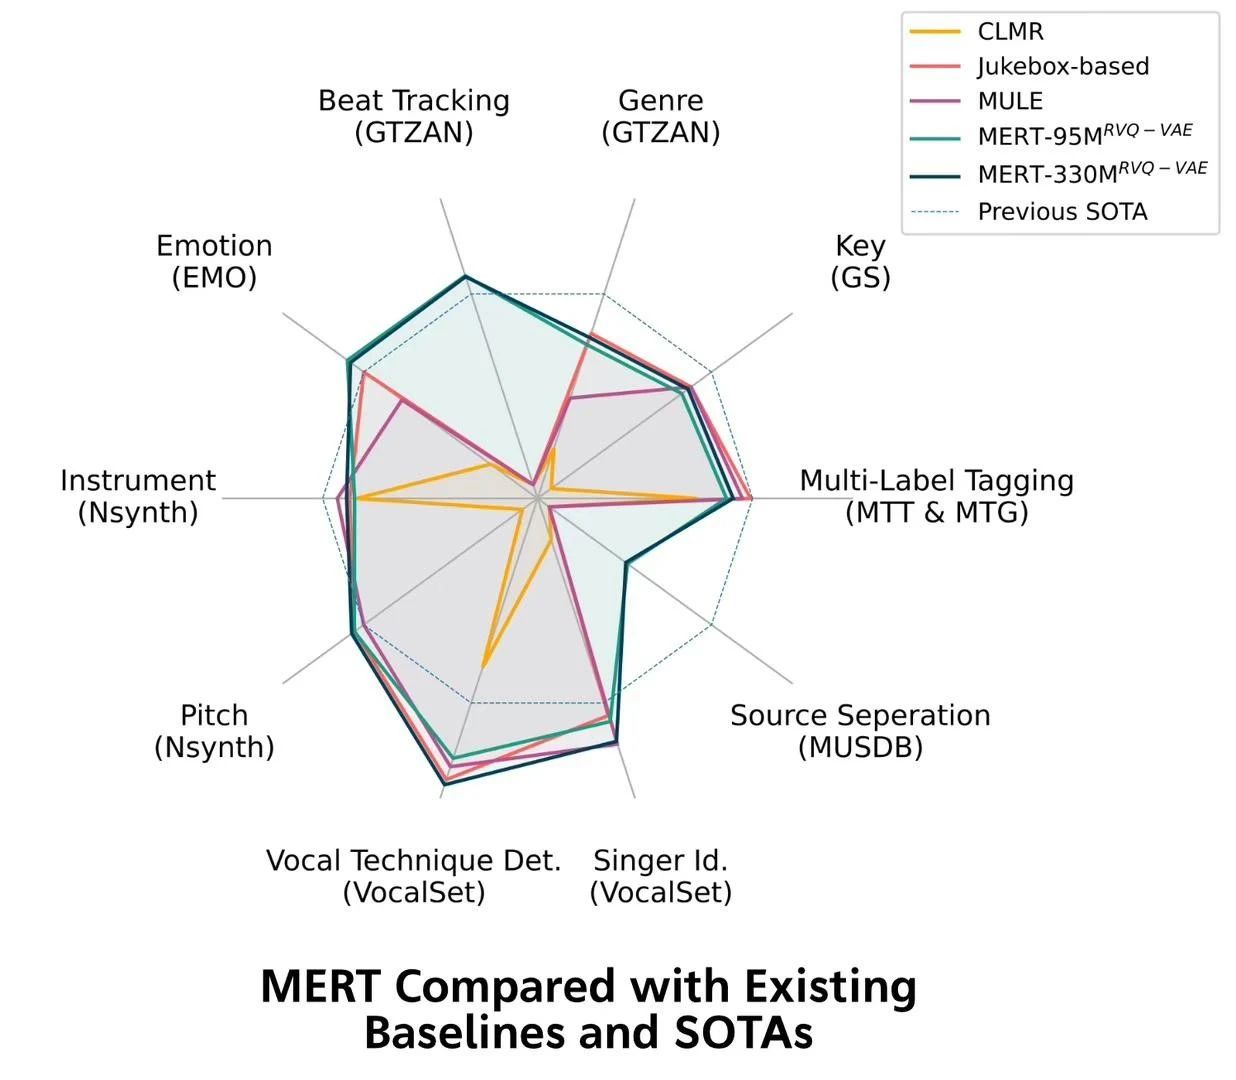
MERT 模型为音乐理解提供了一种多功能轻量级的解决方案,提供了统一各种音乐信息检索任务的建模,让版权数据受限或缺乏手动注释的情况下的音乐知识探索成为可能,是音乐理解领域的重大进步。研究人员已经发布了 MERT 的代码和模型,让研究和行业社区能够探索和利用这个强大的工具。此外,MERT 背后的Multimodal Art Projection(MAP)团队致力于推进开源音乐表征学习和音乐生成,并计划发布通用音乐理解评估工具包、协议和排行榜,作为即将推出的MARBLE Benchmark 的一部分。该基准涵盖广泛的音乐理解任务,极大的方便了后续音乐信息检索的研究。该团队核心成员囊括了来自世界各地的精英,包括谢菲尔德大学林成华教授及李一之,北京智源人工智能研究院(BAAI)的付杰博士,滑铁卢大学的张舸,卡内基梅隆大学的Roger Dannenberg教授和袁锐斌,香港科技大学 (HKUST) 的雪巍教授和伦敦玛丽女王大学 (QMUL) 的 Emmanouil Benetos 教授和马英浩。而 MERT 是该团队的开山之作。展望未来,研究人员的长期目标是开发音乐音频生成模型——该模型不仅可以实现无条件音乐生成,还可结合文本和图像输入进行多模态交互控制。后续发展也将进一步扩展 MERT 的能力和应用。 语音小管家