
 语音小管家
自2017年发明以来,基于神经网络的Transformer架构在不同的人工智能任务中取得了巨大成功。转换器体系结构通常可以分为三组:encoder-decoder体系结构、encoder-only体系结构和decoder-only体系结构。例如,在原始Transformer论文“Attention Is All You Need”中开发的用于解决语言翻译问题的Transformer使用encoder-decoder架构,曾经非常流行的基于Transformer架构的模型BERT能够处理各种不同的自然语言任务,使用encoder-only的架构,著名的OpenAI GPT系列模型,如ChatGPT,已被证明具有很好的人工通用智能,使用decoder-only架构。
基于Transformer结构的神经网络,特别是那些大型语言模型,通常有数十亿个参数。因此,即使是在大规模的预训练Transformer模型中运行推理也是一个挑战。在本文中,我想从数学的角度讨论如何优化Transformer自回归推理,特别是对于encoder-decoder架构和decoder-only架构的Transformer。
Transformer Autoregressive Inference Computational Complexity
 在固定时间内运行的操作。因此,要运行自回归推理 n 次对于递归神经网络,其推理渐近计算复杂度为
 .
 。因此,要运行自回归推理 n 对于Transformer decoder,其推理渐近计算复杂度为
 , 这是我们通常负担不起的。
 降低到
 。因此,对于transformer decoder运行n次自回归推理,推理的渐近计算复杂度可以从原来的
 降低到
 。
Transformer Autoregressive Inference Optimization
我们将在 Transformer 体系结构中的每一层类型中检查和优化transoformer自回归解码,例如masked self-attention head、编码器-解码器体系结构中使用的cross-attention head 和 multi-head attention layer。事实证明,通过适当的缓存,每种类型的层的推理都是增量的,也就是说,向每一层添加一个新的输入令牌不会影响前一个输入令牌的输出。因此,在时间步长n时,我们只需要提供一个令牌而不是n个令牌,并且只计算与该令牌相关的注意力,这大大降低了自回归推理成本。
Masked Self-Attention Head (decoder)
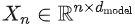 ,其中 n 为解码器的输入token个数,
 为每个令牌的注意特征个数。masked self-attention 的参数为: query 特征变换
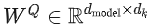 ,key特征变换
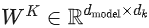 ,value特征变换
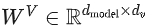 ,其中
 为注意力头中每个令牌的query或key特征的个数,
 为注意头中每个令牌的值特征的个数。masked self-attention head的输出张量是一个注意张量
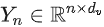 。
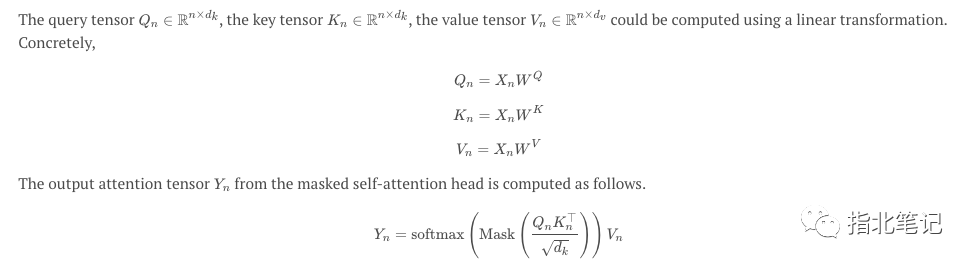
Qurey:
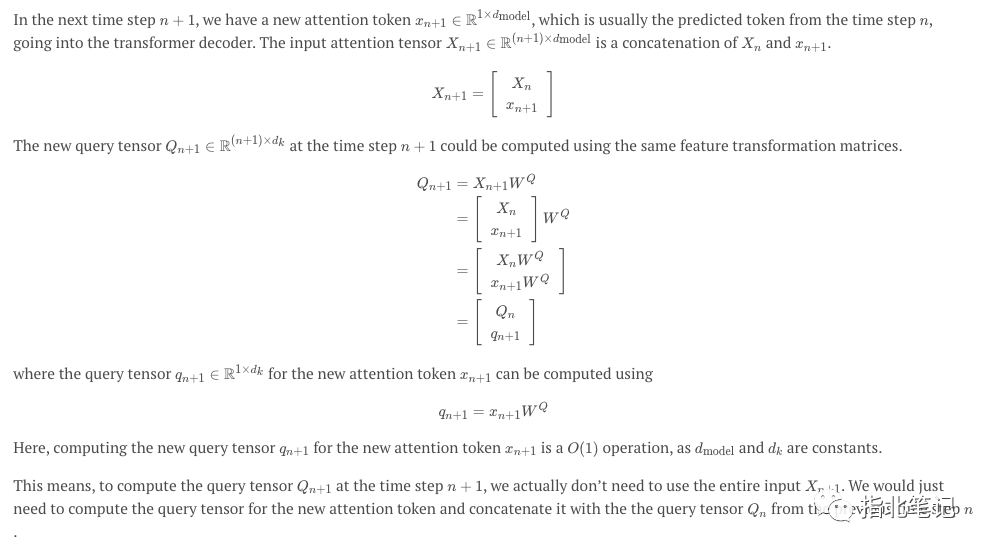
Key:
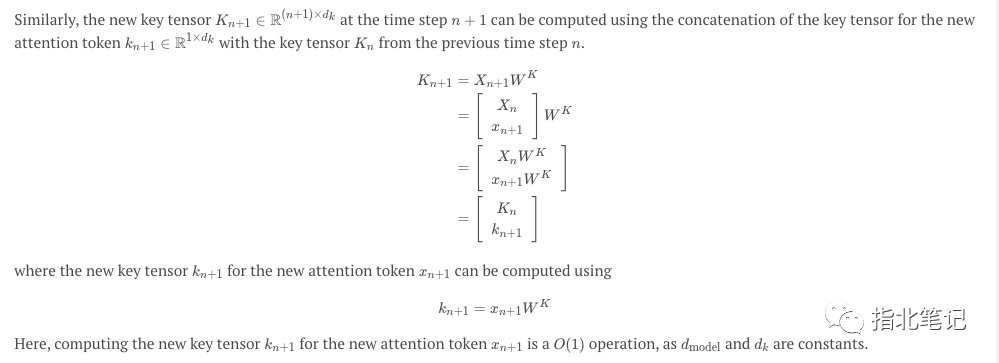
Value:
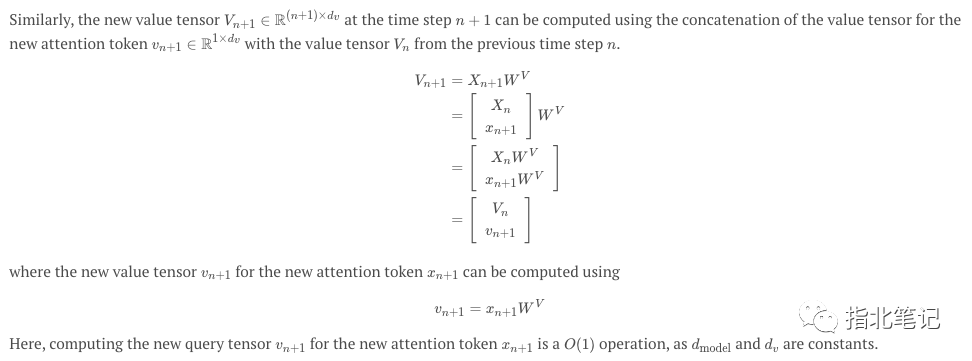
Output:
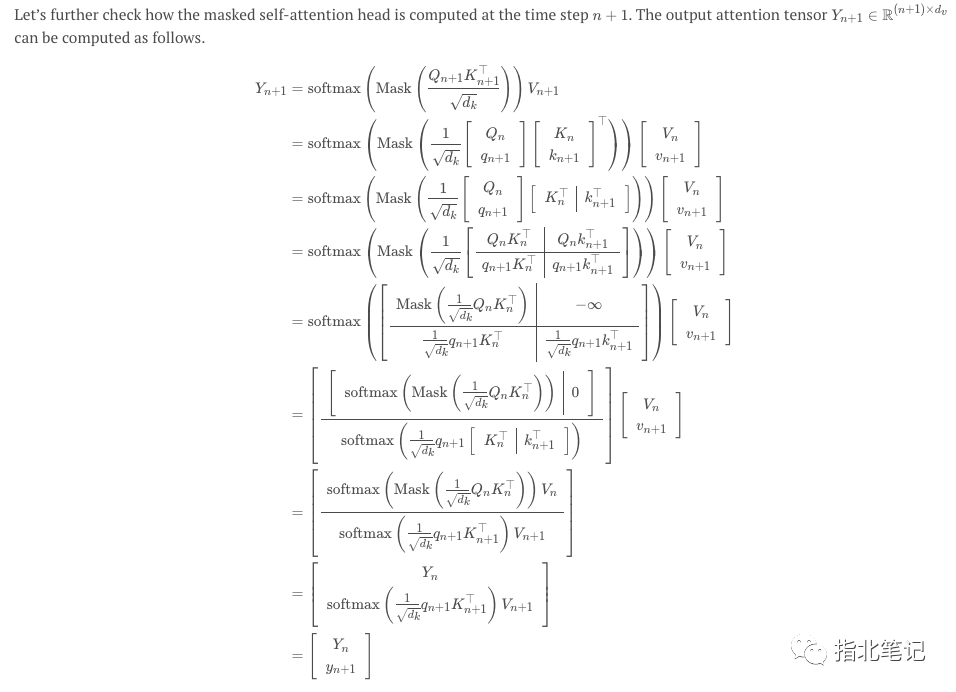
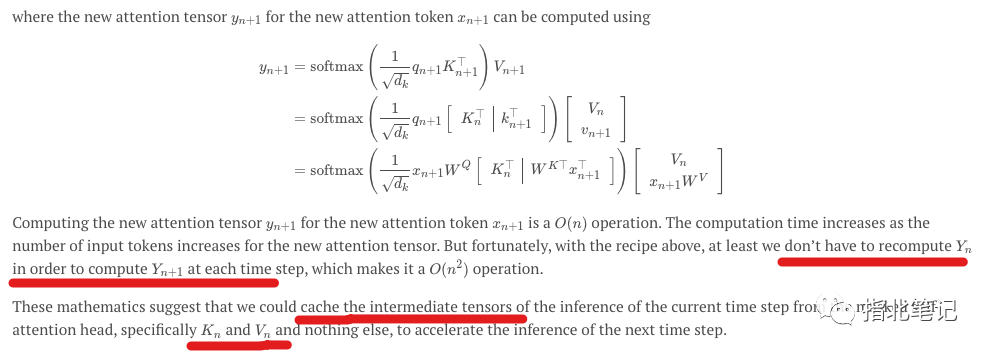
需要 cache 。 是下一层的输入。
Cross Attention Head (encoder-decoder)
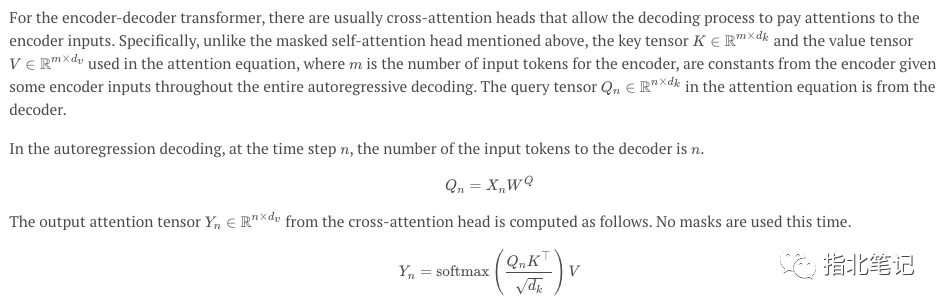
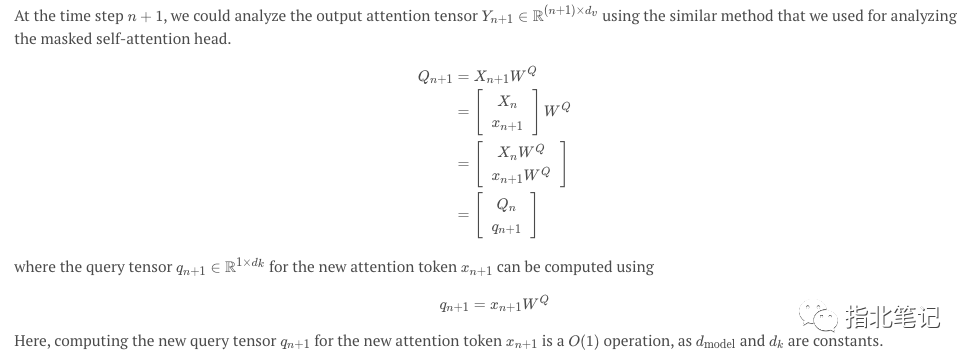
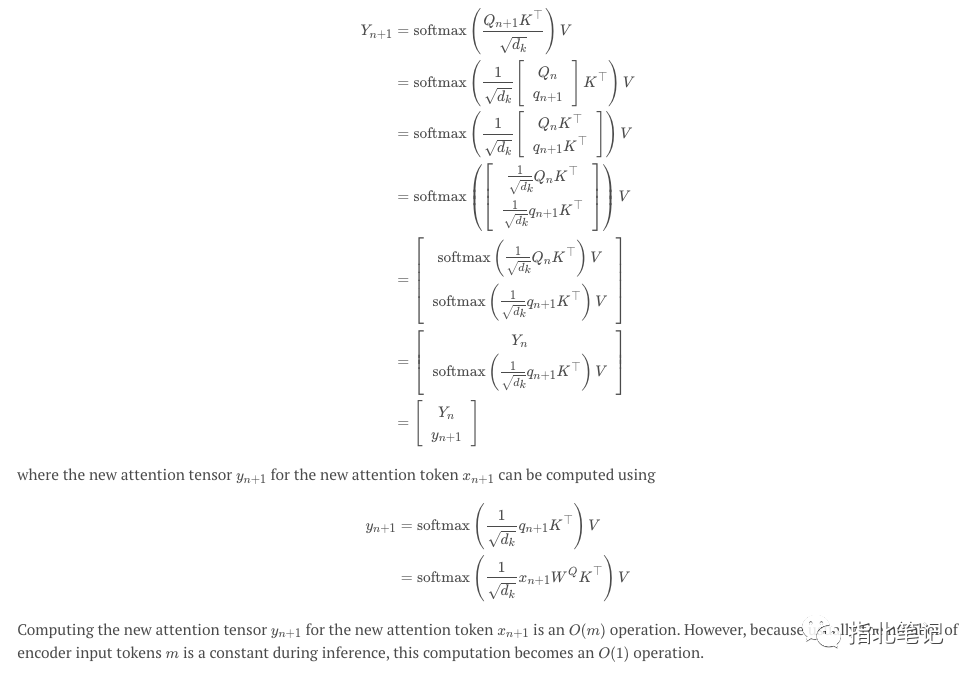
Multi-Head Attention
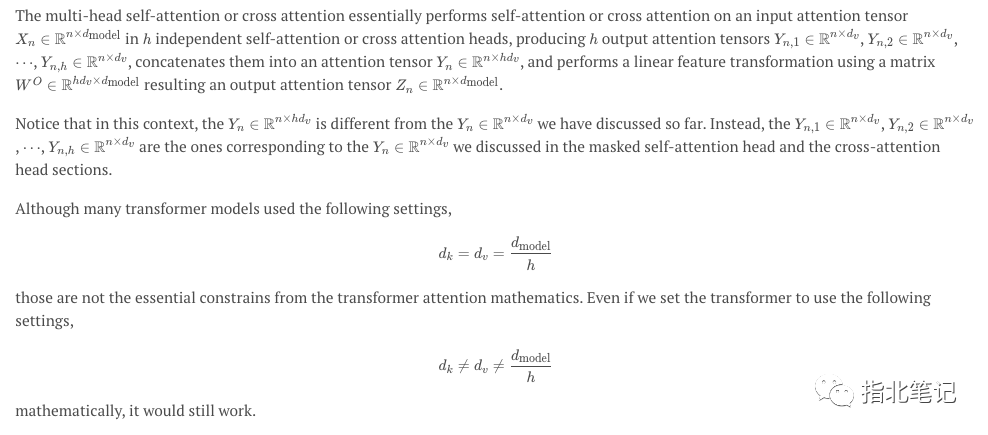
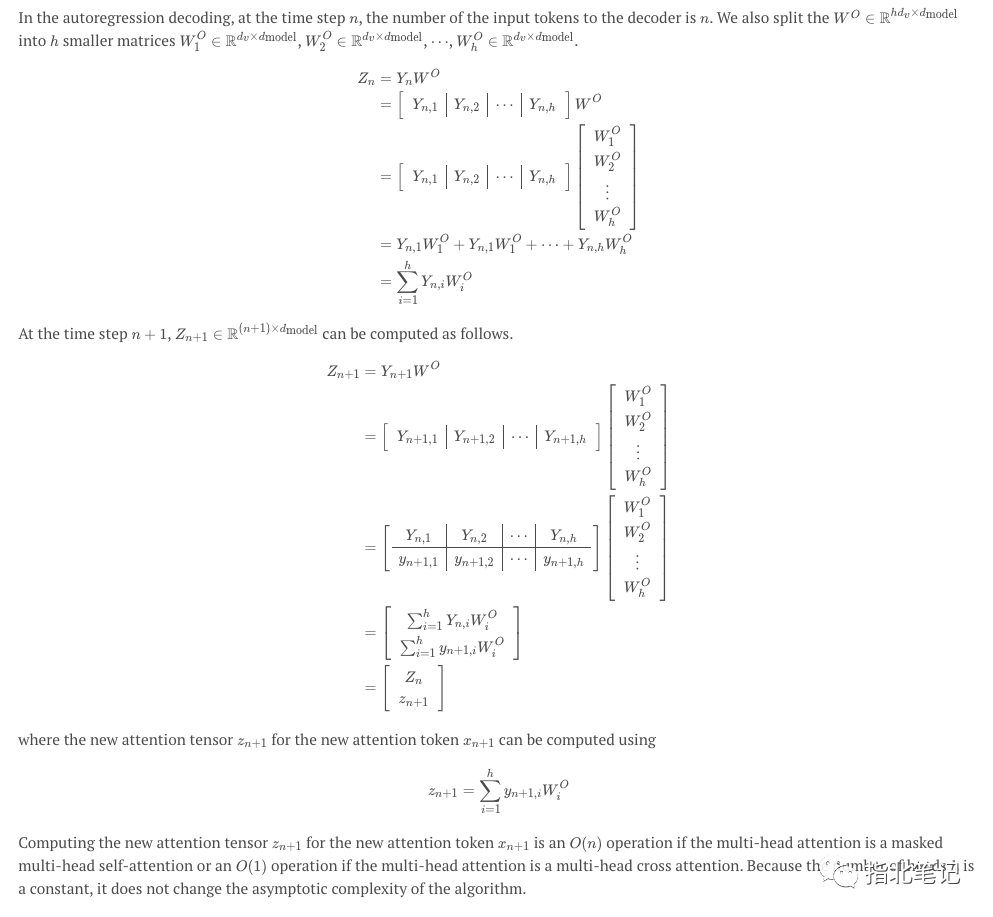
Other Layers
Layer normalization层,feed forward层,最终的softmax层等,在单个token特征上执行。很明显,我们只需要在每个时间步骤上计算新注意力token的输出张量,而不必重新计算前一个时间步骤的注意力标token。
Conclusions
 的推理渐近计算复杂度。
 内运行n次自回归推理仍然非常昂贵。这就是为什么在商业应用中允许的token数量通常是有限的。例如,ChatGPT只允许token的数量为几千。这也意味着,如果用户与ChatGPT交谈太多,ChatGPT将无法从对话开始一直回顾上下文。
