
 语音小管家
最近小米k2社区发布了vits语音合成模型,作者基于k2社区csukuangfj的onnx模型导出代码,实现了onnx模型的流式推理代码,大大提升了VITS语音合成的响应速度,50个字的首包延迟在400ms左右。
项目地址
https://github.com/PlayVoice/vits_chinese
具体实现
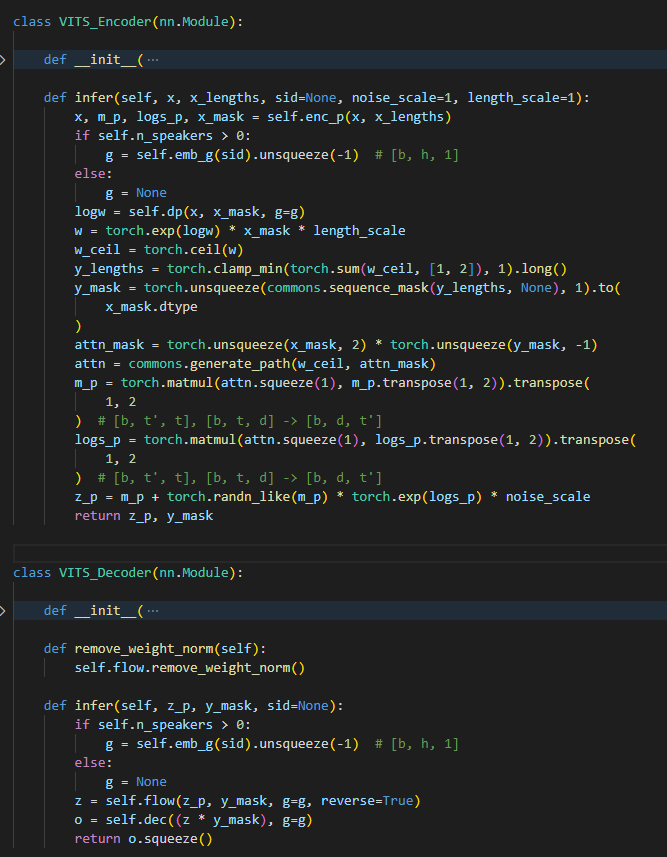
Encoder包括TextEncoder与DurationPredictor等; Decoder包括ResidualCouplingBlock与Generator等; 并且将推理逻辑也进行了切分;特别的,先验分布的采样过程: z_p = m_p + torch.randn_like(m_p) * torch.exp(logs_p) * noise_scale 放在了Encoder中。
class OnnxModel_Encoder(torch.nn.Module):
    def __init__(self, model: VITS_Encoder):
        super().__init__()
        self.model = model

    def forward(self, x, x_lengths, noise_scale=1, length_scale=1):
        return self.model.infer(
            x=x,
            x_lengths=x_lengths,
            noise_scale=noise_scale,
            length_scale=length_scale,
        )


class OnnxModel_Decoder(torch.nn.Module):
    def __init__(self, model: VITS_Decoder):
        super().__init__()
        self.model = model

    def forward(self, z_p, y_mask):
        return self.model.infer(
            z_p=z_p,
            y_mask=y_mask,
        )


def add_meta_data(filename: str, meta_data: Dict[str, Any]):
    """Add meta data to an ONNX model. It is changed in-place.

    Args:
      filename:
        Filename of the ONNX model to be changed.
      meta_data:
        Key-value pairs.
    """
    model = onnx.load(filename)
    for key, value in meta_data.items():
        meta = model.metadata_props.add()
        meta.key = key
        meta.value = str(value)

onnx.save(model, filename) 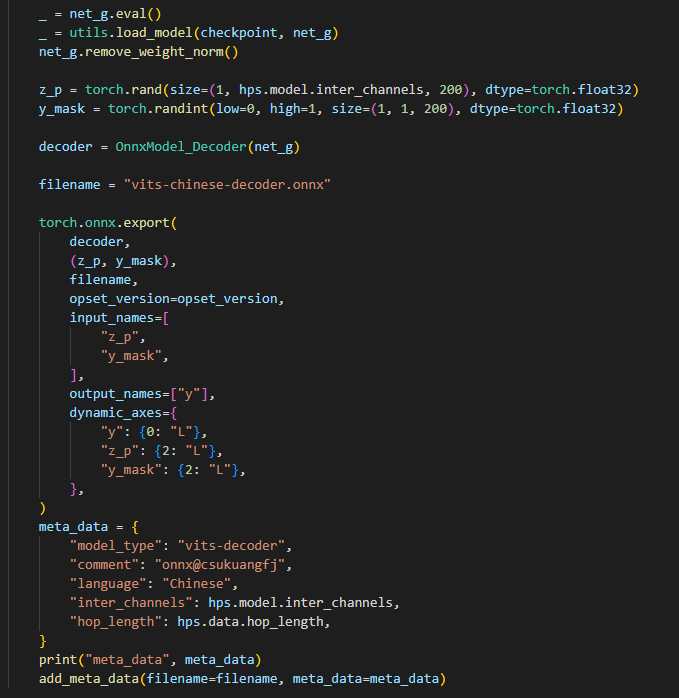
onnx流式推理
class OnnxModel_Encoder:
    def __init__(
        self,
        model: str,
    ):
        session_opts = onnxruntime.SessionOptions()
        session_opts.inter_op_num_threads = 1
        session_opts.intra_op_num_threads = 4

        self.session_opts = session_opts

        self.model = onnxruntime.InferenceSession(
            model,
            sess_options=self.session_opts,
        )
        display(self.model)

        meta = self.model.get_modelmeta().custom_metadata_map
        self.add_blank = int(meta["add_blank"])
        self.sample_rate = int(meta["sample_rate"])
        print(meta)

    def __call__(self, x: torch.Tensor):
        """
        Args:
          x:
            A int64 tensor of shape (L,)
        """
        x = x.unsqueeze(0)
        x_length = torch.tensor([x.shape[1]], dtype=torch.int64)
        noise_scale = torch.tensor([1], dtype=torch.float32)
        length_scale = torch.tensor([1], dtype=torch.float32)

        z_p, y_mask = self.model.run(
            [
                self.model.get_outputs()[0].name,
                self.model.get_outputs()[1].name,
            ],
            {
                self.model.get_inputs()[0].name: x.numpy(),
                self.model.get_inputs()[1].name: x_length.numpy(),
                self.model.get_inputs()[2].name: noise_scale.numpy(),
                self.model.get_inputs()[3].name: length_scale.numpy(),
            },
        )
        return z_p, y_mask


class OnnxModel_Decoder:
    def __init__(
        self,
        model: str,
    ):
        session_opts = onnxruntime.SessionOptions()
        session_opts.inter_op_num_threads = 1
        session_opts.intra_op_num_threads = 4

        self.session_opts = session_opts

        self.model = onnxruntime.InferenceSession(
            model,
            sess_options=self.session_opts,
        )
        display(self.model)

        meta = self.model.get_modelmeta().custom_metadata_map
        self.hop_length = int(meta["hop_length"])
        print(meta)

    def __call__(self, z_p, y_mask):
        y = self.model.run(
            [
                self.model.get_outputs()[0].name,
            ],
            {
                self.model.get_inputs()[0].name: z_p,
                self.model.get_inputs()[1].name: y_mask,
            },
        )[0]
return y 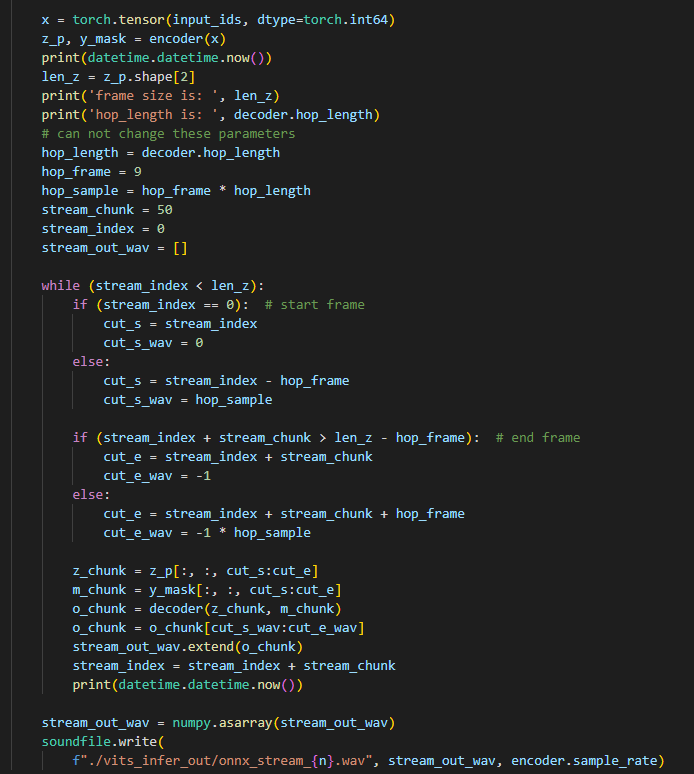
参考资料
