
 语音小管家
近期,该项目开源了一个庞大的完全清理过的预训练数据集 TxT360(万亿级提取文本),通过合并和去重 99 个 CommonCrawl 数据集和 14 个来自不同领域的高质量数据源(如FreeLaw、PG-19、StackExchange、Arxiv等)创建而成,这些数据来自法律、文学作品等领域。目前,TxT360 在 Hugging Face 上排名第一,击败了 22 万多个数据集(截至 2024 年 10 月 18 日)。
TxT360:https://huggingface.co/spaces/LLM360/TxT360
TxT360 专注于干净的数据和精确的控制,为 LLM 预训练者提供了开箱即用的丰富数据集,并提供了一个上采样配方(upsampling recipe),可创建超过 15 万亿个 token,足以训练最大的模型。
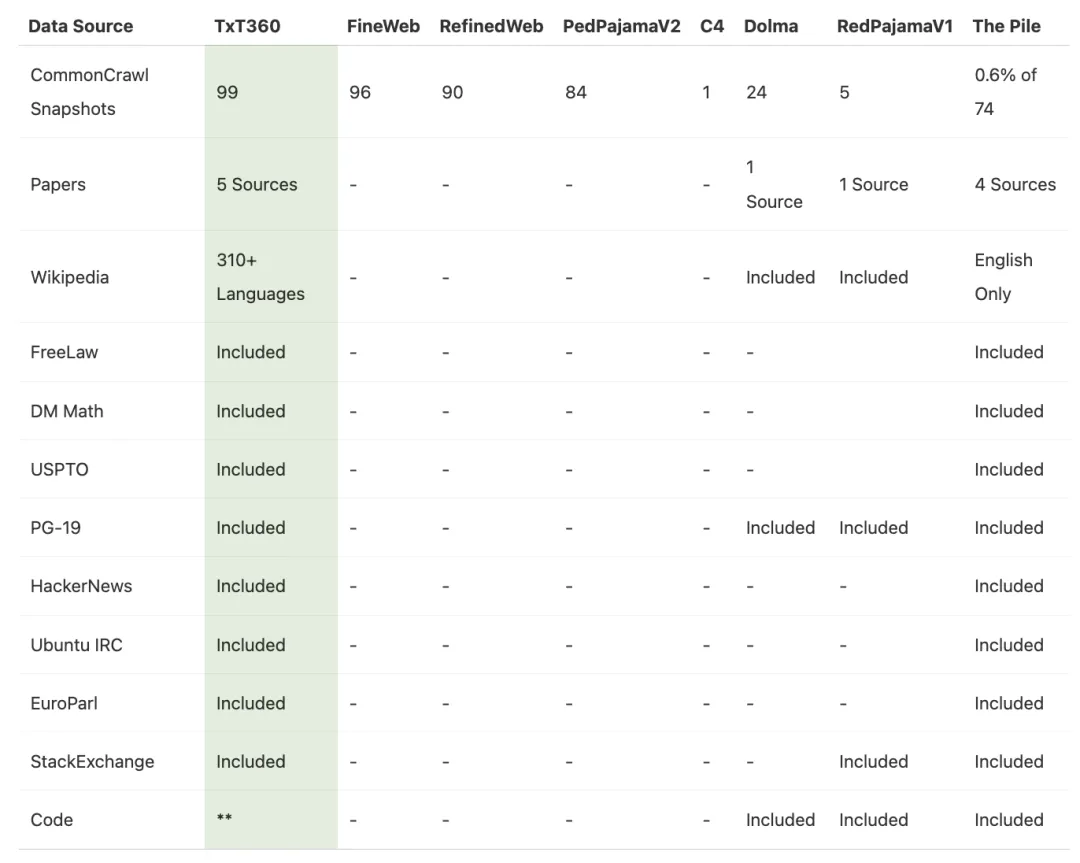
在多个关键指标上,TxT360 超越了同类数据集,同时存储了丰富的元数据,使预训练者能够对数据分布进行精确控制,从而探索更先进的权重调整技术。
要知道,大型语言模型需要万亿级的 token 数据,开发者通常通过组合多个不同数据集来创建这些数据。用于训练的数据集通常专注于一个来源,如爬取网页、代码库、论文或音频/视频转录,但往往包含与其他数据集重叠的数据。组合数据集、去重、消除低质量或错误数据,既耗时又在技术上具有挑战性。
以下是 TxT360 项目的一些关键细节:
LLM360 是由 Petuum 和 MBZUAI 创建的开源大型语言模型项目、社区和不断发展的最佳实践及资源框架,现在隶属于该大学的基础模型研究所。该项目不仅分享其研究人员开发的模型和数据集,还分享详细的见解和方法论。
TxT360 数据集旨在通过提供大量高质量、多样化的数据来预训练大型语言模型。LLM360 研究人员设计了一个全面的数据处理流水线,用于清理数据并从 99 个 CommonCrawl 快照以及其他 14 个高质量来源中去除重复数据。 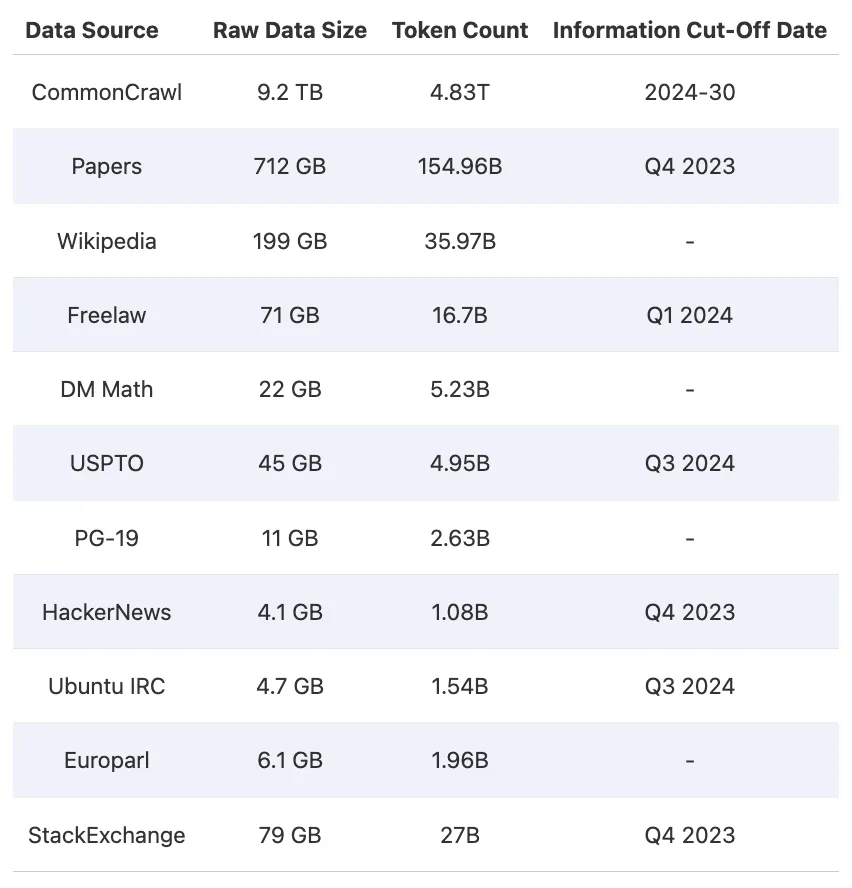
研究人员还特别关注数据加权(即了解哪些数据更重要,或对创建良好数据集至关重要)。通过一个简单但有效的上采样方法,创建了一个超过 15 万亿个 token 的语料库,该语料库在多个关键指标上优于之前的最佳数据集 FineWeb 15T(https://huggingface.co/datasets/HuggingFaceFW/fineweb)。 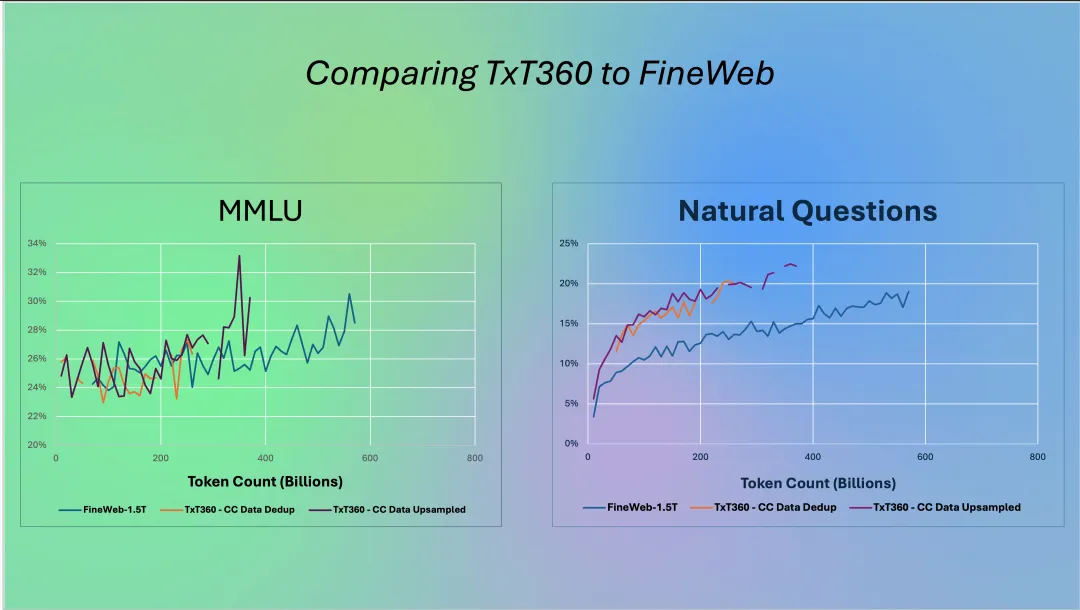
TxT360中存储了丰富的元数据,使得预训练者能够更精确地控制数据分布,从而探索更先进的加权技术,这是之前预训练数据集中不常具备的功能。
LLM360记录了所有详细的步骤、决策理由、统计数据、代码(即将发布)、分析结果等,为 LLM 开发者提供了一种宝贵的资源。该项目还提供了迄今为止最详细的关于预训练数据集管理的技术博客。
TxT360 目前在 Hugging Face 的超过 22 万份数据集列表中排名第一。
