
 语音小管家
论文标题:DeSTA2.5-Audio: Toward General-Purpose Large Audio Language Model with Self-Generated Cross-Modal Alignment
Arxiv:
Github:https://github.com/kehanlu/DeSTA2.5-Audio
问:为何本研究聚焦“通用型音频语言模型”?
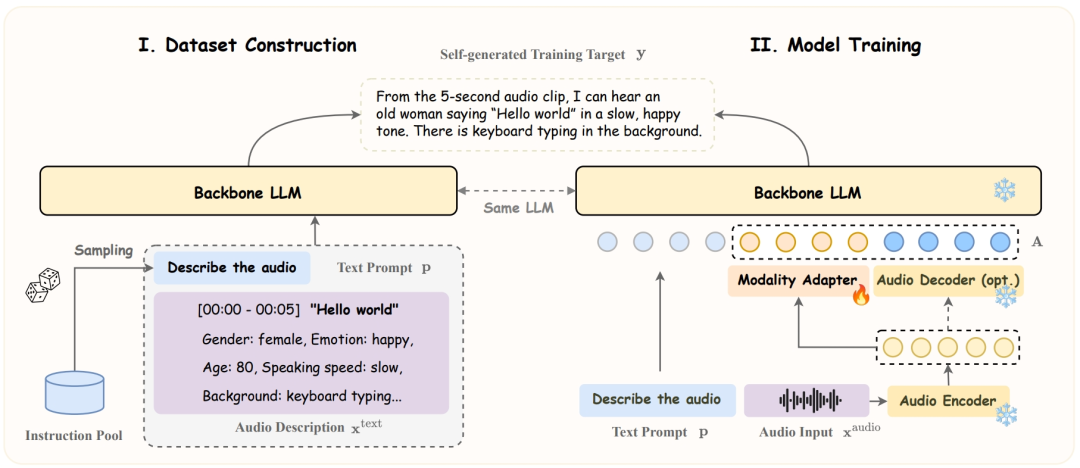
答:当前主流音频语言模型虽可执行听觉感知与指令遵循任务,但往往依赖人工构建或跨模型生成的数据集,导致模型出现灾难性遗忘(Catastrophic Forgetting)现象,语言能力退化明显。本论文从根本出发,重新审视数据构建流程,提出「模型自我生成训练目标」机制,保留 LLM 的语言能力,同时实现精准的跨模态对齐,从而训练出鲁棒、泛化强、无需任务调参的通用音语大模型。
问:论文的主要研究成果与创新点有哪些?
答:自生成跨模态对齐策略DeSTA: 由 LLM 自行生成训练标签,确保风格与输出一致性,克服灾难性遗忘,提升跨模态迁移鲁棒性;大规模通用数据集 DeSTA-AQA5M: 覆盖语音、环境声、音乐三大领域,含 500 万组音频-指令-响应数据,源自 50 个公开数据集,总计约 7000 小时;
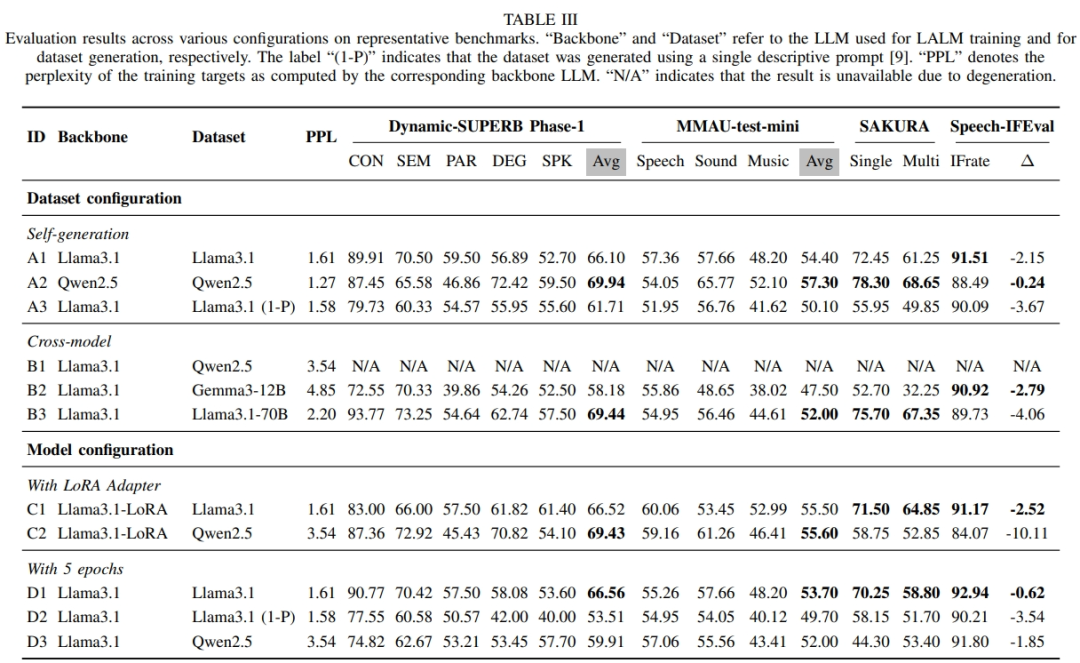
强大的泛化性能:DeSTA2.5-Audio 在多个标准测试集(Dynamic-SUPERB、MMAU、SAKURA、Speech-IFEval、VoiceBench)上展示优异的性能。
问:为何值得一读?
答:首篇系统提出“自生成音频文本对齐”策略并应用于 LALM 训练的研究;无需人工调教或额外任务调参,模型即能在多个语音理解、情绪识别、环境声分析等任务中展现 SOTA 表现;重要对比发现: 明确指出模型训练过程中数据来源与模型分布不一致将大幅损害性能,即使采用更强大的 LLM 生成数据亦无法弥补,凸显「数据生成一致性」为构建通用 LALM 的关键。以少胜多,仅用 7000 小时音频达成超过使用 51 万小时数据的模型效果,堪称“大模型训练范式创新”典范;提供一站式开源工具链,助力研究者与开发者轻松上手构建下一代音语 AI 系统。
