
 语音小管家
作者|吴翰林 审校| 段旭峰 王书琪
文章结尾有大消息!
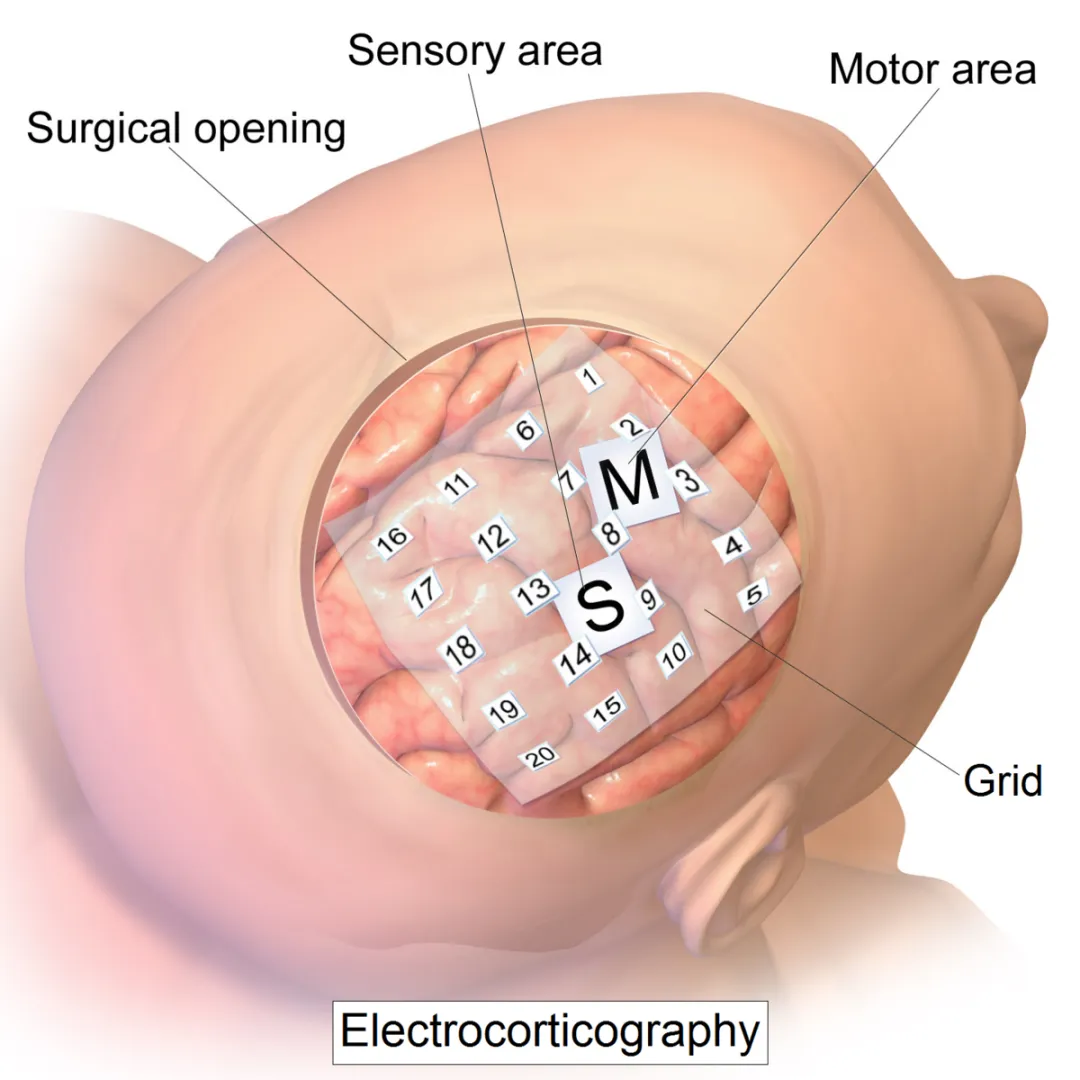
皮层脑电图 ECoG
皮层脑电图(Electrocorticography, ECoG)是一种侵入性的神经监测技术 。它通过将电极阵列直接放置在大脑皮层的表面,来记录神经活动信号 。这种方法通常用于临床上需要进行颅内监测的难治性癫痫患者 。对于科学研究而言,ECoG的主要优势在于其具有很高的时空分辨率,能够非常精确地测量大脑在执行特定任务时,其神经活动在时间和空间上的变化。
接下来,我们详细解读这项研究的方法和发现。
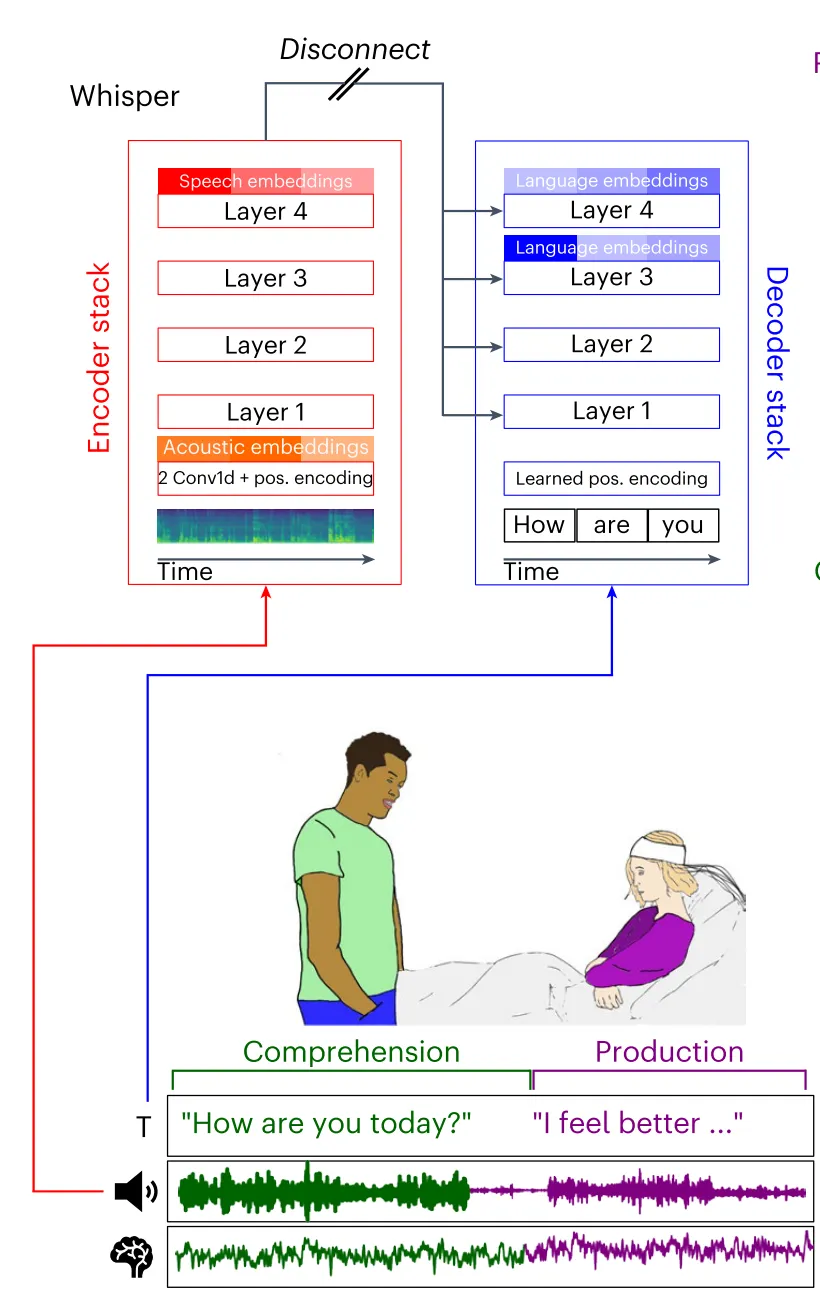
第一步:收集真实对话的神经-语音同步数据
第二步:提取声学、语音、语言信息在 Whisper 中的内部表征
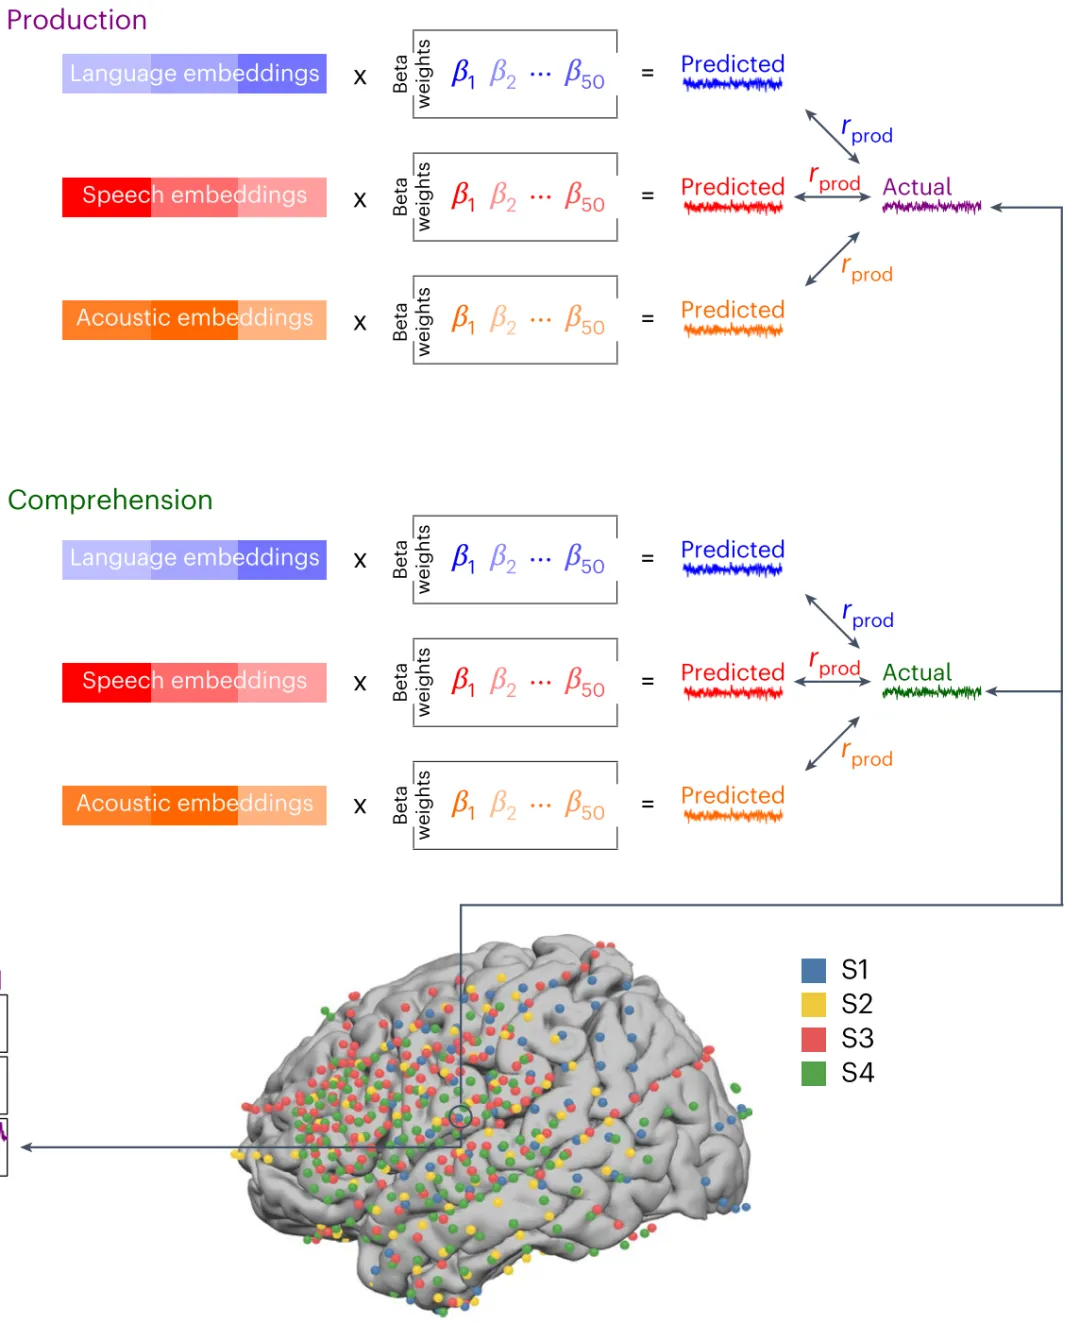
第三步:用 Whisper 模型的内部表征预测神经信号
从 Whisper 模型中提取出的声学、语音、语言嵌入能否预测真实记录到的人脑 ECoG 信号呢?如果能,则说明Whisper 模型的表征方式和人脑有相似之处。
对每位被试的数据,研究者为每一个电极、每一个时间点(从目标词出现前2000毫秒到出现后2000毫秒,每25毫秒一个点)的数据,都训练了一个独立的线性回归模型。这个模型用 Whisper 的嵌入向量来预测该电极在该时间点上的神经信号。
他们采用了10折交叉验证方法:数据被分成10份,轮流用9份训练模型,然后在剩下的1份未见的数据上进行预测和评估。
最后,计算该模型预测的神经活动与实际记录到的神经活动之间的皮尔逊相关系数 r,r 值越高说明模型的预测越准确(如下图所示)。
接下来,我们来看 Whisper 模型的预测表现。
Whisper 模型内部表征能有效预测人脑语言活动
如下图所示,三种嵌入向量(声学、语音、语言)都能在多个脑区中显著预测神经活动,包括经典的语言区颞上回STG、额下回IFG/Broca区,以及感觉运动区SM、角回AG等,相关性最高可达0.5。
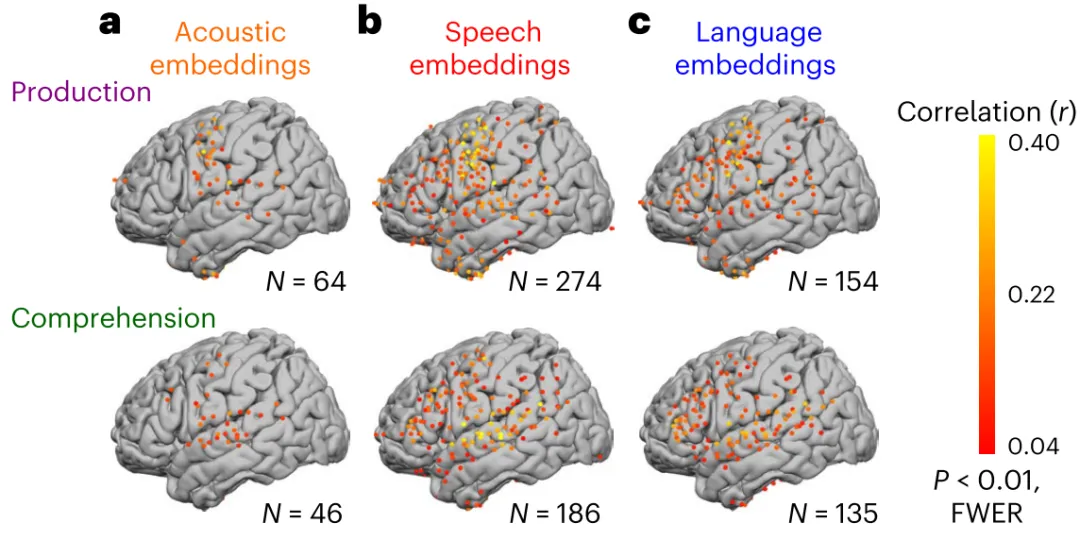
相较而言,语音嵌入预测的显著电极(上图中的红/黄色点)数量最多,语言嵌入的预测效果也优于声学嵌入。
接下来,我们详细解读这项研究的方法和发现。
Whisper 表征预测人脑语言加工的表征层级和空间分布
接下来,研究者对比了声学嵌入、语音嵌入、和语言嵌入各自独立解释了大脑活动的多少变异,以及它们共同解释了多少变异。
他们采用了方差分解分析(Variance partitioning analysis)的方法。简单来说,就是比较单独用每种嵌入,以及结合起来预测大脑活动的效果差异。
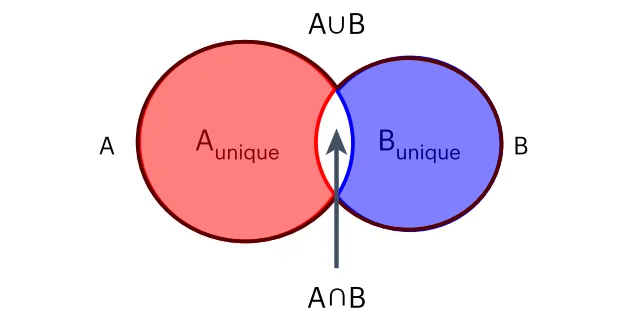
具体来说,研究者首先基于两种不同的嵌入(比如嵌入A代表语音嵌入,嵌入B代表语言嵌入),分别构建两个独立的编码模型来预测神经活动。评估这两个独立模型的表现,可以得到它们各自解释的方差,记作 r^2(A) 和 r^2(B)。然后,将嵌入A和嵌入B拼接(concatenate)起来,构建一个组合编码模型,评估后得到它解释的总方差,记作 r^2(A∪B)。利用集合运算的原理,可以计算出由嵌入A和嵌入B共同解释的共享方差(shared variance),计算公式为:r^2(A∩B) = r^2(A) + r^2(B) − r^2(A∪B)。有了共享方差后,就可以计算出每种嵌入单独解释的独特方差(unique variance),公式为:r^2(A_unique) = r^2(A) − r^2(A∩B); r^2(B_unique) = r^2(B) − r^2(A∩B)。为了更直观的比较,研究者进一步计算出独特方差在总方差中的百分比:%r^2(A_unique) = r^2(A_unique) / r^2(A∪B);%r^2(B_unique) = r^2(B_unique) / r^2(A∪B)。下图是示意图:
结果发现,在语言产生和理解过程中都观察到了清晰的层级表征关系:
声学 vs. 语音:语音嵌入在预测大脑活动方面显著优于声学嵌入。在颞上回STG、额下回IFG和感觉运动皮层SM的大部分电极中,语音嵌入比声学嵌入解释了更多的方差。声学嵌入仅在少数几个位于外侧裂(lateral fissure)和腹侧运动皮层(ventral motor cortex)的电极上解释了一些独特方差。
语音 vs. 语言:较低级的感知和运动相关脑区(如颞上回STG、中央前回/后回preCG/postCG,即感觉运动皮层SM)的活动更多地被语音嵌入所解释。而较高级的语言区域(如额下回IFG、角回AG)的活动则更多地被语言嵌入所解释(见下图)。
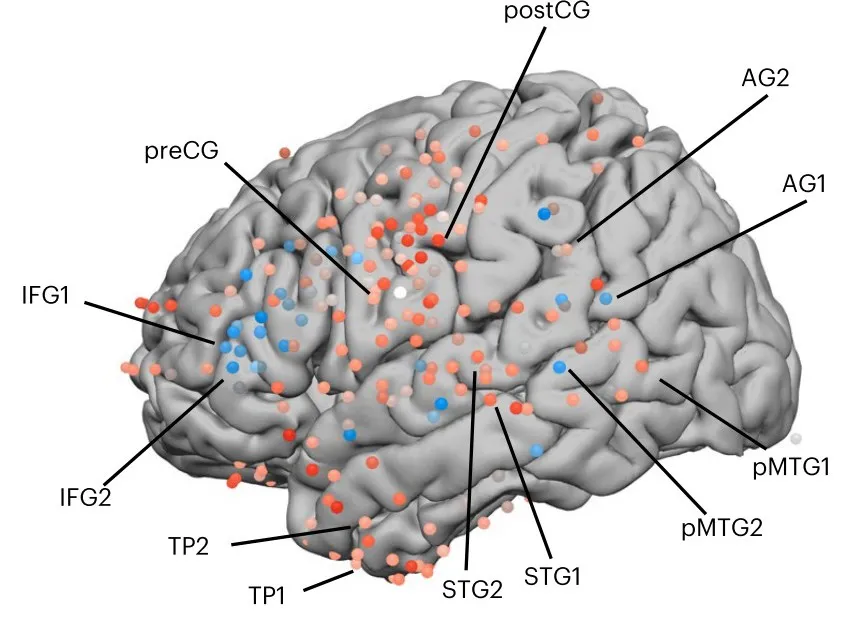
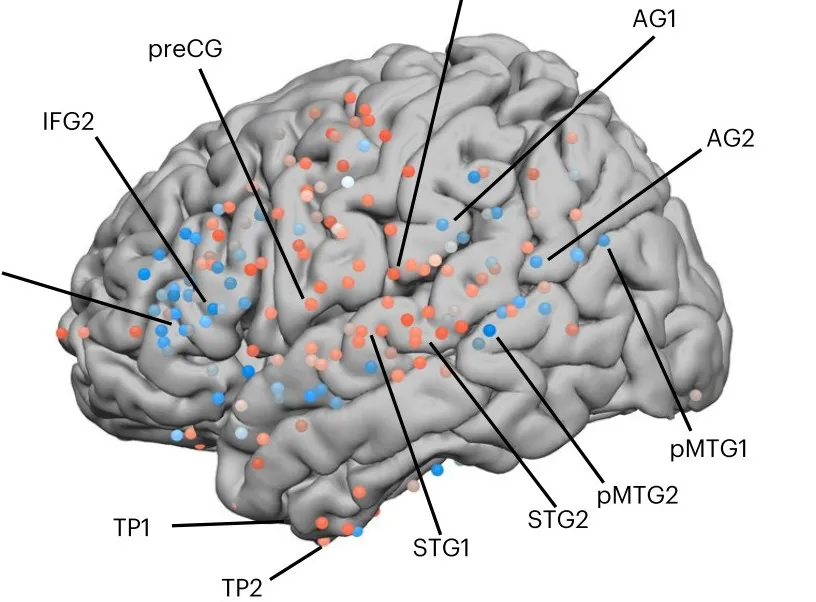
上半图为语言产生,下半图为语言理解。每一个圆点代表一个 ECoG 电极。原点的颜色越红表示该点的活动被语音嵌入解释的程度越高,颜色越蓝表示被语言嵌入解释的程度越高。
Whisper 表征捕捉人脑语言加工中的多层级整合
Whisper 模型本身既处理声音也处理文本,是多层级的(原文用的是“多模态”一词)。那么在提取语言嵌入时,如果只给解码器文本信息(像一般的语言模型那样),和同时给编码器语音信息、给解码器文本信息(Whisper原本的方式),预测大脑活动的效果会有什么不同呢?
换句话说,在用 Whisper 模型预测大脑活动时,单纯使用文本信息(对话转录稿)和同时使用文本与音频信息(对话转录稿+音频),哪种方式更好?
结果发现,无论是在语言产生还是理解任务中,当语言嵌入融合了来自编码器的语音信息后,其对神经活动的预测准确性显著高于仅使用文本信息提取的语言嵌入(如下图所示)。
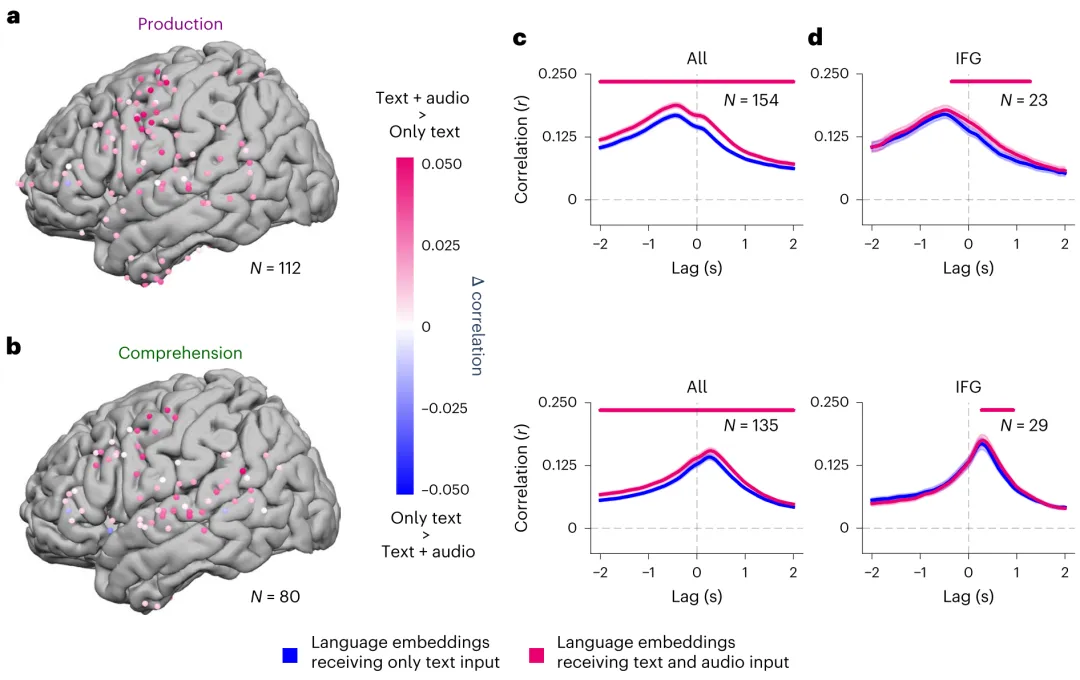
图a和图b表示两种模型(纯文本 vs. 文本+音频)预测效果的差异。图上每一个圆点代表一个 ECoG 电极。颜色代表了预测准确度的差值(Δ correlation)。粉红色表示“文本+音频”模型的预测效果优于“纯文本”模型。蓝色表示“纯文本”模型的预测效果优于“文本+音频”模型。图c和图d表示预测准确度的量化比较。X轴代表时间延迟(lag),0点是单词出现的时刻。负值代表词前,正值代表词后。Y轴代表预测的神经活动与真实神经活动的相关性,数值越高说明预测越准。粉色曲线代表融合了文本和音频信息的语言嵌入模型的表现。蓝色曲线代表只使用纯文本信息的语言嵌入模型的表现。顶部的粉色线段表示在该时间段,两条曲线之间的差异具有统计学意义。
“文本+音频”模型相比于“纯文本”模型的预测优势,在STG、SM区,甚至在传统认为负责高级语言加工的IFG都观察到了。这表明大脑的语言区在处理词义时,也可能会整合声音线索,即存在多层级整合过程。
Whisper 表征捕捉语言信息流动的空间分布和时间进程
接下来,研究者通过分析不同时间延迟(lag)的编码模型表现,追踪语言信息在不同脑区处理(流动)的时间顺序。
具体而言,研究者首先以单词出现的时刻为 lag = 0,然后设定了一个非常宽的时间范围,从单词出现前2000毫秒(lag = -2000 ms)一直到单词出现后2000毫秒(lag = +2000 ms)。在这个时间窗口内,他们以25毫秒为步长,确定了161个离散的lag。接着,对于这161个 lag 中的每一个点,都提取一个以该点为中心的、时长为200毫秒的 ECoG 神经信号窗口。将这个窗口内的神经信号平均后,就得到了该单词在这个 lag 上的神经活动强度。对于一个给定的词,研究者会用这个词的嵌入向量,去分别预测在 lag = -500 ms、lag = -475 ms、... lag = 0 ms、... lag = +100 ms 等所有161个时间点上的神经活动。研究者为每一个 lag 都构建了一个独立的模型。每个电极最终会得到161个模型的预测表现得分(即相关值 r),每一个得分对应一个 lag。
结果发现(如下图所示):语言产生时,额下回IFG(偏重语言信息)的编码活动在单词实际说出前500毫秒达到峰值。感觉运动皮层SM(偏重语音和发音)的编码活动峰值则更靠近发音时刻,大约在词前200毫秒。这符合从“想到要说什么(语言)”到“准备怎么说(语音/发音)”的过程。
语言理解时,颞上回STG(偏重语音感知)的编码活动在单词出现后50毫秒达到峰值。额下回IFG(偏重语言理解)的编码活动峰值则显著晚于STG,在词后250-300毫秒。这符合从“听到声音(语音)”到“理解意思(语言)”的过程。
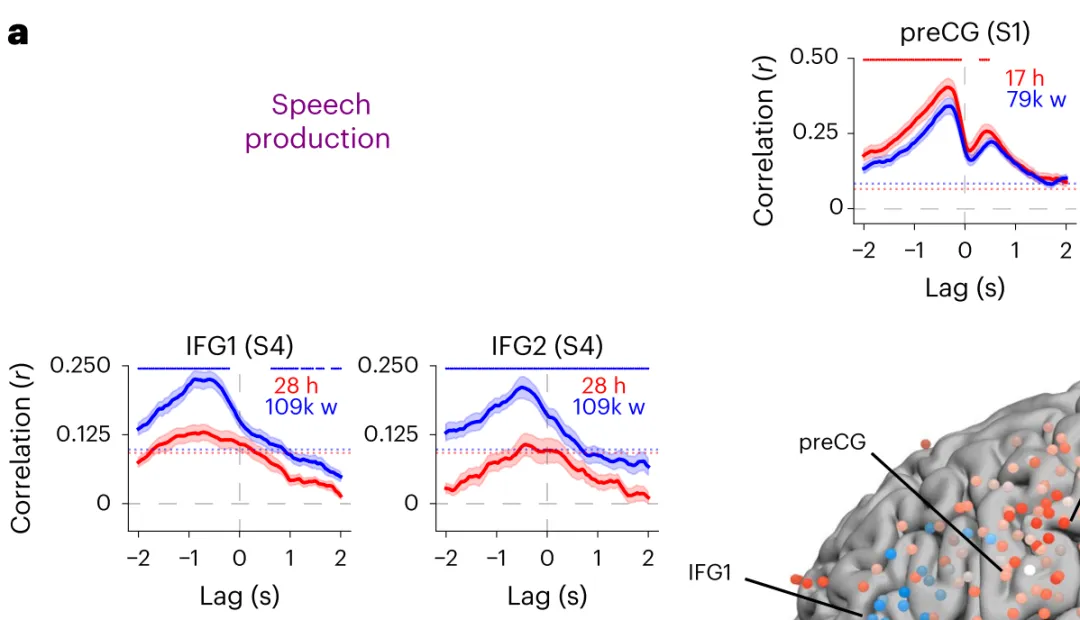
以语言产生的结果为例。图中的蓝色曲线表示语言嵌入的预测准确性,红色曲线表示语音嵌入的预测准确性。图标顶部的蓝色线段标记语言嵌入预测力显著优于语音嵌入的时间段(反之为红色线段标记)。28 h代表是基于28小时的录音数据得出的结果,109k w 代表这28小时的数据中包含了大约109000个单词。脑区preCG可以简单理解为代表感觉运动皮层SM。
Whisper 表征预测神经信号的能力优于传统符号表征
最后,研究者比较 Whisper 的嵌入向量与传统的、基于符号的语言学特征(如音素、词性、句法等)在预测大脑活动方面的表现。
为了能与 Whisper 的嵌入向量在同一个框架下进行比较,研究者将传统的符号语言学特征转换成数值化的向量形式。他们通过二值化向量(binarized vectors)的方法,为对话中的每个词构建了两种类型的符号模型:
符号语音模型(Symbolic speech model): 研究者将每个词的声学和音系学特征,包括音素、清浊音(voiced/voiceless)、发音部位(place of articulation, PoA)和发音方式(manner of articulation, MoA)等转换成一个60维的二值化向量。
符号语言模型(Symbolic language model): 研究者将每个词的词汇和句法特征,包括词性(parts of speech, PoS)、句法依存关系(syntactic dependencies)、前缀(prefixes)、后缀(suffixes)以及是否为停用词(stop words)等转换成一个137维的二值化向量。
通过这种向量化的方法,传统的符号特征就可以和 Whisper 的嵌入一样,被用作线性编码模型的输入,来预测神经活动。
结果发现,无论是语音层面还是语言层面,从 Whisper 提取的(深度学习)嵌入向量在预测神经活动方面,均显著优于基于规则的传统符号模型向量(如下图所示)。这表明,Whisper 这种基于大规模数据统计学习到的分布式表征,比人为定义的离散符号更能捕捉自然言语的神经活动。
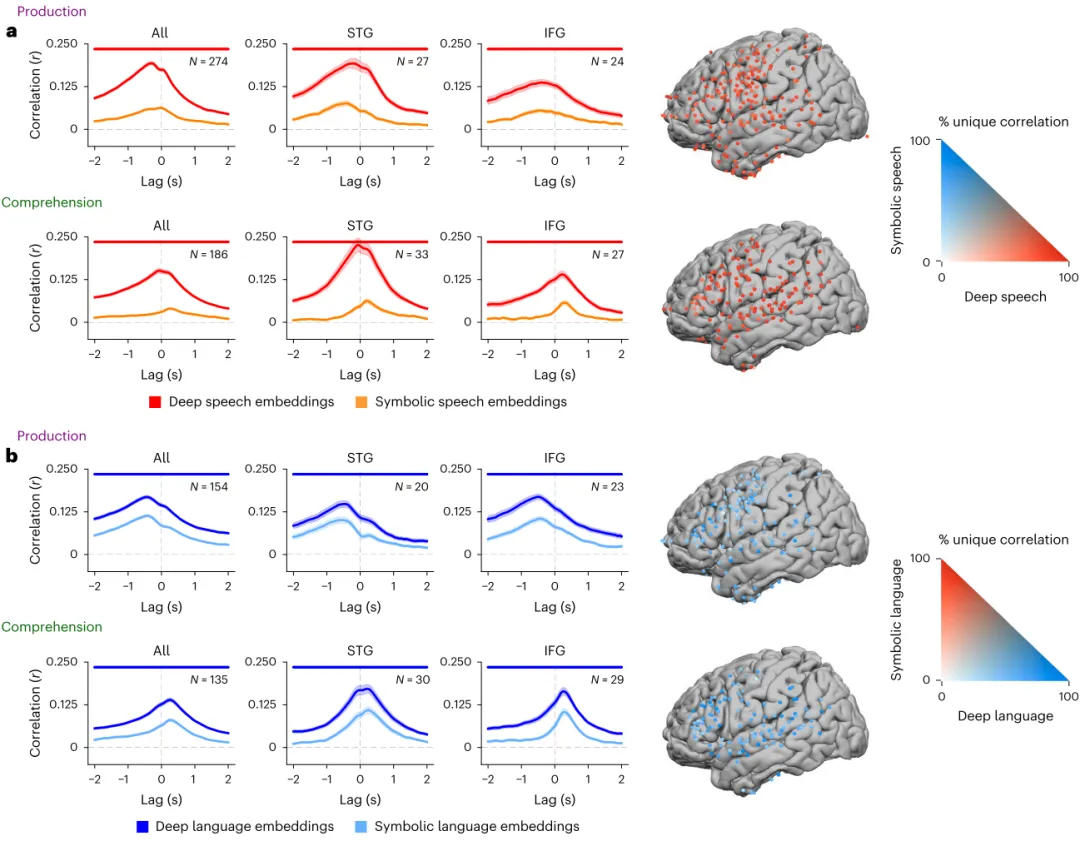
图中,深度嵌入(Deep embeddings)是从 Whisper 模型中提取的、通过大规模数据自学习得到的特征(红色和深蓝色曲线)。符号特征(Symbolic features)是由语言学定义的、基于规则的传统语言学特征(橙色和浅蓝色曲线)。
Whisper 表征中自发涌现出语言学符号类别
虽然 Whisper 并未外显地编码语言学符号,这些符号结构是否内隐地存在于其表征之中呢?
为探究这个问题,研究者使用t-SNE 降维可视化技术(作为定性测量),观察不同类别的符号特征(如音素、词性)在 Whisper 嵌入空间中的分布,并训练分类器(作为定量测量),看能否从嵌入中解码出这些符号特征。
定性测量方法 t-分布随机邻域嵌入(t-distributed Stochastic Neighbor Embedding, t-SNE) 是一种降维可视化方法。这种方法是将人眼无法直观理解的高维嵌入空间(例如3840维)压扁成一个二维平面图,然后通过给图上的点着色,来直观地观察是否存在有意义的结构。首先,研究者为数据集中出现的每一个独立单词(unique word)创建一个代表性的嵌入向量。他们的方法是,找到一个单词(如“hello”)在所有对话中出现的所有实例,然后将这些实例的嵌入向量进行平均,得到一个单一的、平均后的嵌入向量。这个过程针对语音嵌入和语言嵌入分别进行。然后,他们使用 t-SNE(t-分布随机邻域嵌入)的降维算法,将这些高维的平均词嵌入投影到一个二维散点图上。如果某些词的嵌入在高维空间中彼此接近,那么它们在二维图上也倾向于聚集在一起。最后,为了理解这个二维图的结构,研究者会根据已知的语言学符号特征给每个点(单词)上色。比如,单词 cat, king, car 的第一个音素都是 /k/,那么它们在图上就会被标为同一种颜色。观察着色后的二维图,如果相同颜色的点(即具有相同符号特征的单词)自然地聚集在一起,形成一片一片的“色块”,就暗示模型的嵌入空间已经自发地学习并组织了这些符号信息。
可视化的方法很直观,但不够客观。为了量化嵌入向量中到底包含了多少关于符号特征的信息,研究者还使用了机器学习的分类方法,其核心是只给分类器输入一个词的嵌入向量,看它能否准确地预测出这个词对应的符号标签。研究者使用了一个多项逻辑回归(multinomial logistic regression)分类器,其输入是一个单词的嵌入向量,输出是分类器预测出的该单词的符号标签(例如,从名词、动词、形容词等多个选项中选择一个)。采用10折交叉验证来训练和评估分类器的分类准确率。如果分类器的准确率远高于随机水平,就定量地证明了嵌入向量中确实编码了足够的信息来区分不同的符号类别。
结果发现,在语音嵌入空间中,不同的音素、发音部位(PoA)、发音方式(MoA)表现出明显的聚类。分类器能以约54%的准确率从语音嵌入中识别音素,远高于4%的随机水平。
在语言嵌入空间中,不同的词性(parts of speech, PoS)也表现出清晰的聚类。分类器能以约67%的准确率识别词性,远高于20%的随机水平。
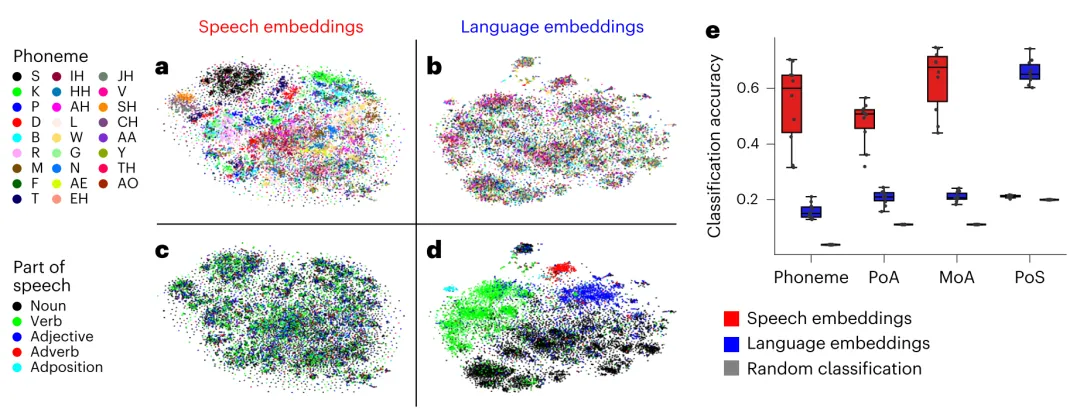
图a, b, c, d是使用 t-SNE 降维技术绘制的二维散点图。图上每一个点代表数据集中一个独立单词的平均嵌入向量。通过观察相同颜色(即相同语言学特征)的点的分布模式,可以判断嵌入空间是否对该特征进行了有效的组织。图e展示了训练一个分类器,让它仅根据嵌入向量来预测单词的语音学特征(Phoneme, PoA, MoA)和词汇学特征(PoS)的准确率。
这说明,尽管 Whisper 模型在训练时并没有被明确告知这些符号规则(如什么是音素,什么是名词),但这些语言学结构作为自然语言的高层统计特性,自发地在模型的嵌入空间中涌现出来。
Whisper:一个统一的、多层级的声学-语音-语言表征框架
总体上,这项研究首次证明,Whisper 作为一个统一的、多层级声学-语音-语言计算模型,其内部表征能够准确地预测和解释在真实自然对话中人脑的神经活动。
Whisper 的内部表征捕捉到了大脑在处理自然对话时语言信息流动的层级结构、时间动态、和空间分布,在解释脑活动方面超过了传统的语言学符号模型。这可能说明 AI 模型与人脑在处理语言时可能共享某些核心的计算原理。
未来,我们应该会看到更多研究,用更先进的、能处理更多模态(如视觉信息)的AI模型来深入探究人类语言认知的奥秘。
