语音小管家
论文链接:https://arxiv.org/pdf/2505.17589v1
项目简介
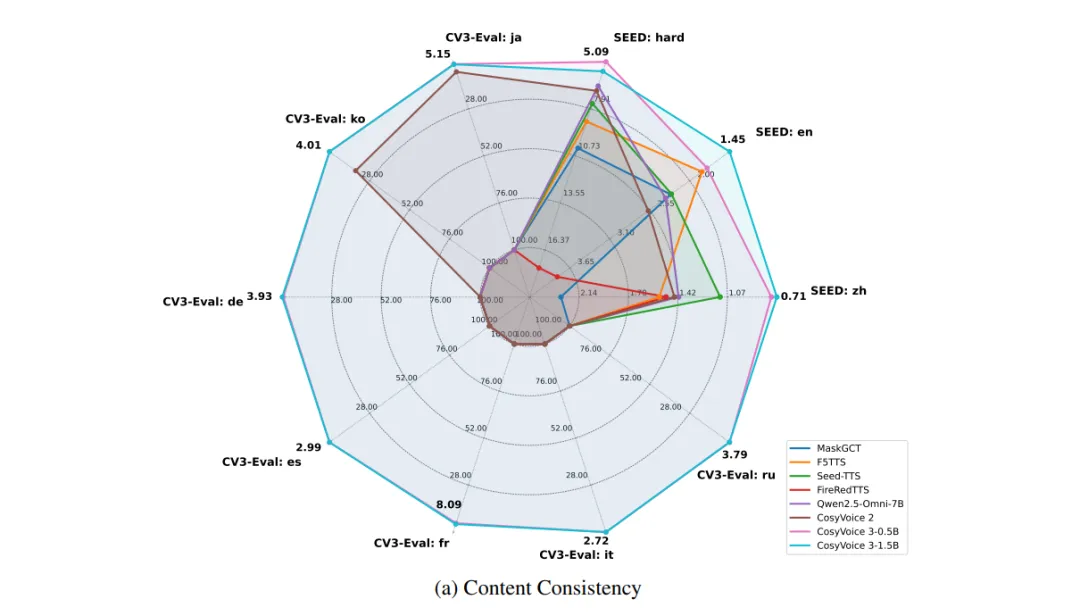
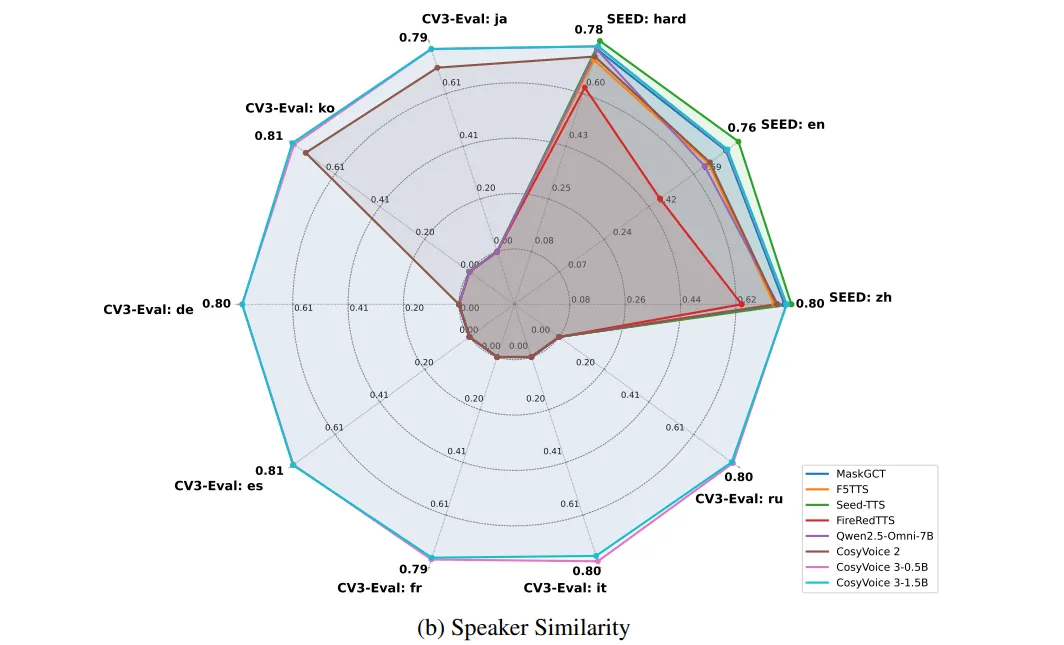
CosyVoice 3 是阿里巴巴集团通义实验室语音团队研发的零样本TTS模型,实现复杂环境下的语音合成。该模型通过多项关键技术升级实现显著性能提升:训练数据规模扩展至百万小时级别,模型参数量增至15亿,并引入多任务监督训练的语音分词器以及可微分奖励优化机制。相比前代模型,CosyVoice 3 在内容一致性、说话人相似度与韵律自然度等方面均有显著突破。该模型仅需3秒原始音频即可高度还原目标音色,并支持方言合成与语气灵活调整等功能。
模型结构
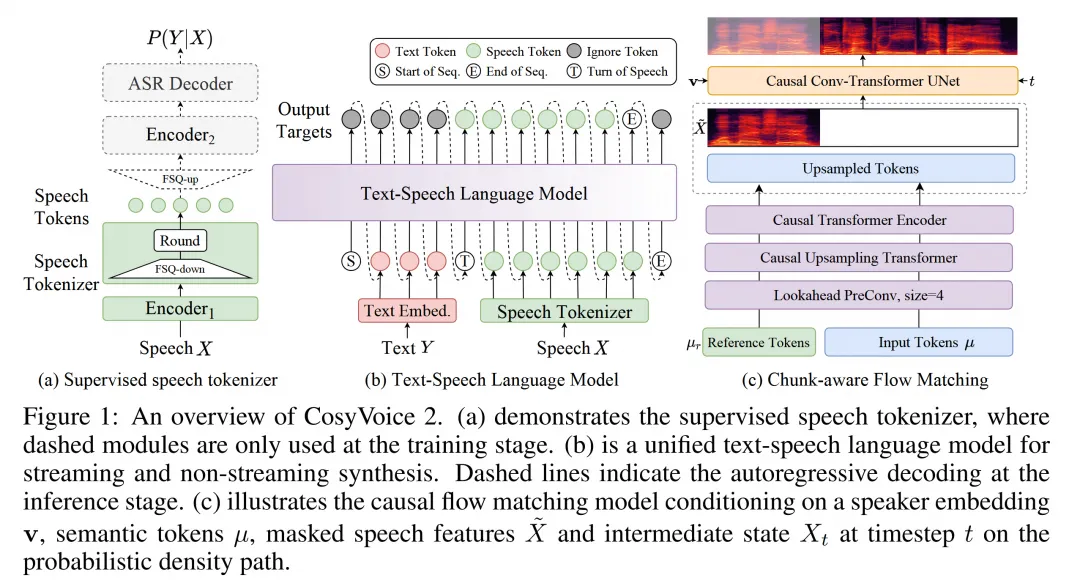
Cosyvoice 3沿用了CosyVoice 2的架构。其中Speech tokenizer使用了FSQ,预训练的任务是ASR。LM backbone在CosyVoice的基础上去掉了utterance-level的speaker embedding,支持流式解码和非流式生成。Causal Conv-Transformer UNet支持不同大小的chunk生成,可以平衡时延和生成效果。
技术特点
采用新型语音分词器,通过多任务监督训练(涵盖自动语音识别、语音情感识别等任务),提升韵律自然度。
提出新的可微分奖励模型,适用于自身及其他基于大语言模型的语音合成模型的后训练。
扩大训练数据规模至百万小时,覆盖 9 种语言、18 种汉语方言及多样场景。
增加模型参数至 15 亿,提升多语言基准测试性能。
支持发音修复、文本归一化自训练及指令驱动语音生成等功能,增强可控性与鲁棒性。
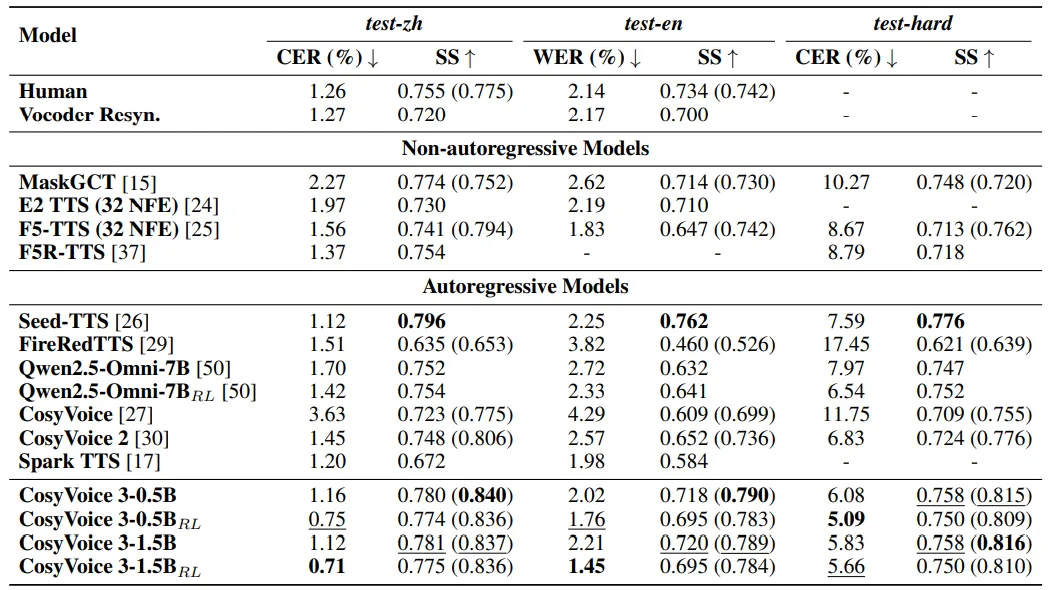
实验结果