
 语音小管家
2022年入职后,在mentor的指导下我开始真正接触语音增强,从初探传统降噪算法WebRTC ANS,到复现RNNoise、DTLN、DCCRN等经典AI降噪模型,再到后面跟进DNS Challenge、AEC Challenge、SSI Challenge、URGENT Challenge、ICASSP、Interspeech等赛事会议上的SOTA模型,自己也算是见证了这段时间以来语音增强领域的发展。
按照我自己的认识,我会对过去的发展做一个这样的分类(大体上按照时间排序,但是发展是多轨的,不同类别在时间上会有重合):
第一类:传统降噪算法(维纳滤波、基于MMSE的噪声功率估计,优雅),比如WebRTC ANS、OMLSA; 第二类:过渡的AI降噪算法(传统前后处理+AI模型,突出一个设计感),比如RNNoise、PercepNet; 第三类:高纯度的AI降噪算法(基础结构逐渐稳定为CRN,元器件上有大力上Transformer、Mamba的,也有精致雕琢出轻量的),比如SEMamba、GTCRN; 第四类:个性化AI降噪算法(融合个人语音特征,主打私人订制),比如TEA-PSE、pBSRNN; 第五类:回声消除和降噪算法(不满足降噪,延时估计、线性回声、非线性 回声我都想要),比如MTFAA、DeepVQE; 第六类:通用语音增强(融合降噪、去混响、修复等多项任务,不仅要丢不想听的,还要补得好听),比如EDNet、TS-URGENet; 第七类:空间语音增强(结合多麦、波束形成等空间硬件/算法做语音增强),比如H-GTCRN;
不考虑当下的实用性,只讲理想,在我心中,真正的AI应该是通用的,而不是限制于一小项任务,所以对这所谓的七类,我最感兴趣的其实是“通用语音增强”。这类算法,有几个方向还是挺有意思的。
⏩EDNet
标题:EDNet: A Distortion-Agnostic Speech Enhancement Framework with Gating Mamba Mechanism and Phase Shift-Invariant Training
论文地址:https://arxiv.org/abs/2506.16231v1
发布日期:2025-06-19
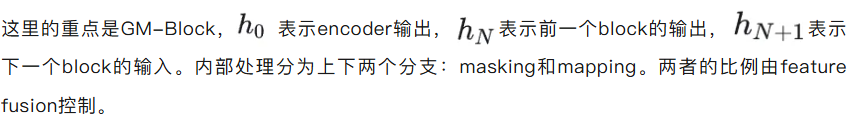
AI降噪通常可以分为两类:masking和mapping。前者假设噪声具有加性,模型通常要求输出取值范围[0, 1]的mask,降噪频谱=带噪频谱×mask,输出可控;后者直接通过模型估计降噪频谱,理论上适用性更广,但是输出可控性要差一些,比如语音失真。单从降噪效果来看,masking更好,用的也更广泛。但是现在任务要求不仅要去的漂亮,还要补的好听,怎么办呢?可以考虑把masking和mapping结合一下,优势互补。不过EDNet这模型只是在内部特征处理使用这个混合方法,decoder的输出只用了mapping。
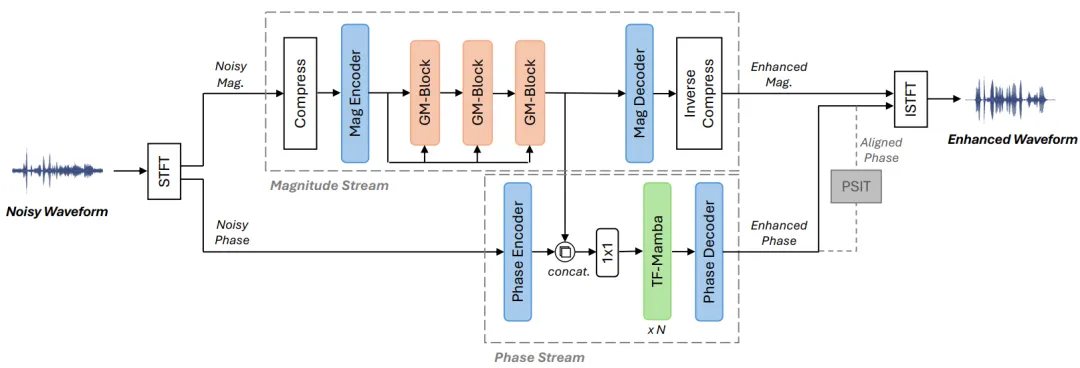
这个模型有两个分支,一个分支输入幅度谱,经过encoder->GM-Blocks->decoder,输出去噪和修复的幅度谱;另一个分支输入建模难度较大的相位谱(之所以要和幅度谱分开,有一个认可度比较高的说法是,相位谱建模难度大,放一起会影响幅度谱的建模),经过 encoder->concat->TF-Mamba(可以视作TF-GRU这类操作,Mamba这里就不展开了)->decoder->PSIT,encoder后面接concat是因为幅度谱和相位谱存在内在联系,引入幅度谱的中间特征可以协助相位谱建模,输出去噪和修复的相位谱后再用PSIT做一次校正;增强的幅度谱和相位谱结合后做iSTFT即可输出增强波形。
训练过程,数据包含多项失真:噪声、混响、频带缺失。损失函数
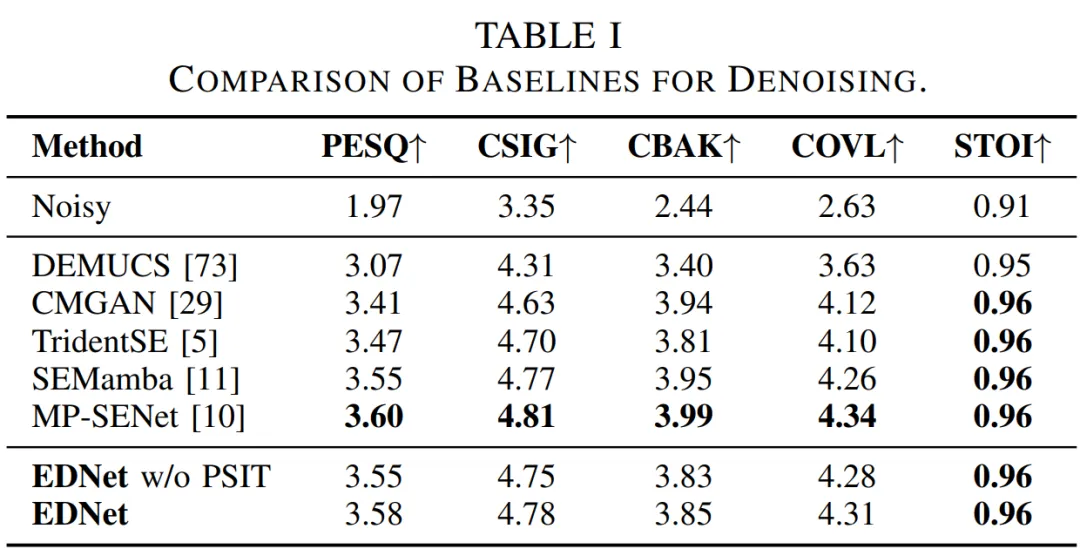
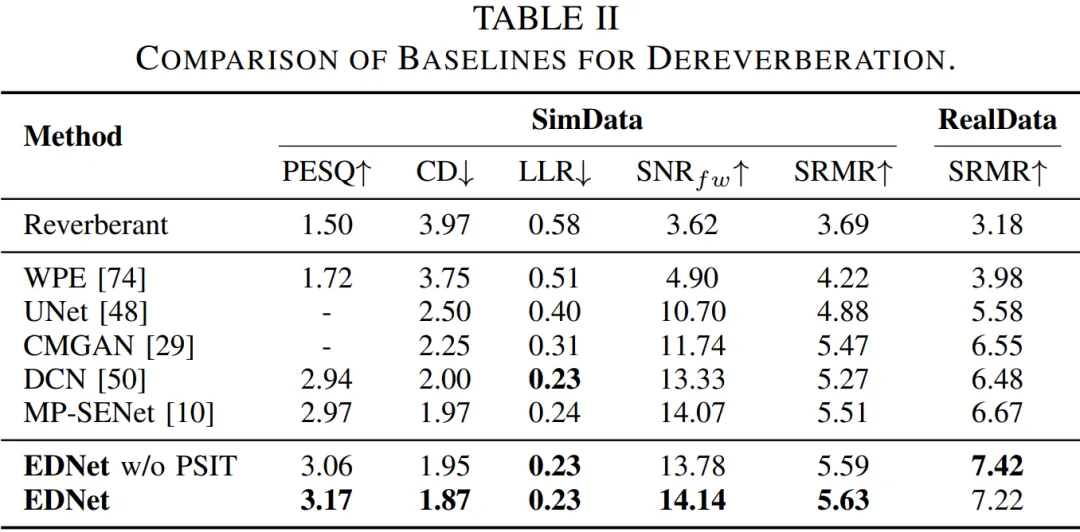
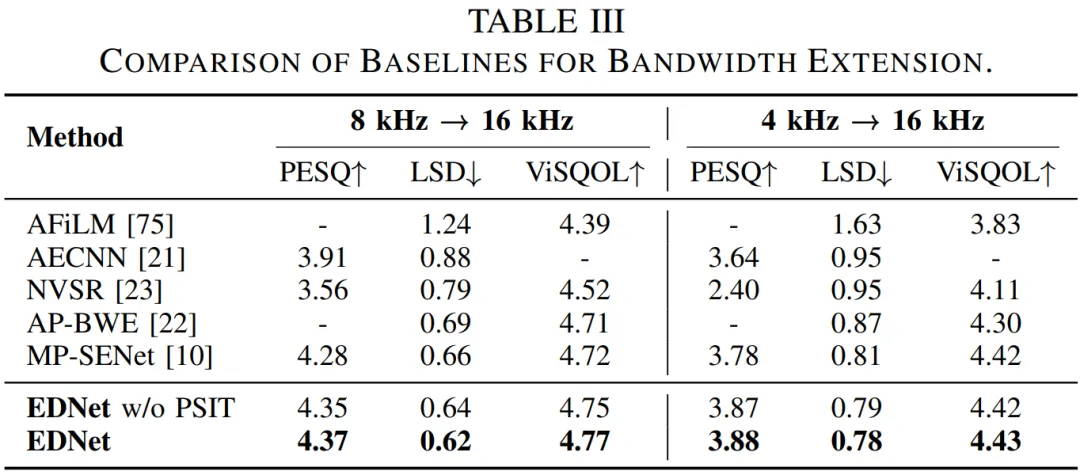
独立对比降噪、去混响、频带扩展三个任务,EDNet都能达到SOTA水准。
⏩TS-URGENet
标题:TS-URGENet: A Three-stage Universal Robust and Generalizable Speech Enhancement Network
论文地址:https://arxiv.org/abs/2505.18533
发布日期:2025-05-27
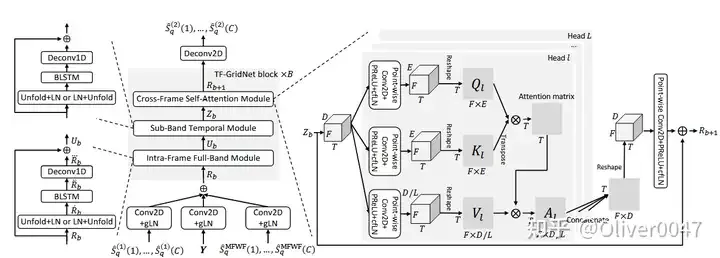
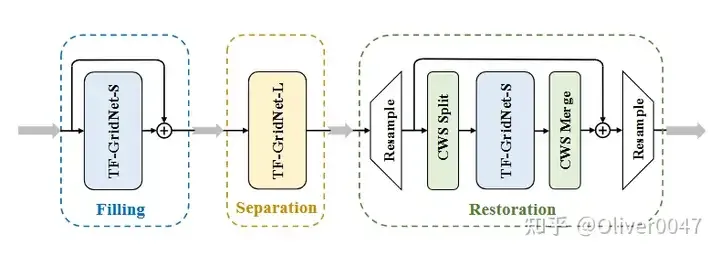
TS-URGENet由GTCRN的作者提出,参加了Interspeech 2025 URGENT Challenge,最终获得了赛道一的第二名,厉害!单个模型做一堆任务可能有点勉强,可以分成多个阶段一步步来完善,这就是其核心思想。
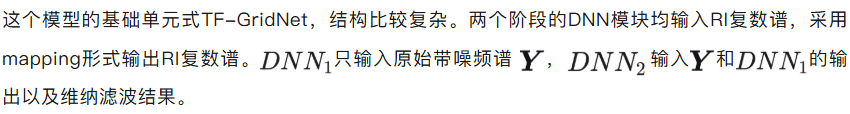
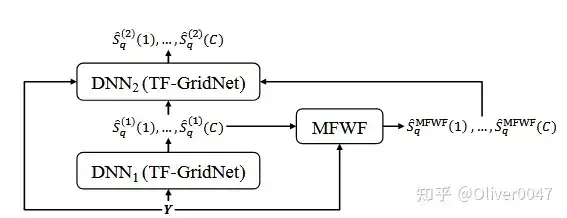
TS-URGENet包含三个阶段:
第一阶段采用GAN based TF-GridNet-S填充丢包造成的不连续性; 第二阶段采用TF-GridNet-L降噪、去混响; 第三阶段采用GAN based CWS-TF-GridNet做频带扩展、伪影消除和丢包补偿(CWS,channel-wise subband);
⏩USEMamba
标题:Universal Speech Enhancement with Regression and Generative Mamba
论文地址:https://arxiv.org/abs/2505.21198
发布日期:2025-10-01
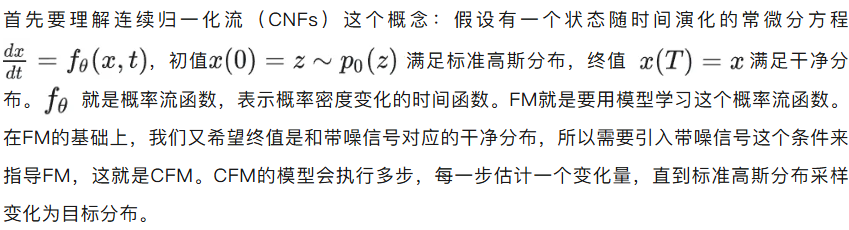
修复任务要求在原有的信号上添加东西,可视作生成任务。目前,扩散模型(Diffusion Models)和流匹配(Flow Matching)都是生成任务的有效解决方案。前者的一种经典实现是Score-based DDPM,限制了采样概率路径的选择(反向去噪过程),导致训练时间过长,且采样效率低;后者的一种经典实现是CFM(C代表条件),也需要从随机噪声多次迭代才能得到目标信号,但不需要前向加噪,而且后向推理过程仅需64~128步,更高效。
CFM背后的数学原理比较复杂,但是可以从简单的角度进行理解。
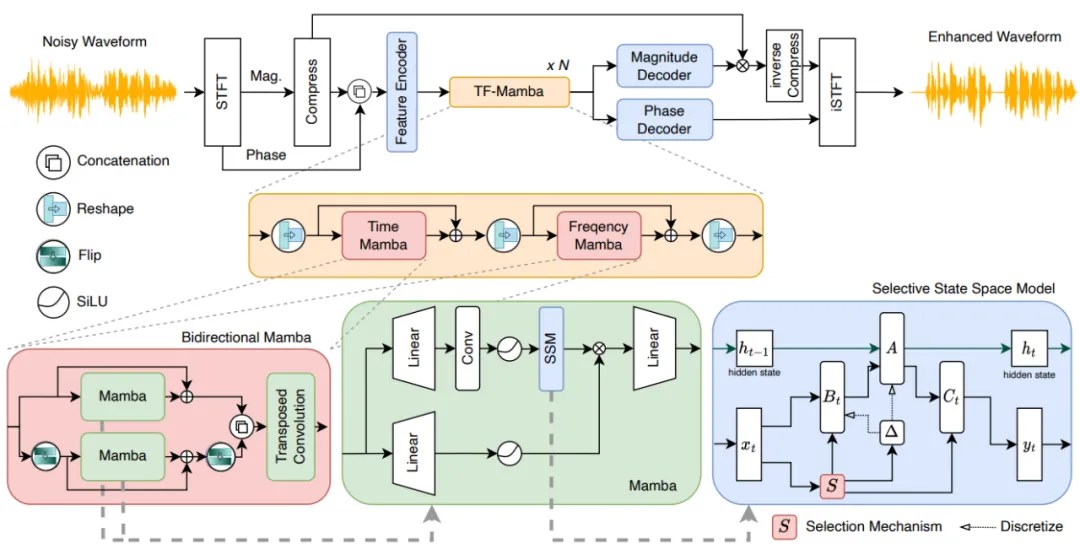
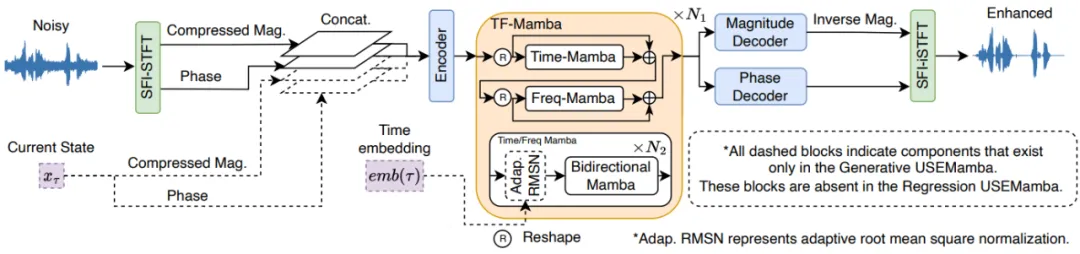
这篇文章中CFM采用的模型结构来自SEMamba(同一个作者的另一篇论文《An Investigation of Incorporating Mamba for Speech Enhancement》)。该模型大体构造和MP-SENet相近,亮点在于中间信息建模的TF-Mamba,最后幅度谱采用masking降噪,效果和MP-SENet相近,不过计算量更低,有完整的开源工程,大家可以体验下。
USEMamba在SEMamba的基础上引入了4项改动,但不包含CFM:
损失函数优化; masking转mapping; STFT和iSTFT引入SFI(不同于常规STFT固定win_size和hop_size的点数,SFI要求固定时长,这样不同采样率下的频谱帧数一致,仅频谱长度不同,后续网络需要适配这种变化); 增加TF-Mamba的层数;
如果在USEMamba的基础上引入CFM,就变成了图示的USEMamba-Flow。前者生成效果有限,后者会生成噪声,评分低,所以在实际运行过程中,需要配合能量检测自适应切换。
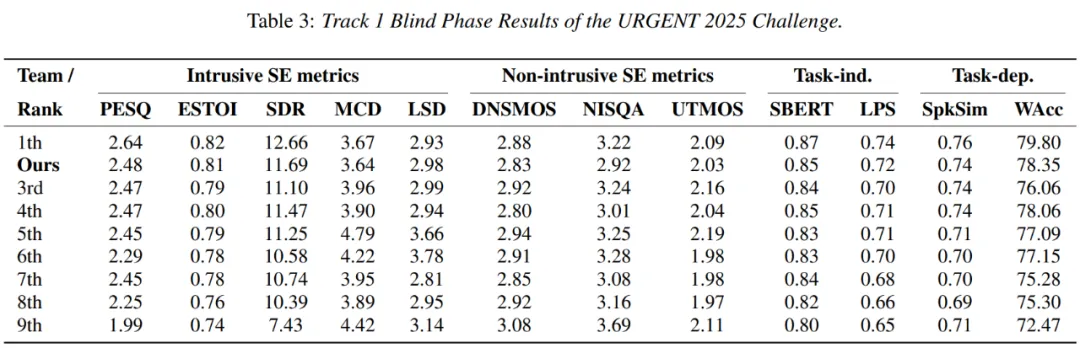
该模型在URGENT 2025 Challenge的盲测阶段获得了赛道一第二名,很厉害!
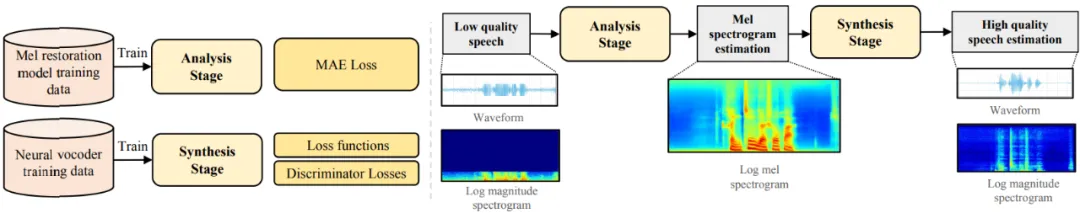
通用语音增强的一大难点是相位恢复,一类有效的方法是分两阶段:首先增强mel谱,然后利用vocoder恢复完整波形。前者可以用mapping的方法来实现,后者可以参考Hifi-GAN来实现。
⏩VoiceFixer
标题:VoiceFixer: Toward General Speech Restoration with Neural Vocoder
开源地址:https://github.com/haoheliu/voicefixer
发布日期:2021-10-05
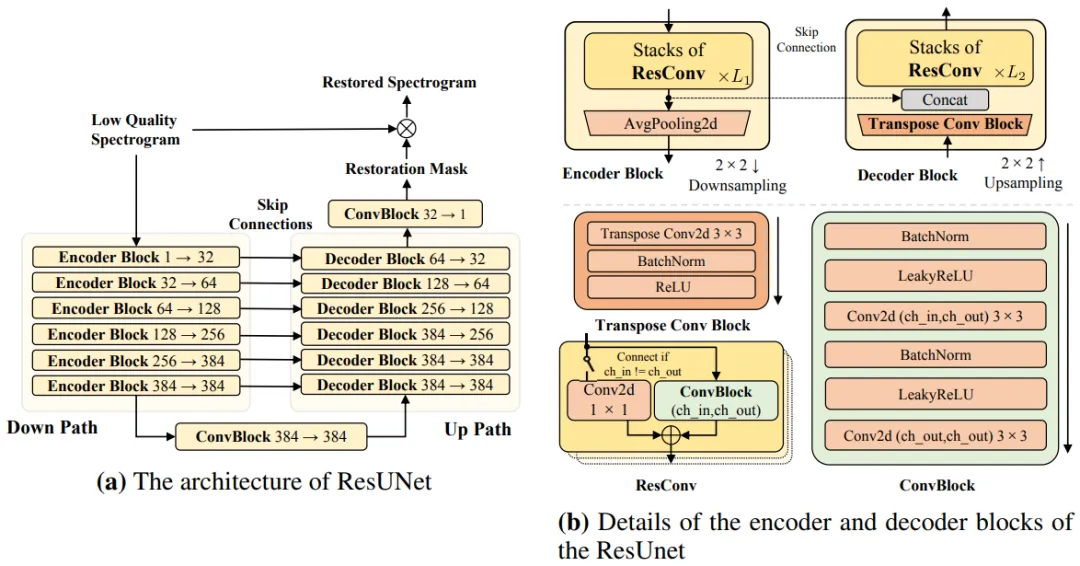
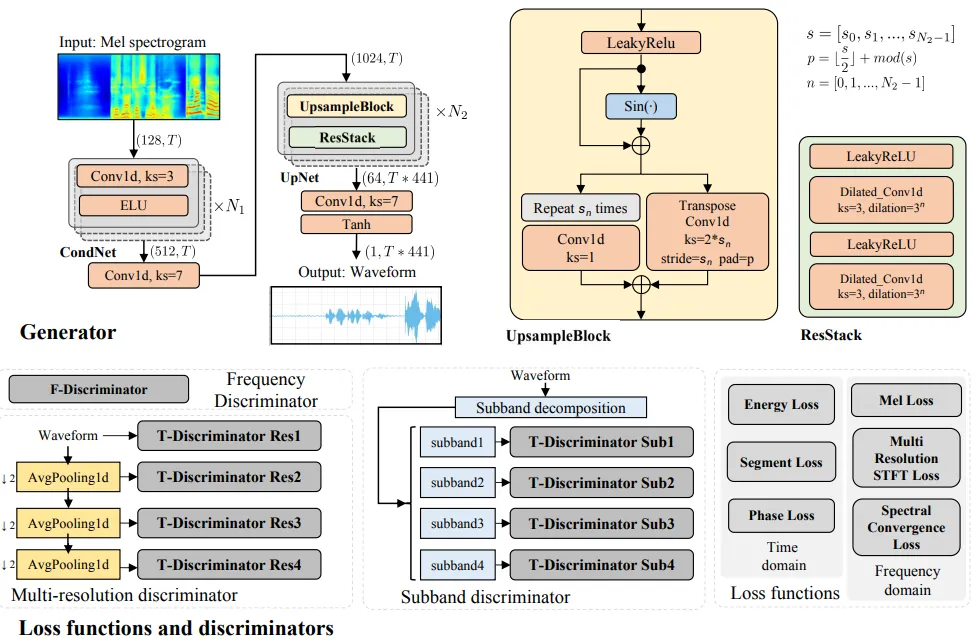
VoiceFixer就是这个方向的一种经典实现:第一阶段使用ResUNet加强mel谱(Restoration Mask由ReLU输出,属于mapping),第二阶段使用TFGAN恢复mel谱为波形,具体信息可以看下面的图,画得很清晰。从我自己测试的结果来看,VoiceFixer整体听感比较自然,但是会削弱一次谐波附近能量,造成音色变化,并且有时候会丢帧。
⏩AI Codec
AI Codec的经典流程是:编码(encoder)-残差矢量量化(RVQ,如果不熟悉,推荐看下What is Residual Vector Quantization?)-解码(decoder)。“基于AI Codec的方式做通用语音增强”这个方向还比较新颖,论文也提到还在探索阶段,目前流行的做法是在RVQ和decoder之间加入一个模型用于预测加强信号的离线令牌(分类任务)。结合论文里的阐述,我觉得这样做有两个优势:
效果优势:相比连续域回归型SE,离散域分类型SE(根据失真信号令牌,估计加强信号令牌)理论上能处理更多失真,泛化性更强,更加灵活; 功能优势:支持云服务端做实时SE。
⏩UDSE
标题:Universal Discrete-Domain Speech Enhancement
论文地址:https://arxiv.org/abs/2510.09974
发布日期:2025-10-11
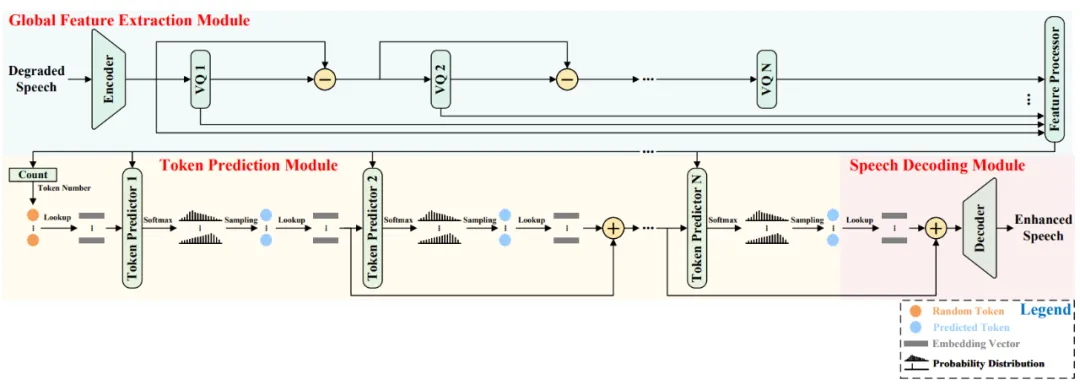
失真音频通过编码器+RVQ,得到量化特征(码表的索引组合),与编码特征结合后,经过一个令牌估计器(使用模型来做RVQ),然后通过解码器得到加强音频。
实际训练过程可以简化描述为:
神经语音编解码器训练:让编解码器学会将语音高效量化为离散令牌,同时保证令牌解码后的语音保真度; UDSE 核心模块训练:冻结编解码器参数后,仅训练特征处理器和令牌预测器;
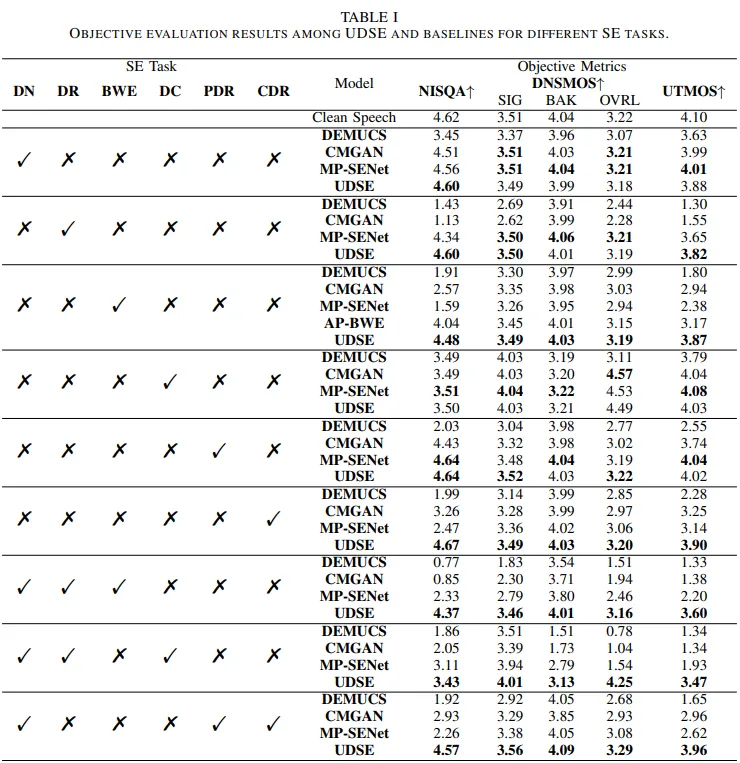
对比其他SOTA模型,UDSE在各种任务上都表现优异。
⏩Improving DF-Conformer Using Hydra
标题:Improving DF-Conformer Using Hydra For High-Fidelity Generative Speech Enhancement on Discrete Codec Token
论文地址:https://arxiv.org/abs/2511.02454
发布日期:2025-11-04
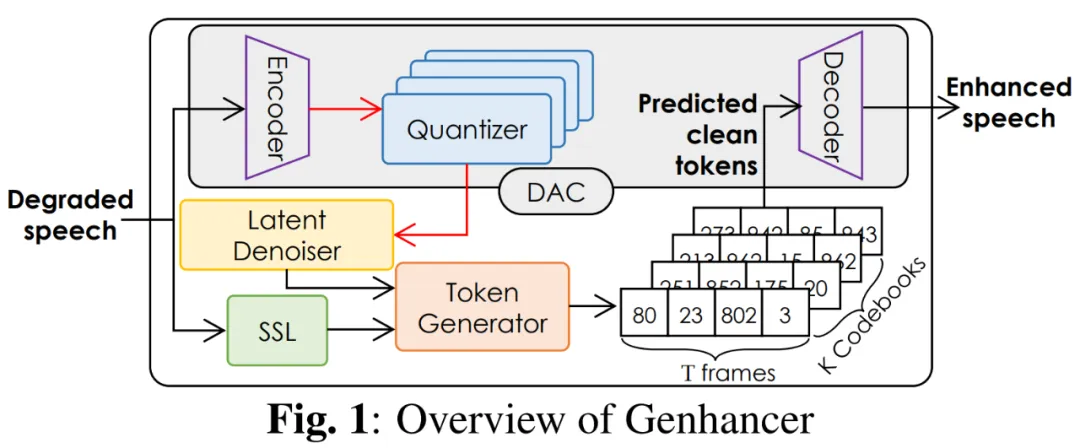
这篇文章针对Genhancer提出改进措施:Latent Denoiser和Token Generator的模型都源自DF-conformer,其中的FAVOR+存在注意力聚焦能力弱、特征多样性降低、语义混淆问题,可以替换为DC-Hydra(基于Mamba的一个模型结构)。另一个重点就是这条执行链路。
进入音频信号处理这个行业已经有三年了,“让用户听到的音频更好听”一直是我的目标(虽然这么讲有点官方)。”删除干扰,补充缺失“这样的混合型任务——通用语音增强,无疑是离目标更近的一步。根据目前的调研,我能看到多个方向的发展,并且这些成果达到的效果也还不错,内心还是十分开心的~
Oliver,浙江大学信息与通信工程硕士,在直播、语音通讯等场景拥有三年音频3A算法优化和落地经验。
参考资料:
第一类(传统降噪算法):可以看WebRTC ANR 流程解析,WebRTC-ANS-Git笔记: 第二类(过渡的AI降噪算法)和第三类(高纯度的AI降噪算法)的发展现状可以看语音分离/语音降噪模型归纳(一),语音分离/语音降噪模型归纳(二),语音分离/语音降噪模型归纳(三); 第四类的发展现状可以看目标说话人提取TSE/个性化语音增强PSE; 第五类的发展现状可以看AEC回声消除模型归纳。
