
 语音小管家
这笔融资是欧洲 AI 音频领域规模最大的早期融资之一,表明投资者对声音这一长期被忽视的领域越来越有信心,认为它是生成式媒体的下一个前沿阵地。
虽然创作者如今能够瞬间生成文本或视觉内容,但为视频添加真实音乐或音效仍然是一个缓慢、手动的过程。这正是柏林初创公司 Mirelo 想要打破的创意瓶颈。
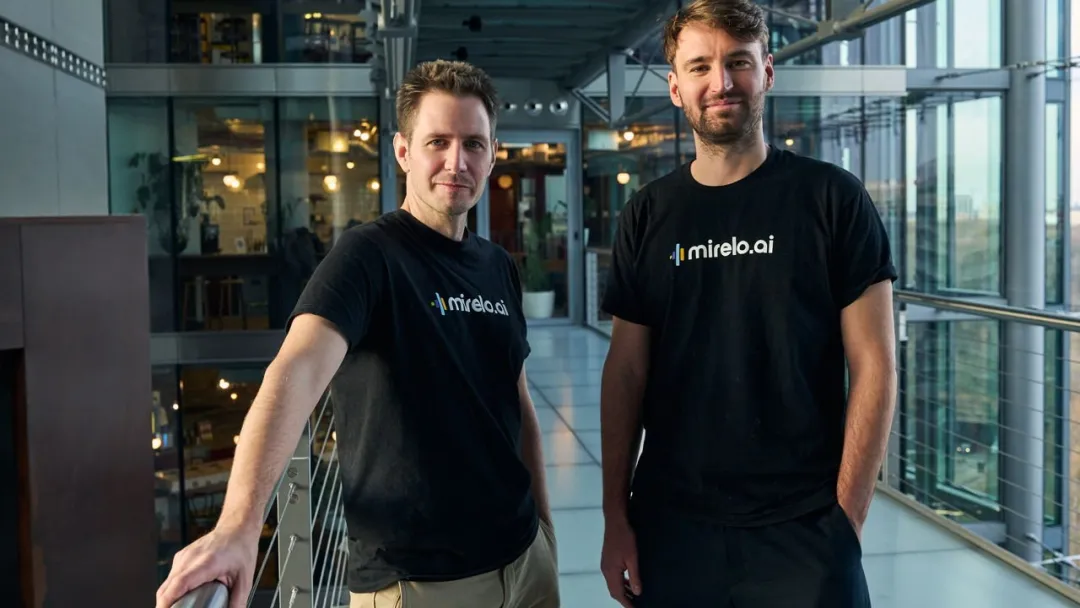
超越自动声音生成 Mirelo 于 2023 年由 CJ Simon-Gabriel 和 Florian Wenzel 创立,这两位研究人员在亚马逊的 AI 实验室工作时相识,他们对声音领域受到的关注太少感到不满。该公司旨在成为所有视觉内容的音频层,不仅节省时间,还改变观众对动态影像的体验,从电影到电子游戏再到社交媒体帖子。
Mirelo 的平台使用自己的声音生成基础模型,这些模型经过训练,能够理解视频中发生的事情以及它想要传达的情感暗示。当用户上传视频片段时,系统会瞬间生成与动作、情绪和节奏相匹配的同步音效或音乐。
这些模型所需的计算能力比典型的大型语言系统少五十倍,同时提供了更逼真、更细腻的效果。该公司最新发布的 Mirelo SFX v1.5 可以比实时更快地生成场景音频的多种变体,用户可以通过 Mirelo Studio 网络应用程序或开发者 API 访问。
Mirelo 运营在一个快速发展的生态系统中,其中包括专注于语音或音乐生成的美国公司 ElevenLabs、Boomy 和 AudioLDM,以及致力于将音频整合到视频创作中的 Kaiber 和 Runway。Mirelo 以其视频条件声音脱颖而出,提供了情感深度和精确同步,这是其他公司一直难以实现的。
Mirelo 计划扩大其研究团队,并深化在游戏、电影和数字叙事领域的合作伙伴关系。一个主要关注点是互动环境,比如自适应游戏世界或动态 AR 空间,在这些环境中,实时声音生成能够响应玩家行为。
