
 语音小管家
论文地址:https://arxiv.org/pdf/2509.23833v1
数据说明
语料库在安静的录音棚环境中采集,包含约29.8小时的耳语语音与平行录制的29.5小时正常语音,和同步采集的唇动视频。
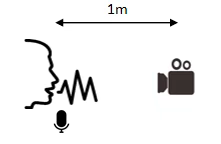
该语料库包含 167 名说话人,每位说话人朗读约 10 到 20 分钟不重复的诗歌文本。其中,121 名参与者使用高保真麦克风和同步的 RGB 相机进行录制,其余 46 名参与者仅录制音频信号。音频采用单通道高保真麦克风(Neumann U87)采集(48kHz,16-bit),背景噪声水平低于 20dB。如下图:
团队将数据集按大约 4:1:1 的比例划分为训练集、验证集和测试集,确保各子集在年龄和性别上分布均衡。这三个子集之间没有说话人重叠。另外,该语料库提供句级别的文本标注,耳语音频和正常语音音频路径的对应关系文件,及各说话人信息的文件。
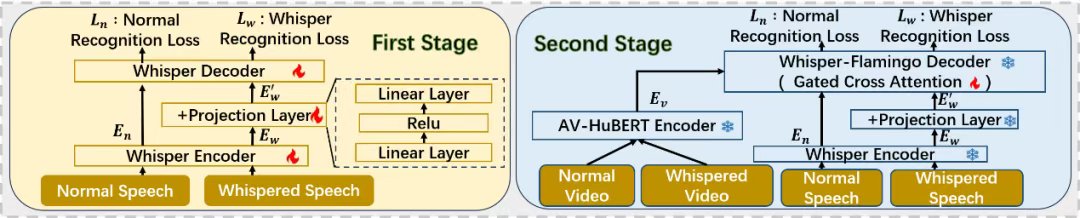
图1 模型架构
下图展示了经过处理的音频和视频数据示例,包括正常语音与对应耳语语音的梅尔频谱图,以及音频对应的可视化唇部运动。语音频谱图中观察到的显著差异,尤其是基频缺失的现象,证明了传统语音识别系统在处理耳语语音时具有声学挑战性。
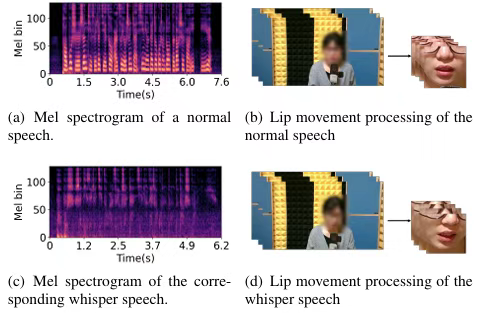
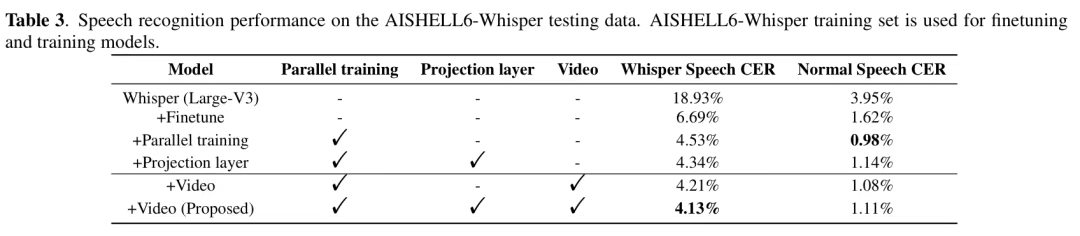
图2AISHELL6-Whisper测试集实验结果
