
 语音小管家
来源:AI随想录,作者:William
论文标题: DashengTokenizer: One layer is enough for unified audio understanding and generation 论文链接: https://arxiv.org/pdf/2602.23765v1 代码链接: https://huggingface.co/mispeech/dashengtokenizer
在音频 AI 的赛道上,“理解” 与 “生成” 仿佛两条平行线,擅长捕捉语义的模型,生成音频时总少了几分真实质感;专注高保真合成的模型,又在理解复杂场景时显得力不从心。传统方案要么靠 “语义编码器 + 声学令牌器” 双模型拼接,架构臃肿且部署成本高;要么通过多阶段蒸馏融合信息,却难免顾此失彼,让语义或声学细节大打折扣。
小米 MiLM Plus 团队推出的 DashengTokenizer,用一种 “反直觉” 的思路打破了这一僵局:不把语义知识硬塞进声学模型,而是将低维声学信息注入高维语义特征,仅靠一层线性投影就实现了两者的深度融合。这个看似简单的设计,不仅让单模型同时精通理解与生成,还挑战了 “VAE 是音频合成必备” 的行业共识,在 22 项跨领域任务中全面超越传统方案。
今天,我们就来深度拆解这个 “全能音频令牌器”,看看它如何用极简架构实现 “1+1>2” 的效果,以及背后那些值得关注的技术细节与实验结论。
一、基础概念
在深入论文前,我们先厘清几个关键术语,帮大家快速进入语境。
1.1 核心概念
1.2 传统方案 vs DashengTokenizer
二、核心痛点
长期以来,音频 AI 难以兼顾理解与生成,核心问题集中在三点:
架构割裂:理解用 “语义编码器”(如 Whisper、WavLM),生成用 “声学令牌器”(如 VQ-VAE、Encodec),两套系统需单独维护,部署成本高; 信息失衡:多阶段蒸馏要么导致语义信息丢失(生成优先),要么导致声学细节不足(理解优先),难以两全; 效率低下:VAE 等生成前置模块训练复杂,且与理解任务的表征不兼容,多任务适配难度大。
DashengTokenizer 的核心创新,就是用 “声学注入 + 统一表征” 一次性解决这三大痛点,实现 “一层网络通吃所有任务”。
三、核心思路
3.1 创新1:范式重构 —— 从 “语义蒸馏” 到 “声学注入”
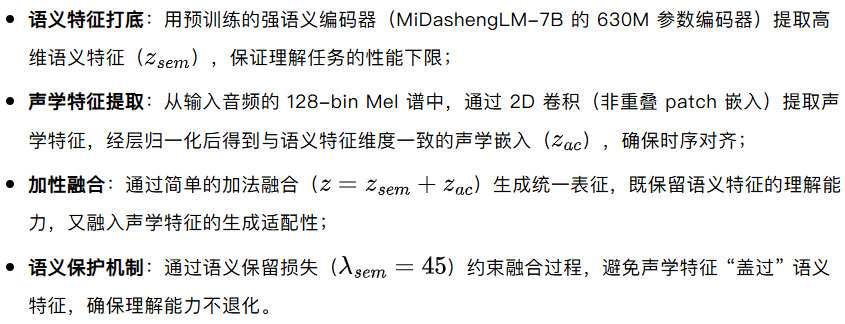
这是论文最核心的突破:颠覆传统 “将语义知识蒸馏到声学模型” 的思路,反其道而行之 —— 以强语义编码器为基础,注入声学细节,具体逻辑如下:
3.2 创新2:极简架构 —— 单阶段训练,仅增 0.66M 参数
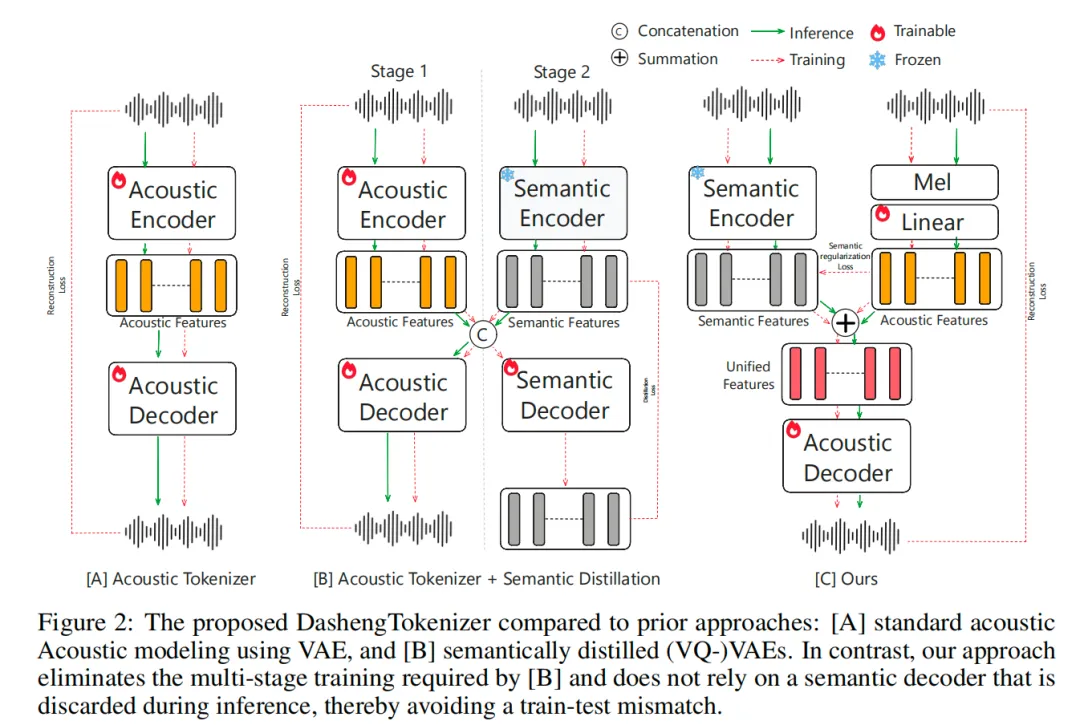
DashengTokenizer 的架构极简却高效,核心组件仅 3 个,无冗余模块,且采用单阶段训练流程:
单阶段训练流程(端到端优化)
输入:282k 小时多领域音频(语音 / 音乐 / 环境音)+ 对应语义标注 / 文本; 特征处理:并行提取语义特征( 多损失联合训练: 生成侧损失:Mel 谱重建损失( 理解侧损失:语义保留损失(防止理解能力退化); 输出:统一表征(适配理解任务)+ 波形重建(验证生成能力)
3.3 创新3:无 VAE 生成 —— 打破垄断,效率翻倍
传统音频生成依赖 VAE 进行 latent 空间建模,流程复杂且训练缓慢。DashengTokenizer 直接用统一表征驱动流匹配生成模型(DiT 架构),实现三大突破:
无需 VAE 预训练,生成链路更简洁; 训练收敛速度提升:比 VAE 基线少 50k 训练步,CLAP 分数等指标提前 190k 步达到同等水平; 生成质量更优:文本到音频(TTA)、文本到音乐(TTM)任务中,多项指标超越 VAE 基线。
四、实验验证
论文在理解、生成、重建三大类任务中进行全面测试,对比主流令牌器(如 DAC、UniFlow-Audio、MingTok-Audio)和编码器(如 Whisper-Large-V3、SPEAR-XLarge):
4.1 理解任务:横扫多领域,多项任务夺冠
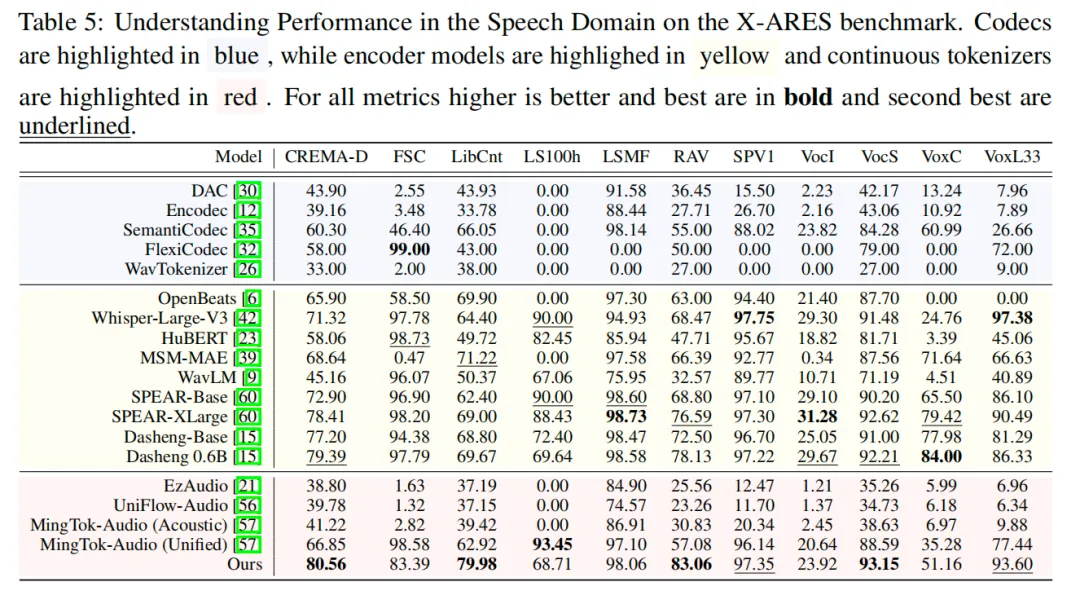
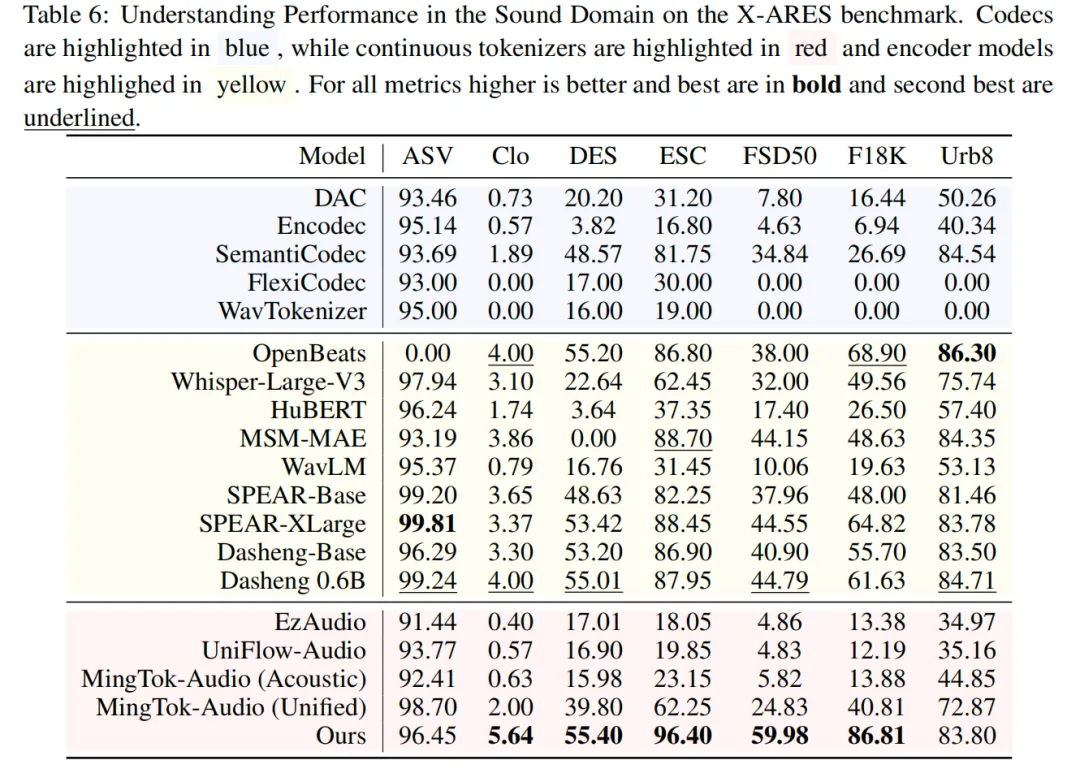
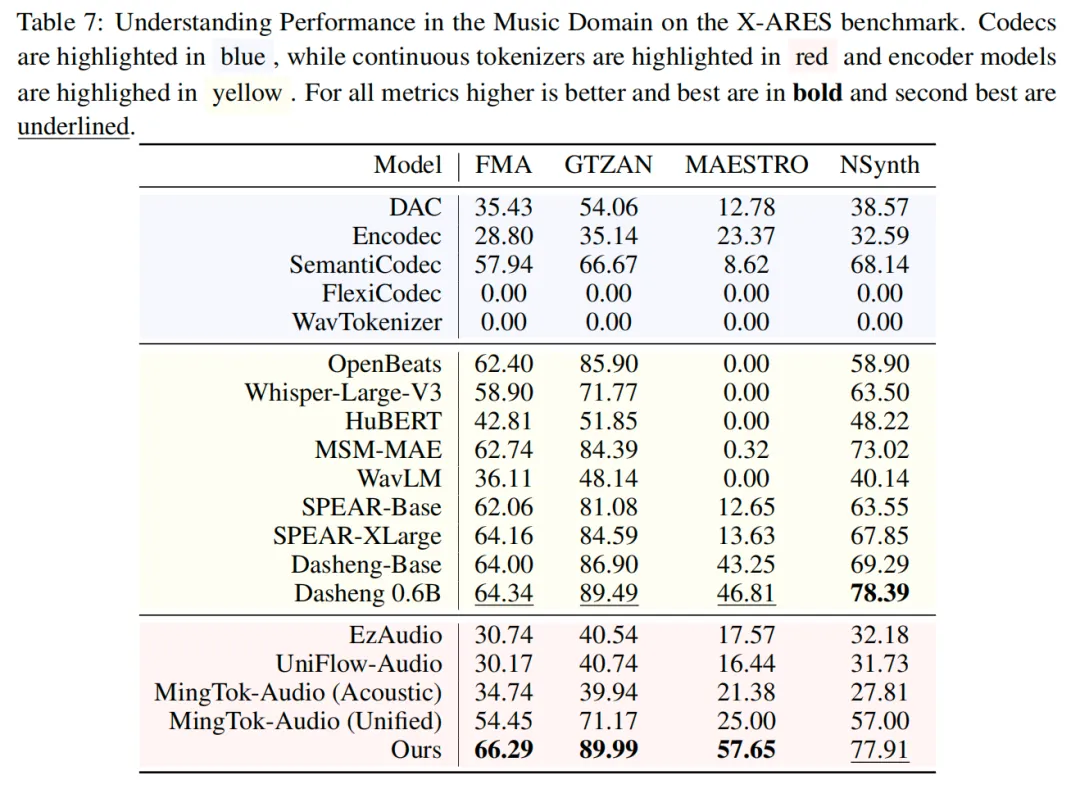
在 X-ARES 基准的 22 个理解任务中(覆盖语音、音乐、环境音),DashengTokenizer 表现惊艳,尤其在需要声学细节辅助的任务中优势显著:
关键结论:统一表征中的声学注入,对情感识别、音乐分类等 “需声学细节” 的理解任务提升尤为显著,证明声学与语义的互补价值;但在纯语义任务(如 FSC 意图分类、LS100h 语音识别)中略逊于专用语义编码器,因声学方差会轻微干扰纯语义抽象。
4.2 生成任务:无 VAE 超越基线,收敛更快
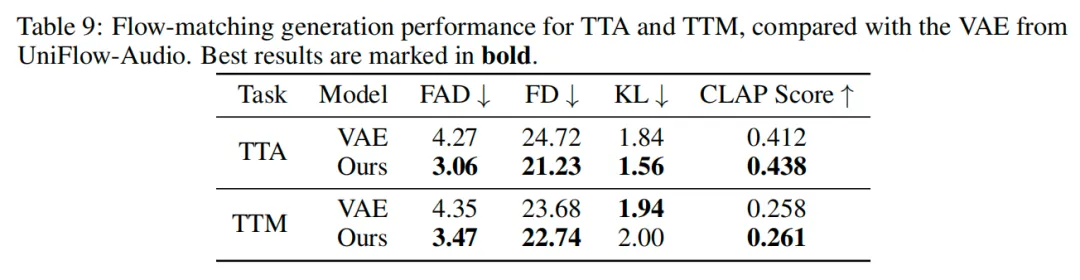
在文本到音频(TTA)和文本到音乐(TTM)任务中,DashengTokenizer 替代 VAE 驱动流匹配模型,表现超越传统方案:
关键发现:
TTM 任务中,DashengTokenizer 的 CLAP 分数(0.261)超越 VAE 基线,证明语义 - 声学融合能提升文本与音频的对齐度; 训练效率大幅提升:在 KL 散度和 CLAP 分数指标上,比 VAE 基线少 50k 训练步即可达到同等水平,收敛速度更快。
4.3 重建任务:保真度媲美顶尖令牌器
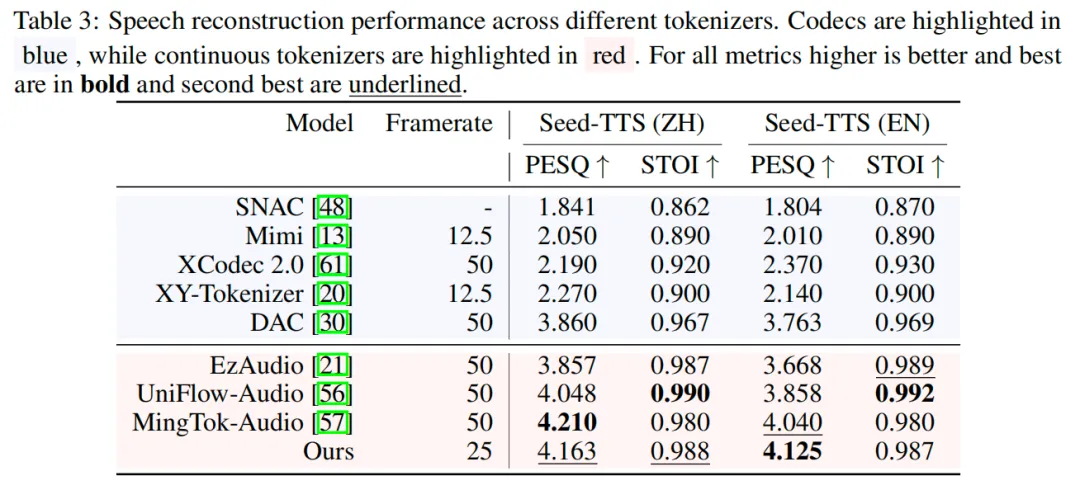
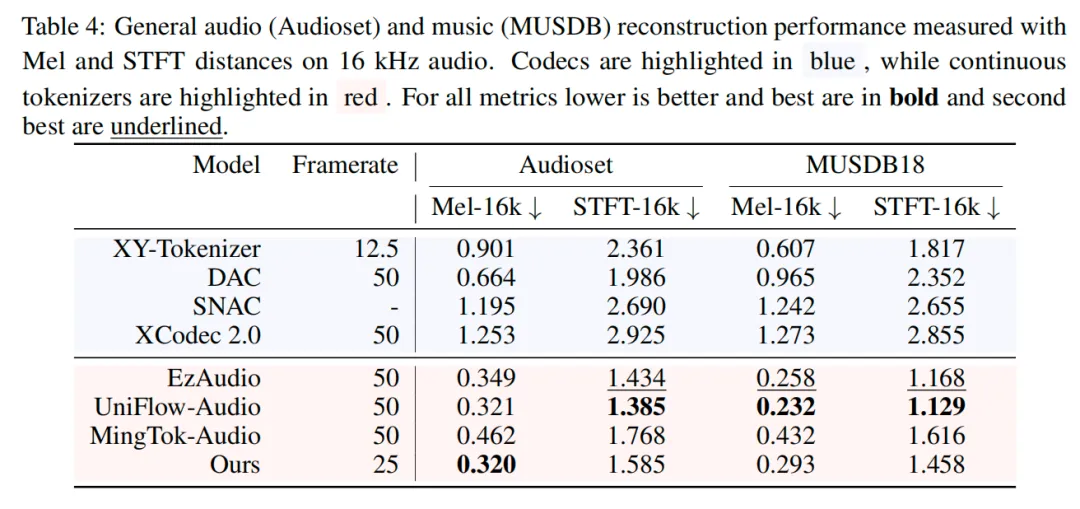
关键结论:尽管帧率仅 25Hz(低于多数顶尖令牌器的 50Hz),但 DashengTokenizer 的重建保真度仍处于第一梯队,证明统一表征能有效保留声学细节,无需高帧率冗余建模。
4.4 语音增强:兼顾质量与身份保留
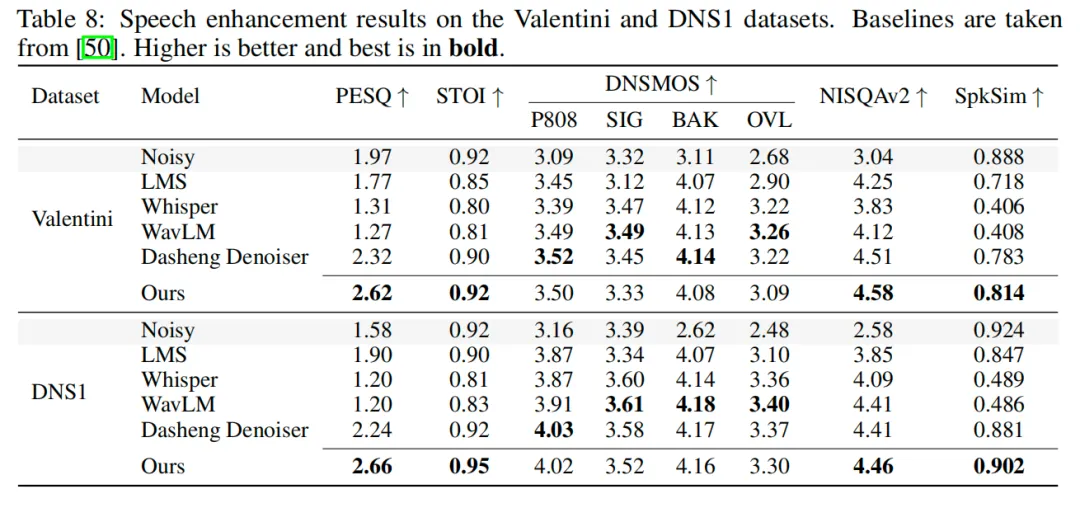
在 Valentini 和 DNS1 噪声抑制数据集上,DashengTokenizer 的表征用于 latent 空间去噪,表现超越传统方案,同时保留说话人身份:
关键发现:统一表征同时保留语义(降噪后可懂度)和声学(说话人音色)信息,在提升语音质量的同时,更好地保留说话人身份,避免降噪导致的 “音色失真”。
4.5 消融实验:验证核心设计的必要性
论文通过消融实验,验证了声学注入和统一表征的核心价值:
关键结论:
语义特征是理解任务的核心,声学特征单独使用时理解性能极差; 统一特征能在不损失生成保真度(PESQ 仅降 0.015)的前提下,提升理解任务性能,证明声学注入的互补价值; 声学注入对情感识别、音乐分类等 “非纯语义任务” 的提升更显著。
五、研究价值
5.1 核心价值
范式革新:首次提出 “声学注入” 思路,颠覆传统语义蒸馏逻辑,为统一理解与生成提供新路径,证明 “一层网络即可兼顾双任务”; 极致高效:单阶段训练 + 极简架构,仅新增 0.66M 参数,大幅降低开发与部署成本,训练收敛速度比 VAE 基线快 25%; 打破依赖:实现无 VAE 生成,挑战 “VAE 是音频合成前提” 的行业共识,简化生成链路; 全场景适配:统一表征覆盖语音、音乐、环境音,支撑理解、生成、增强等多任务,泛化能力强。
5.2 典型应用场景
通用音频 AI 助手:一个模型同时处理 “语音指令理解”“环境音预警”“个性化语音生成”,简化系统架构; 内容创作工具:文本生成音频 / 音乐时,兼顾内容准确性(语义约束)和听觉体验(声学保真); 语音增强与编辑:降噪、去回声的同时保留说话人音色,适配会议录音、直播音频处理; 跨模态交互:统一表征无缝对接文本、图像模型,支撑 “文本 + 图像→音频” 等复杂跨模态任务。
六、总结
DashengTokenizer 的核心贡献,是用 “极简架构 + 创新范式” 解决了音频 AI 领域 “理解与生成割裂” 的长期痛点。它没有走 “堆砌参数、多阶段蒸馏” 的老路,而是通过 “声学注入” 这一巧妙设计,让语义与声学特征互补共生,仅用一层线性投影就实现了 “一层网络通吃理解与生成”。
对于技术开发者来说,这意味着可以用更低的成本构建通用音频 AI 系统,无需为不同任务单独设计模型;对于企业来说,单模型多任务适配能大幅降低部署与维护成本,加速音频 AI 的落地;对于行业来说,它打破了 VAE 在生成任务中的垄断,为音频大模型的轻量化、高效化发展提供了新方向。
