
 语音小管家
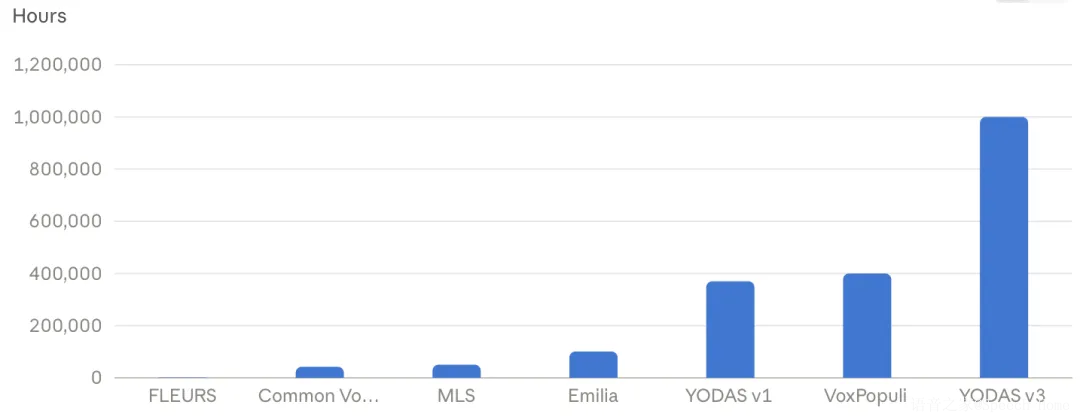
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。
相比此前主要面向语音识别的 YODAS,v3 加入更高带宽、多通道和更丰富的时间戳标注,使同一套数据可以进一步用于 TTS、神经音频编解码、语音增强和立体声/空间语音生成。
- 高采样率不只是文件标称值: 团队根据实际频谱重新估算音频有效带宽,92% 的数据达到至少 32kHz 等效采样率,67% 达到 44kHz,可按音频质量筛选训练数据。
- 超过 70% 为真正多通道音频: 团队会检测左右声道是否实际不同,避免把复制的单声道算作立体声,为大规模立体声和空间语音模型训练提供数据。
- 同时提供转写、时间戳和翻译: 约 75% 的数据带有转写,其中 95% 带词级时间戳;约 60% 的非英语数据还提供带时间戳的英语翻译。数据以 CC BY 3.0 许可开放。
📎相关地址:
