
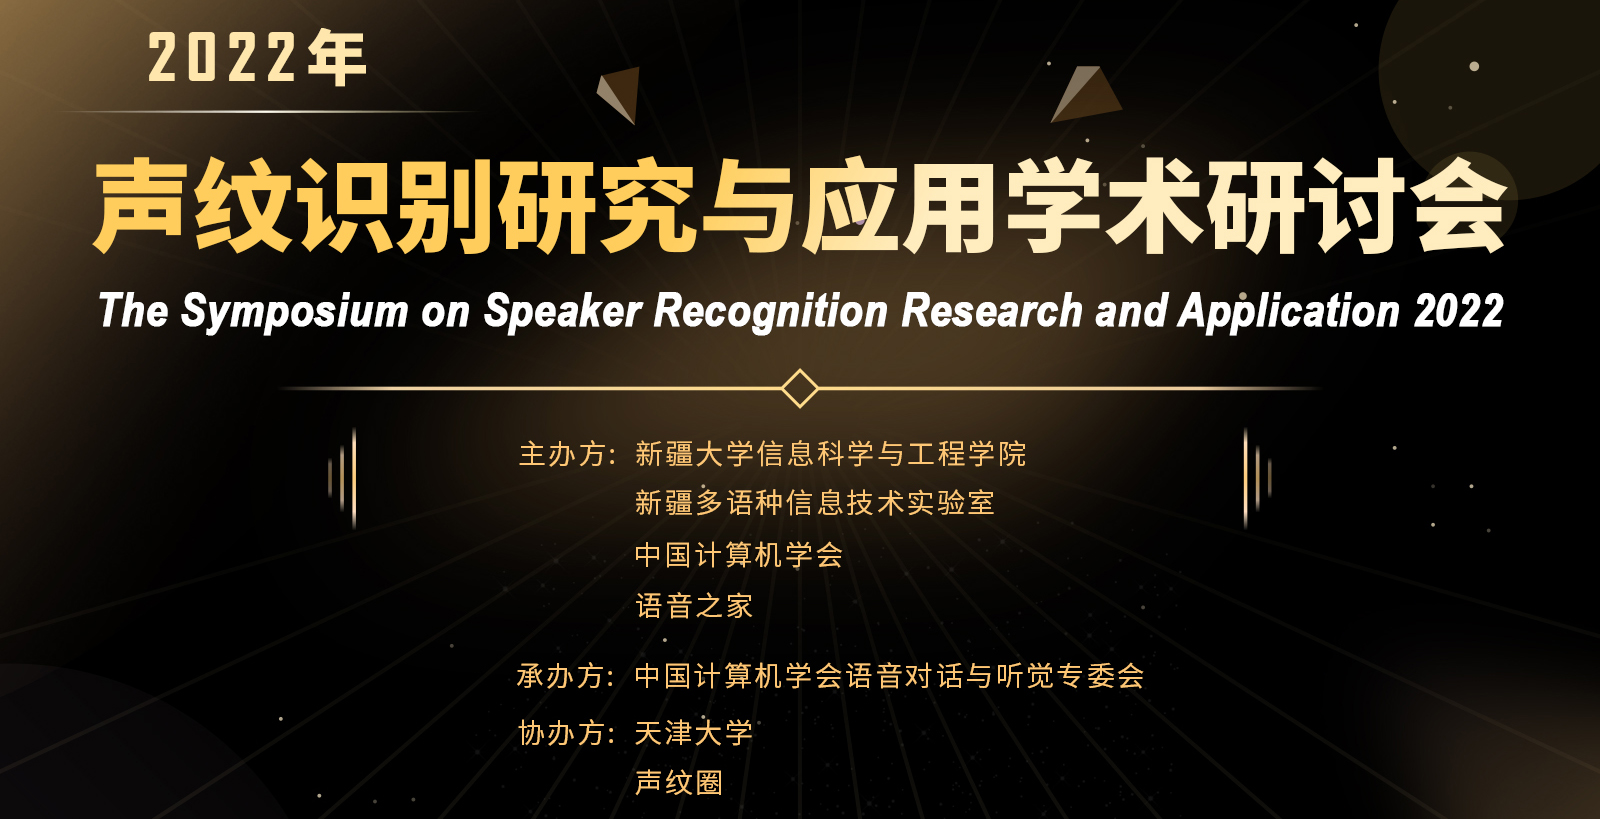
2022年11月12日,第四届声纹识别研究与应用学术研讨会在线上成功举办。本次会议由新疆大学信息科学与工程学院、新疆多语种信息技术实验室、中国计算机学会、语音之家主办,中国计算机学会语音对话与听觉专委会承办,天津大学、声纹圈协办。新疆大学黄浩和天津大学王龙标两位老师共同担任大会主席。
上午9:00,黄浩老师宣布研讨会开始,并简要介绍本次研讨会的筹备情况以及报告内容。随后,中国工程院院士、新疆大学教授吾守尔·斯拉木,新疆大学信息科学与工程学院党委书记、院长、教授汪烈军,CCF语音对话与听觉专委会副主任、清华大学教授郑方共同致辞,针对声纹识别语音工程提出意见建议,期待声纹识别能够面向应用、面向场景,并预祝大家在声纹识别开发领域取得更多的成果。
接下来的报告正式开始,共包括两个环节。
主旨演讲嘉宾:李海洲、MAK Man-Wai
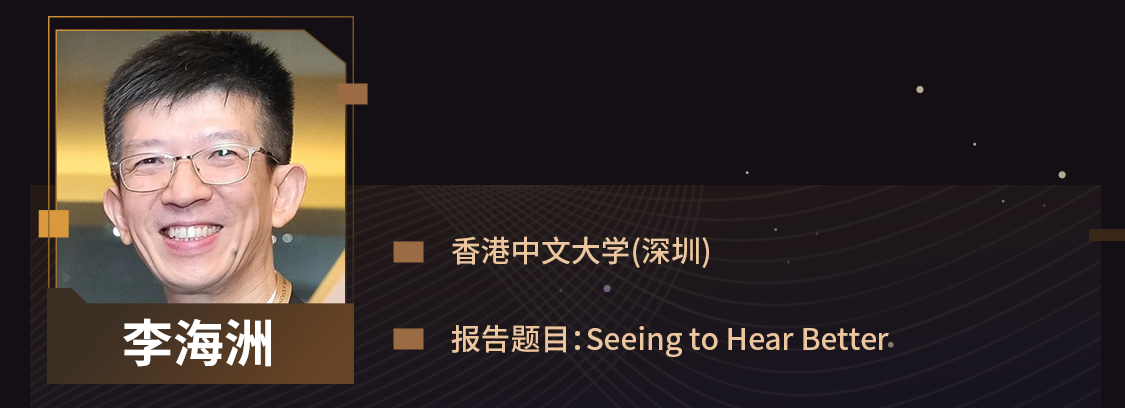
第一位演讲嘉宾是来自香港中文大学(深圳)的李海洲,分享的主题是《Seeing to Hear Better》。Humans have a remarkable ability to pay their auditory attention only to a sound source of interest, that we call selective auditory attention, in a multi-talker environment or a Cocktail Party. However, signal processing approach to speech separation and/or speaker extraction from multi-talker speech remains a challenge for machines. In this talk, we study the deep learning solutions to monaural speech separation and speaker extraction that enable selective auditory attention. We review the findings from human audio-visual speech perception to motivate the design of speech perception algorithms. We introduce their applications in speech enhancement, speaker extraction, and speech recognition. We will also discuss the computational auditory models, technical challenges and the recent advances in the field.
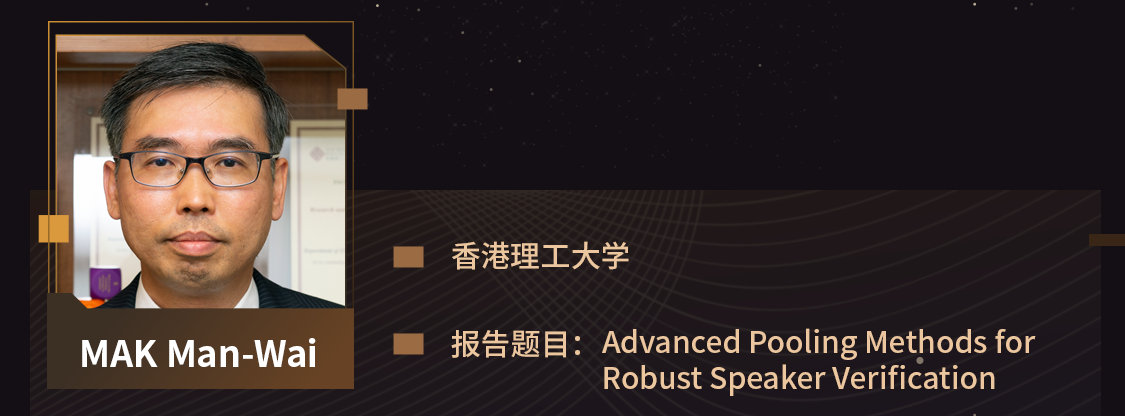
MAK Man-Wai 老师分享的主题是《Advanced Pooling Methods for Robust Speaker Verification》。Speaker embedding plays a vital role in modern speaker verification systems, and most systems aggregate the frame-level information at the last convolutional layer. This talk discusses two of our recent approaches to aggregating this information. In the first approach, we argue that it is disadvantageous to compute the global statistics of the temporal feature maps at the last convolutional layer because of the high non-stationarity in the feature maps. We advocate exploring spectral representations and performing aggregation in the spectral domain. To this end, we developed an aggregation method called attentive short-time spectral pooling (attentive STSP) to exploit the local stationarity of the feature maps. In attentive STSP, for each utterance, we compute the spectral representations through a weighted average of the windowed segments within each spectrogram by attention weights and aggregate their lowest spectral components to form the speaker embedding. Because most of the feature map energy is concentrated in the low-frequency region of the spectral domain, attentive STSP facilitates information aggregation by retaining the low spectral components only. In our second approach, we argue that it is difficult to determine the number of heads in the multi-head attention mechanism in today's speaker embedding networks because of the lack of statistical interpretation of individual heads. Also, the weights for each attention head are normalized across frames, which is not a natural way of controlling the roles played by individual attention heads. To overcome these limitations, we propose a novel attention mechanism in which the weight vectors in the last layer of the attention network are treated as prototype vectors. We derive EM formulations such that the prototype vectors are an analogy to the cluster means of a Gaussian mixture model (GMM). To encourage the prototype vectors to represent diverse, non-overlapping information, we propose incorporating the Gumbel-softmax with a straight-through estimator into the attention network.
邀请报告演讲嘉宾:何亮、许敏强、王东、杜俊、钱彦旻、李明、张晓雷、张鹏远、谢磊、李琳、王龙标
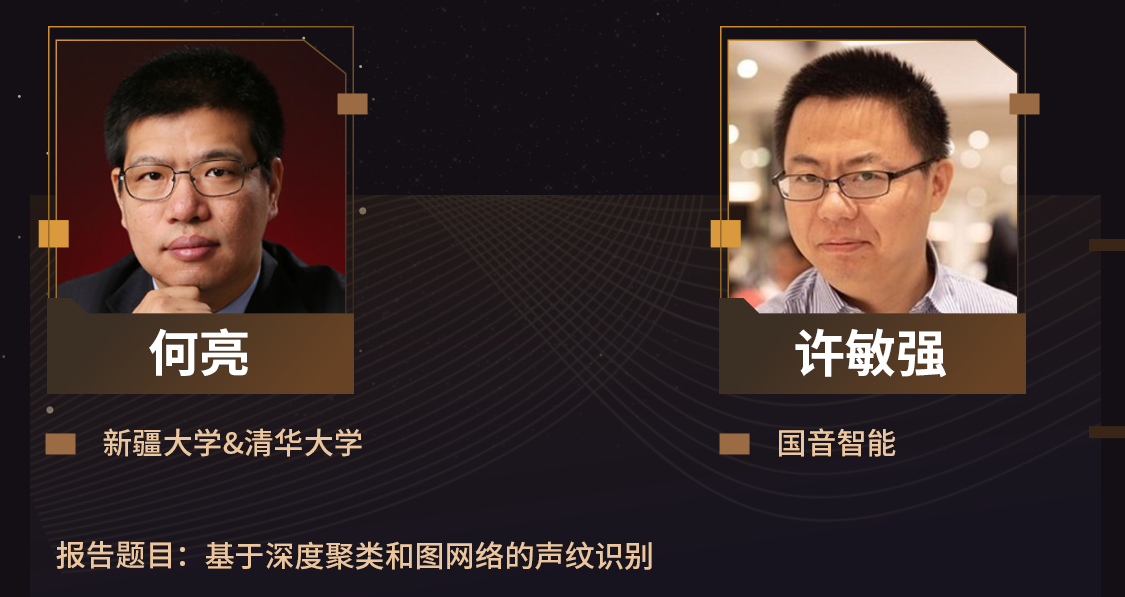
何亮老师和许敏强老师分享的主题是《基于深度聚类和图网络的声纹识别》。目前,主流的声纹识别算法均采用卷积神经网络提取低维嵌入,采用余弦或概率线性判别分析等做出判决决策。神经网络的损失函数对低维嵌入质量有显著影响,主流的各类Softmax(X-Softmax)损失侧重惩罚分类错误,但对属于同一类别的样本分布约束较低。此外,如何降低语音内容等对声纹信息的影响一直是领域研究重点。为此,团队提出了基于深度聚类的声纹识别方法,从两个层面解决上述问题。对于提取的每个低维嵌入,在空间中,其自身位置及其相邻低维嵌入组成的局部结构是不同的。团队提出了图神经网络后端以挖掘空间信息进行分类。在VoxCeleb、NIST SRE14等数据库上,验证了上述所提各方法的显著优势。
大规模(即百万级或以上)数据集上,一个明显的挑战是聚类模式的复杂变化,这使得传统的聚类方法难以满足需求。现有全图聚类的方法,在大规模数据集上,存在显存瓶颈的问题;而子图聚类的方法,则存在计算效率不高、且缺少全局信息的问题。我们提出了一种STAR(Structure-Aware)的图网络聚类方法,针对上述两个问题进行改进,兼顾了性能和效率,使聚类算法能够高效处理10^7的数据。
王东老师分享的主题是《说话人识别模型的可解释性》。深度神经网络是一个黑盒,到目前为止,研究者对神经网络识别说话人的基础原理依然不是很清晰。图像领域已经提出了若干用于解释模型决策行为的可视化工具,如Class Activation Mapping(CAM)。然而,这些工具是否可用于语音领域是存疑的,因为人们无法从频谱中直观判断解释结果是否合理。本报告结合研究组在说话人识别可解释性方面的工作进展,讨论若干可供探索的新方向。
杜俊老师分享的主题是《家居场景下音视频说话人日志和语音识别评测介绍(MISP 2022)》。近年来,随着DIHARD和CHiME等国际评测的举办,单模态音频说话人日志和语音识别技术得到不断进步,但另一方面,这些技术在家居和会议等多人复杂声学场景下也遇到了性能瓶颈。因此,今年基于多模态信息的语音处理(MISP 2022)国际评测将关注家居场景下的音视频说话人日志和语音识别任务,通过视频模态中脸部和唇形等信息的引入,期待进一步提升实际复杂场景下的说话人日志和识别性能。本报告将从任务和数据集的定义、基线系统的构建、挑战性分析等几个方面展开介绍,希望大家可以共同参与并探讨这个技术方向的未来发展。
钱彦旻老师分享的主题是《Self-Supervised Learning for High-Performance Robust Speaker Verification》。Automatic speaker verification task has made great achievements using deep learning approaches with the large-scale manually annotated dataset. However, it's very difficult and expensive to collect a large amount of well-labeled data for system building. Recently, self-supervised speaker verification has attracted a lot of interest by the reason of its no-dependency on labeled data. This talk will briefly introduce an advanced self-supervised learning framework which can construct a robust speaker verification system with high performance without using any labeled data. Based on iterative pseudo labeling framework, we introduced Cluster-Aware DINO to generate pseudo label, which can be trained without exploiting negative pairs. In addition, we proposed dynamic loss-gate and label correction strategy to alleviate the performance degradation caused by unreliable labels. With these methods, the gap between unsupervised and supervised representation learning is dramatically reduced for speaker verification, and an approaching performance of the fully supervised system is obtained with our self-supervised learning method on speaker verification.
李明老师分享的主题是《复杂场景下鲁棒伪造音检测及变声溯源》。首先介绍实验室在带噪语音、编解码语音、部分伪造语音等复杂场景下的伪造音检测研究进展;其次从可逆变声、伪造方法溯源、源说话人溯源等角度介绍伪造溯源方向的近期工作。
张晓雷老师分享的主题是《鲁棒声纹识别与安全》。尽管声纹识别的研究随着深度学习的发展而获得了长足的进步,现代声纹识别系统仍然易受噪声的干扰。第一类噪声干扰是环境噪声,包括加性噪声、混响、其他干扰说话人等,这是声纹识别系统长期以来面临的挑战问题;第二类噪声干扰是针对神经网络脆弱性而人工产生的噪声,这是近年来出现的新问题。本次报告将分别介绍这两类噪声干扰下声纹识别的研究进展。对于环境噪声干扰下的鲁棒声文识别,将介绍声纹识别与声学前端相结合的研究进展,重点关注远场强混响环境下的多阵列声纹识别及数据集构建;对于人工产生对抗噪声的声纹识别,将分别介绍声纹识别对抗攻击与防御的研究进展。
张鹏远老师分享的主题是《基于预训练的伪造语音检测研究进展》。本报告主要介绍中科院声学所团队在将预训练引入伪造语音检测方面的研究进展。传统的伪造语音检测方法面对未知伪造方法、多语种等跨领域的伪造语音泛化性较差,难以迁移使用。从根本上讲,已知伪造算法数量有限,单纯增加训练数据的方法不足以使系统获得对于域外数据的合理估计。预训练是提升模型概括能力的一个重要手段。通过对大量语音的自监督学习,可以得到具有良好表达能力的前端,迁移至鉴伪任务后有助于减少过拟合。同时,相比于随机初始化参数,使用预训练的分类器同样可以提高模型的判别能力。不仅如此,声纹同样可以用于预训练。声纹识别系统使用大量真实语音训练,且伪造语音与真实语音的声纹信息存在差异,因此通过声纹识别系统提取的特征可以用于伪造语音检测。基于预训练声纹识别的伪造语音检测不仅可以利用预训练克服训练数据不足的问题,还可以与声纹识别有机结合,仅训练少量参数即可使用同一模型同时完成声纹识别和伪造语音检测,实现伪造语音与人物身份的一体化鉴别。
谢磊老师分享的主题是《Exploring Deep Fake and Transfer Learning in Robust Speaker Verification》。报告包含两部分内容,首先是关于声纹深度伪造和隐私保护相关的研究,主要采用语音转换与对抗训练联合优化生成文本与音色都和目标语音一致的欺骗语音,来攻击声纹系统。我们探索了说话人确认系统和反欺骗对策系统的后端融合方案,旨在让说话人模型能够感知到攻击语音,同时保证说话人确认系统性能不下降。此外对于隐私保护,我们在说话人隐私保护竞赛(VoicePrivacy Challenge)中采用平均说话人向量作为伪说话人向量匿名说话人信息获得了突出的效果。本报告另一部分是迁移学习在远场声纹中解决域不匹配问题上的探索。在远场声纹中,域不匹配体现在两个方面,预训练数据和域内训练数据的不匹配以及注册语音和测试语音之间的不匹配。对于这两种不匹配情况,我们提出两阶段迁移学习的框架。第一阶段采用说话人感知权重迁移方法,使用域内数据集和域外数据集的一部分对预训练的域外模型进行微调。说话人感知是通过域外数据预训练的域外模型评估域内数据的分类准确度来获得的,旨在使域内模型保持其强大的说话人判别能力。第二阶段在教师-学生框架下,使用说话人中心化迁移学习方法来学习领域不变的说话人表征空间。
李琳老师分享的主题是《基于语音预训练模型的无监督说话人识别方法》。近年来,语音预训练模型推陈出新,成为语音领域中一种极有潜力的训练范式。鲁棒的说话人识别系统通常需要大量带精确标注的数据集进行训练,而人工标注一个新数据集成本较高,且可能涉及隐私问题。我们探索着将预训练的语音模型扩展应用到无监督的说话人识别任务中,提取通用的嵌入式表征,使用无监督聚类算法获得说话人伪标签,结合在线和离线的标签纠正方法,经过有限次迭代更新即可获得较为鲁棒的说话人模型。这种基于语音预训练模型的无监督说话人识别性能可接近有监督学习的效果,为海量无标签数据的有效使用提供一个可行思路。
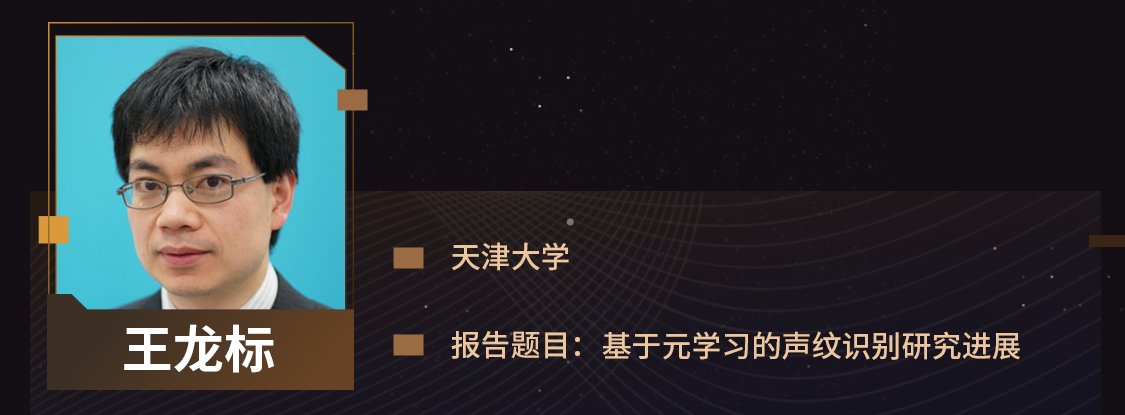
王龙标老师分享的主题是《基于元学习的声纹识别研究进展》。本报告首先简要介绍天津大学认知计算与应用天津市重点实验室在声纹识别领域的最新研究内容,然后介绍基于元学习的声纹识别的经典方法及主要问题,最后围绕跨域挑战的信道不匹配与未见域子问题介绍基于度量优化、域不变转换、高阶梯度元泛化等基于元学习的跨域声纹识别研究进展。

在以上演讲环节结束后,新疆大学黄浩老师展望了下一届声纹识别研究与应用学术研讨会。嘉宾们讨论了下次会议的相关事宜并提出了宝贵的意见。
至此,本次会议圆满结束。本次会议直播间累计人次3600+,我们期待下一届声纹识别研讨会再与大家见面。
2022声纹研讨会嘉宾PPT:
链接:https://pan.baidu.com/s/1eUccR59xfw2ykjQYZOpQCw
提取码:rwrr
微信讨论群
扫扫码添加语音小管家,进入声纹识别讨论群
往期研讨会回顾