
 蘑菇炖提莫
一、算法
Speaker recognition以2012年为分水岭,由statistics-based machine learning,跨到了以deep learning为主线的算法。随后,bottleneck feature、d-vector、x-vector、j-vector等DNN-based的系统陆续出现,随后attention mechanism、Learning to rank等思想被用于改良训练过程。
对这些算法按照3类分别做简要阐述:1)iVector-based;2)dnn-based;3)基于attention mechanism、Learning to rank等思想的改良算法。


1.1.iVector-based
2011年,第十一届全国人机语音通讯学术会议(NCMMSC2011)上,大神邓力给伙计们开了小灶,分享了他在微软DNN-based speech recognition研究结果(30% relative improvement),群情激奋。就在前一年,ABC(Agnitio/BUT/CRIM)在NIST SRE 2010 workshop上分享了JFA(Joint Factor Analysis,联合因子分析)的改良版(即iVector[1][16]),群情激奋。
作iVector中Total Variability的做法(M=m+Tw),将JFA复杂的训练过程以及对语料的复杂要求,瞬间降到了极致,尤其是将Length-Variable Speech映射到了一个fixed- and low-dimension的vector(identity vector,即iVector)上。于是,机器学习爱好者群情激奋,所有机器学习的算法都可以用来解决声纹识别的问题了。
PLDA(Probabilistic Linear Discriminant Analysis,概率形式的LDA[17])是生成型模型(generated model),被用于对iVector进行建模、分类,实验证明其效果最好。PLDA是一种信道补偿算法,因为iVector中,既包含说话人的信息,也包含信道信息,而我们只关心说话人信息,所以才需要做信道补偿。在声纹识别训练过程中,我们假设训练语音由I个说话人的语音组成,其中每个说话人有J段不一样的语音,并且我们定义第i个说话人的第j段语音为Xij。那么,我们定义Xij的生成模型为:

作者:李稀敏链接:https://zhuanlan.zhihu.com/p/34440000来源:知乎著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
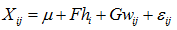
F、G是矩阵,包含了各自假想变量空间中的基本因子,这些因子可以看做是各自空间的基底(basis)。 F的每一列,相当于类间空间的特征向量;G的每一列,相当于类内空间的特征向量。而向量Hi和Wij可以看做是该语音分别在各自空间的特征表示。如果两条语音的hi特征相同的似然度越大,那么它们来自同一个说话人的可能性就越大。
PLDA的模型参数包括4个,mean、F和G、sigma,采用EM算法迭代训练而成。通常,我们采用简化版的PLDA模型,忽略类内特征空间矩阵的训练[18],只训练类间特征空间矩阵F。即:

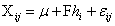
1.2.DNN-based
早期DNN-based Speaker Recognition,用DNN代替GMM去计算Posterior Statistics,延续了DNN-based Speech Recognition的研究成果。2014年,Google提出d-vector[3]后,一系列的DNN-based方法被提出,如x-vector、j-vector等[2][8][9]。下面分别介绍下此类算法的基本思路。
- d-vector
DNN训练好后,提取每一帧语音的Filterbank Energy 特征作为DNN输入,从Last Hidden Layer提取Activations,L2正则化,然后将其累加起来,得到的向量就被称为d-vector。如果一个人有多条Enroll语音,那么所有这些d-vectors做平均,就是这个人的Representation。DNN的网络结构如图1.2所示。


因为d-vector是从Last Hidden Layer提取的,通过移除Softmax Layer,可以缩减Model Size。而且,这也可以让我们在不改变Model Size的情况下,在训练过程中使用更多的说话人数据来做训练(因为Softmax Layer被移除了,不用考虑Softmax Layer的节点数)。DNN的训练过程,可以详细阅读参考文献[3]。
开源代码:https://github.com/rajathkmp/speaker-verification
- x-vector
x-vector是Daniel Povey教授在论文[13]中提出的概念,用于描述从TDNN网络中提取的embeddings特征,如图1.3所示。


上面的网络结构中,有一个Statistics Pooling Layer,负责将Frame-level Layer,Map到Segment-Level Layer,计算frame-level Layer的Mean和standard deviation。TDNN是时延架构,Output Layer可以学习到Long-Time特征,所以x-vector可以利用短短的10s左右的语音,捕捉到用户声纹信息,在短语音上拥有更强的鲁棒性。TDNN的训练方式可以参考文献[13]。
提取x-vector,LDA降维,然后以PLDA作为back-end,便可以做Verification。
开源代码:https://github.com/kaldi-asr/ka
- j-vector
提取i-vector依赖于较长(数十秒到数分钟)的语音,而Text-Dependent Speaker Verification任务中,语音很短(甚至只有1秒左右),所以i-vector不适用于Text-Dependent Speaker Verification。Text-Dependent Speaker Verification属于Multi-task,既要验证身份,又要验证语音内容。j-vector[8]就是为了解决Text-Dependent Speaker Verification而提出的,如图1.4所示,j-vector从Last Hidden Layer提取。
作论文[8]中指出,相比于Cosine Similarity、Joint PLDA,使用Joint Gaussian Discriminant Function作为back-end时,实验效果最佳。

