
 语音小管家
语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。
来自墨尔本大学和新南威尔士大学的研究者提出了VoxMem,一个面向大型音频语言模型(Large Audio Language Model,LALM)的多会话语音记忆基准。它从“要记住哪类声学证据”和“要对记忆做什么操作”两个维度系统考察模型的语音记忆,并让每道题在 8K 到 64K token 的历史长度下保持不变,从而单独剥离出历史长度的影响。对 15 个 LALM 的评测显示,32K 下没有一个模型的整体准确率超过 40%。
论文标题:VoxMem: Benchmarking Multimodal Memory in Large Audio Language Models
作者:Yang Xiao, Vidhyasaharan Sethu, Eun-Jung Holden, Ting Dang(墨尔本大学、新南威尔士大学)
论文地址:https://arxiv.org/abs/2609.32607
代码:https://github.com/swagshaw/voxmem
数据:https://huggingface.co/datasets/AudioMemory/voxmembench
⏩现有语音评测缺了什么
论文系统梳理了现有的长音频理解基准和语音对话基准,指出三方面不足。
声学证据覆盖不全。有的基准只考词汇内容,其余的也只涉及少数几类声学线索,很少考模型能否记住谁在说话、用什么语气、环境里能听到什么。
记忆操作零散。检索、跨会话整合、状态追踪、证据不足时拒答,各基准只覆盖其中一部分,而且是临时挑选的,缺少统一框架。
没有多会话设置。现有基准要么是一段长独白,要么是一段连续对话,有的只有几轮。真实的人机语音交互却分布在相隔一段时间的多次会话中,同一说话人反复出现,早先的状态会被更新。另外,分析历史长度的基准在不同长度档里放的是不同的题,长度效应和题目难度、证据类型混在了一起。
⏩二维分类法:4 类声学证据 × 4 种记忆操作
VoxMem 的核心是一张二维分类表(图1)。
声学证据回答“要记住什么”:
- 语音语义(Speech Semantics):说了什么,如事实、数量、计划、偏好和明确的更新。这类信息从文字就能恢复,作为“转写即可回答”的参照。
- 说话人身份(Speaker Identity):谁说的。一个助手同时服务多位地位平等的用户,模型要把之前说过的内容和说话人的声音对应起来,而这种对应在转写里并不存在。
- 副语言线索(Paralinguistic Cues):怎么说的,包括犹豫、惊讶、强调、语速、笑声等。
- 环境声(Environmental Sound):说话时周围能听到什么,如交通、警报、机器、家居声和天气。
后三类是“音频原生”的:答题所需的信息不在转写里。
记忆操作回答“要怎么用”:
- 信息抽取(IE):从某一次过去的会话里取回信息,且声学证据一定参与检索:要么用说话内容定位会话、问它的声学属性(context-to-cue),要么用声学线索定位会话、问其中说了什么(cue-to-fact),比如“找到和现在提问者是同一个人的那次会话”。
- 多会话推理(MSR):把多次会话的证据结合起来,如计数、匹配、比较。答案取决于涉及哪些会话,与顺序无关。
- 时序演变追踪(TET):追踪某个“状态”在会话间如何变化,问最新状态、更早某个时间点的状态,或完整的变化序列,答案依赖会话顺序。对声学证据而言,变化不会被说出口,用户的语气或周围的声音只是在后一次会话里变了,模型必须从音频里察觉。
- 拒答(AR):当历史不能支持唯一答案时,模型应当拒答。
语义 × IE 被排除:当检索线索和答案都是文字时,它退化为纯文本检索。剩下 15 个有效组合,图1 格内数字是每个组合占 799 道题的比例。
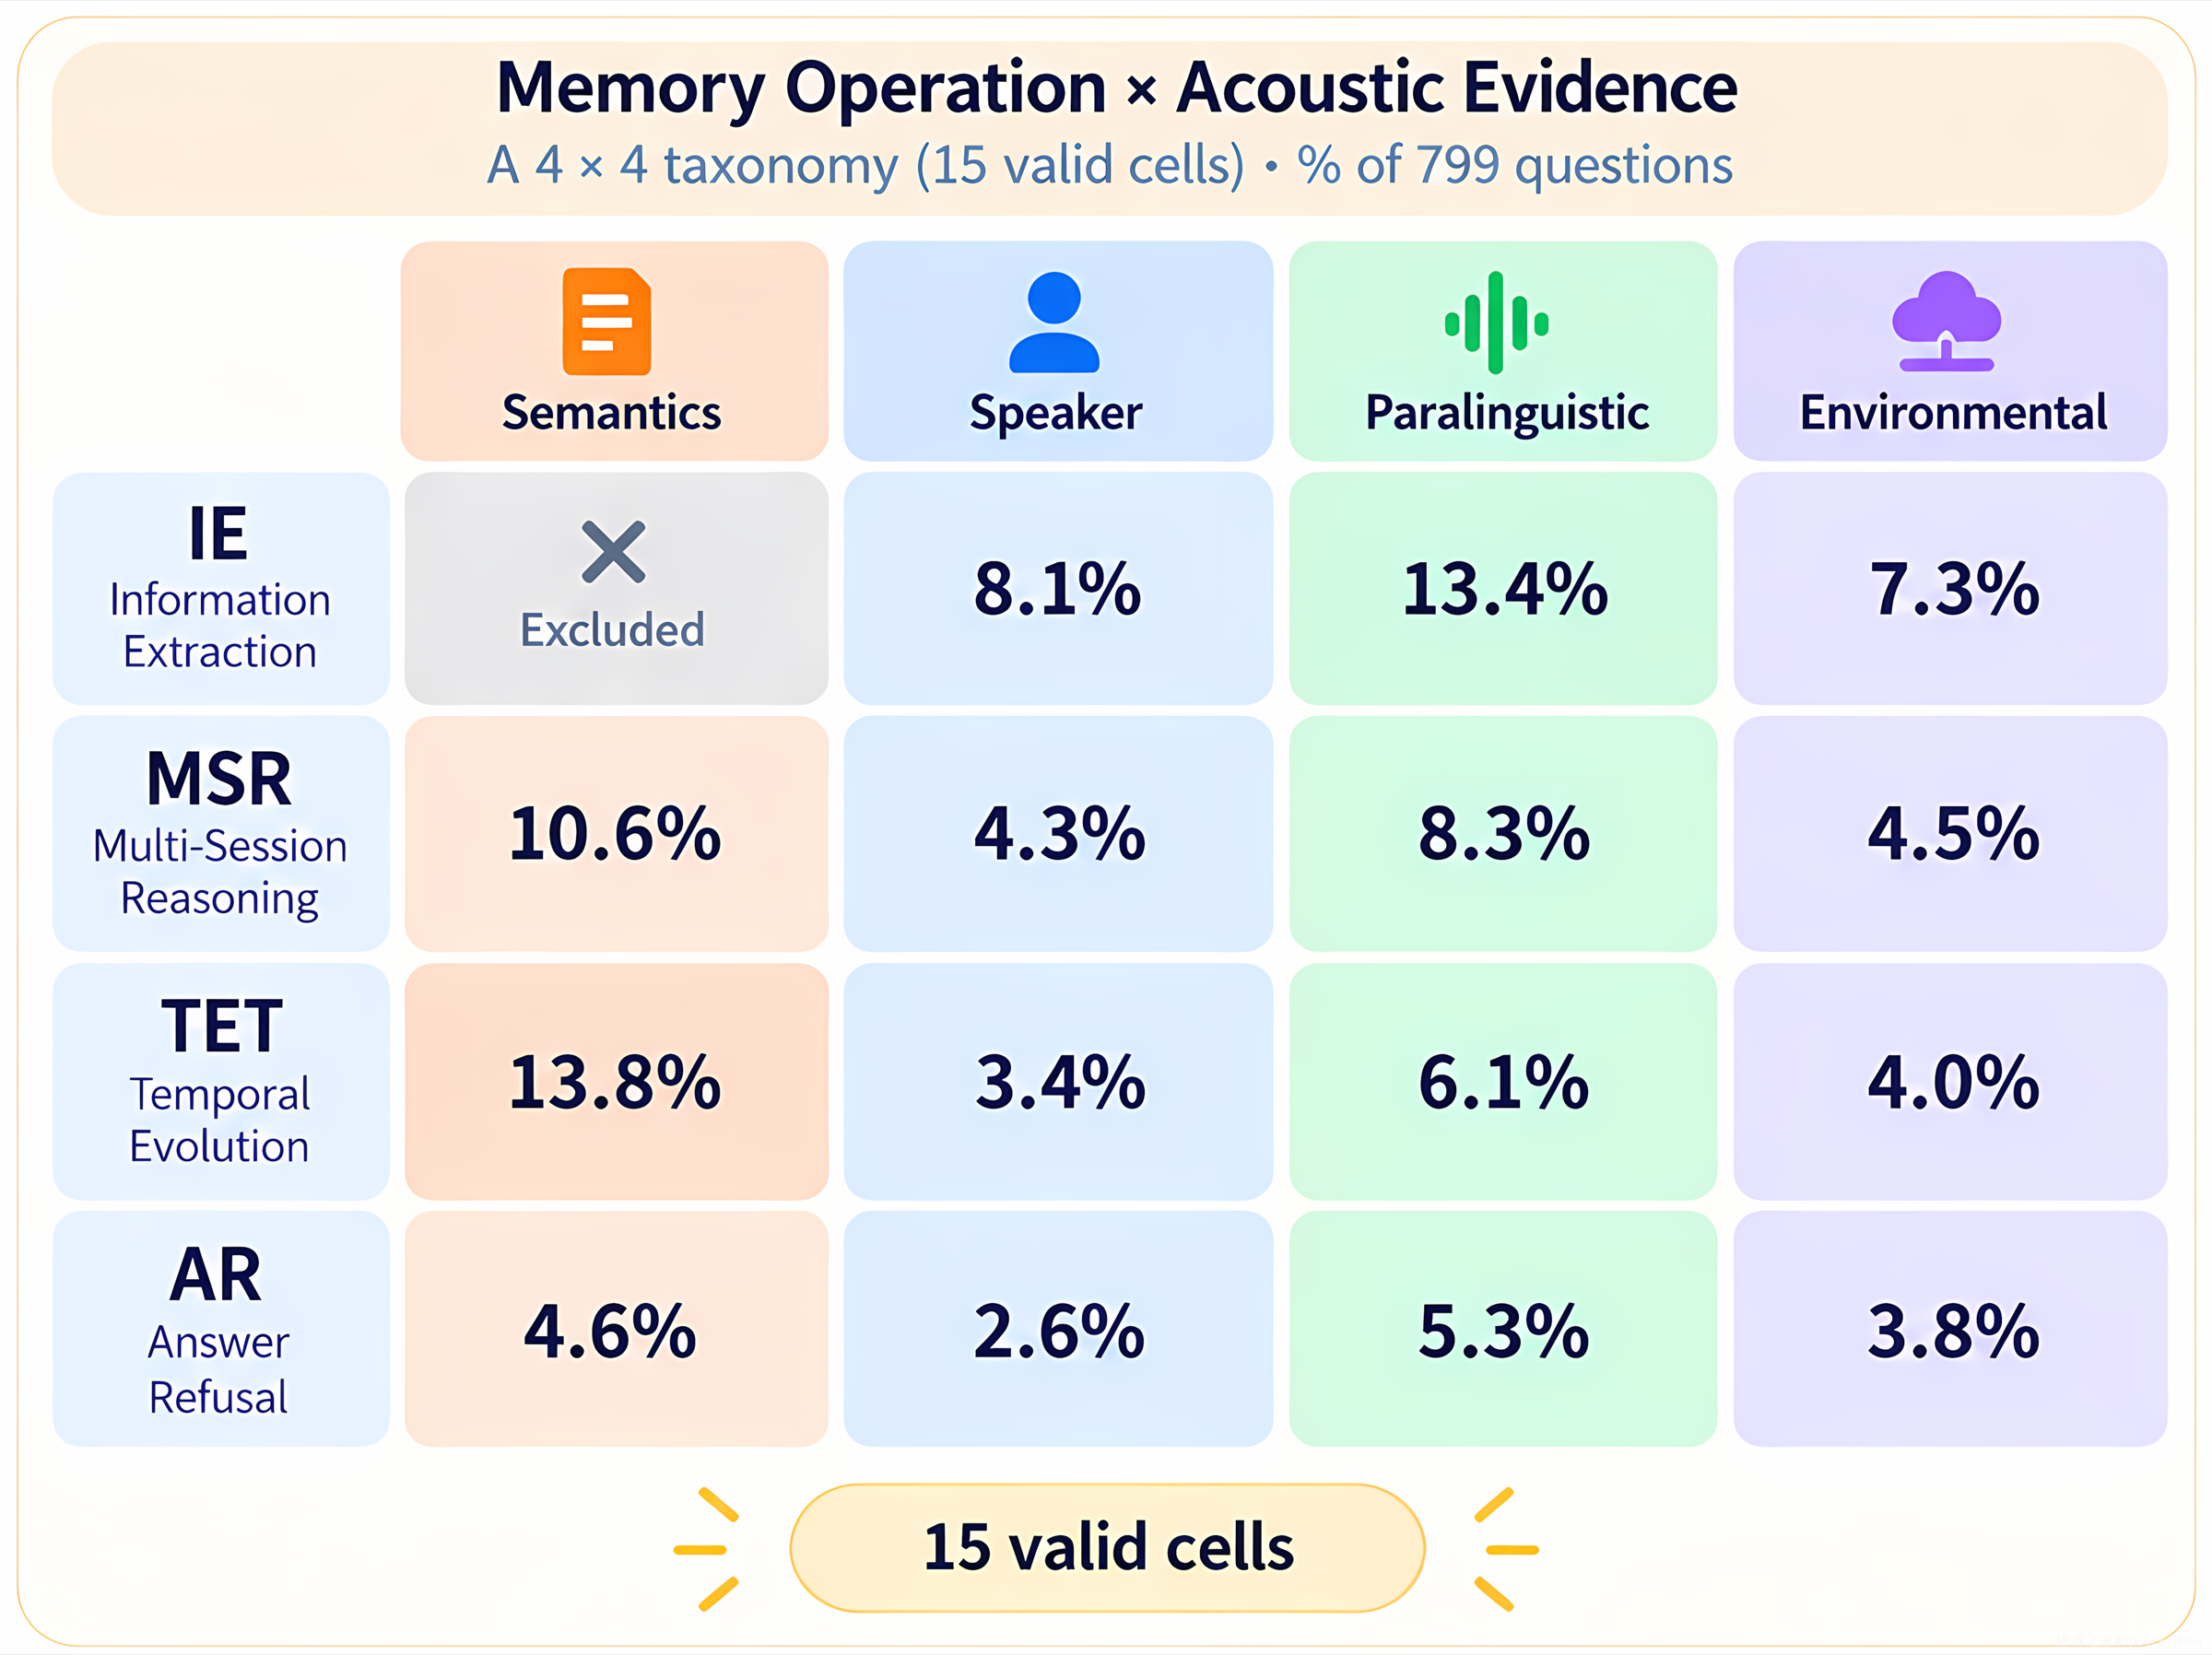
图2 是四个代表性例子。以 (a) 为例:用户问“我之前说灯具更换的事是什么状态?”,答案“暂停”出现在该用户声音的那次会话里;另一次会话中,另一位用户也聊到灯具更换,说的却是“已批准”。模型不能只找唯一谈这个话题的会话,而必须分辨说话人。

⏩数据是怎么构造的
每段多会话历史由三类会话组成:
- 证据会话(evidence):包含答题所需信息;
- 干扰会话(haystack):与证据话题相近,但不给出答案或给出不同取值,让模型无法靠话题匹配作答;
- 填充会话(filler):与问题无关的日常对话,把历史拉到目标长度,文本取自 InstructS2S。
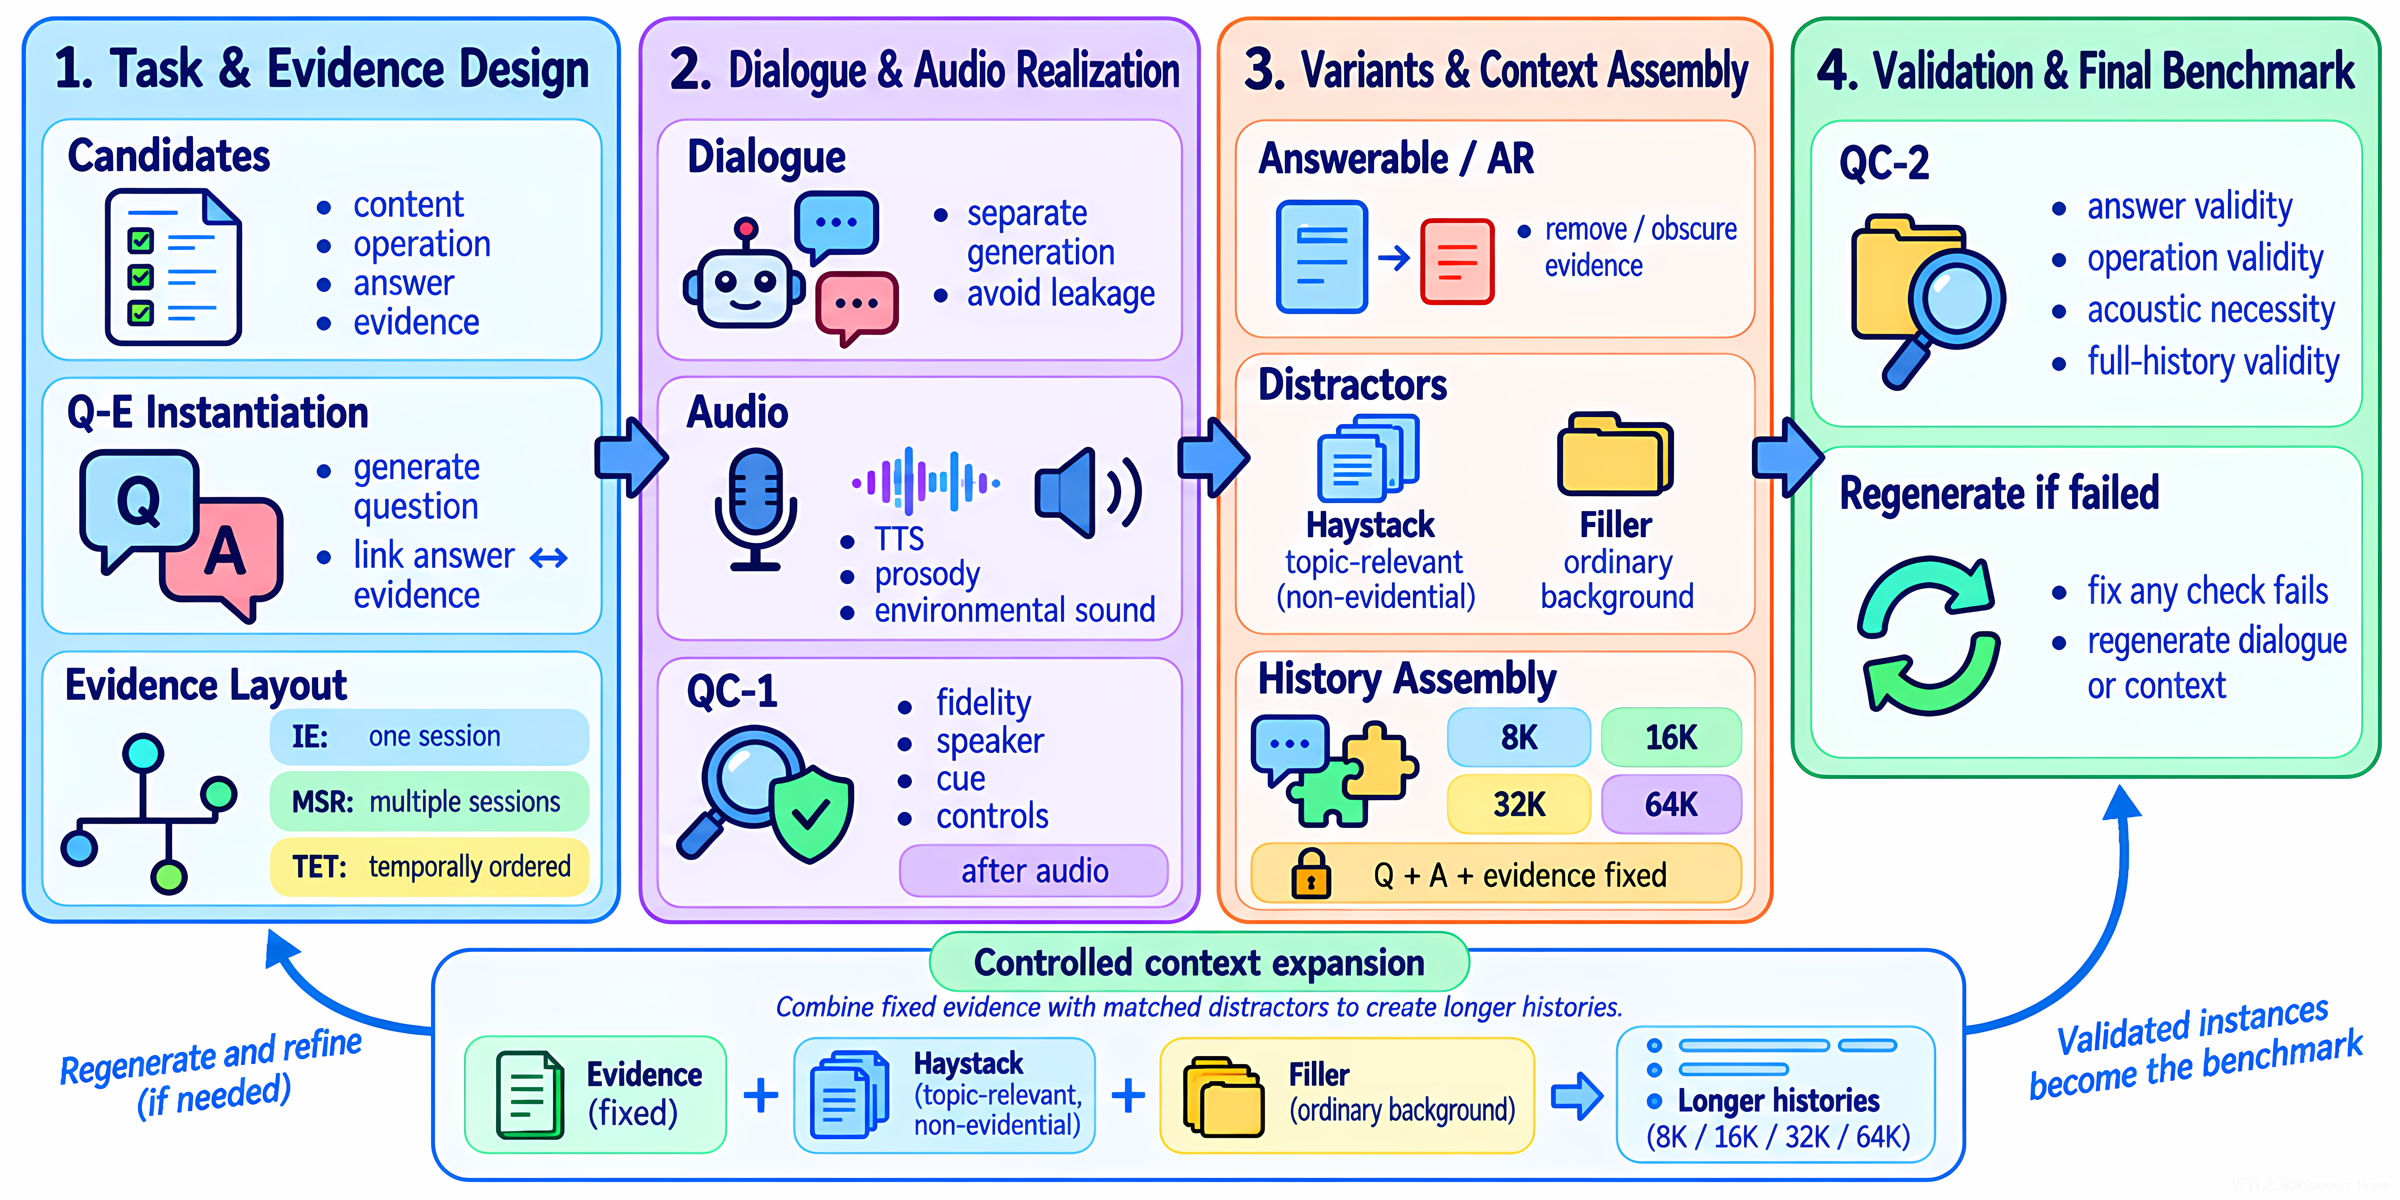
构造分三步(图3)。
1. 规划。每道题先写成结构化计划,包括问题、标准答案和所需证据,之后才写对话、合成音频。证据按操作类型分布:IE 放在一次会话里,MSR 分散在多次会话,TET 按时间顺序排成一串状态。计划同时规定有效性约束:答案必须唯一,音频原生题的答案不能只靠转写恢复。共生成 3 万多个计划,再由 Gemini-3.7-Flash 和 GPT-5.6-Luna 写成自然语言问题。
2. 写对话。每次证据会话写成用户与助手的对话。为防止答案泄漏,用户侧和助手侧分开生成,双方都不提说话人、语气或背景声,答案只能从音频里得到。
3. 语音合成。用户轮次用 Higgs-TTS-3 合成,每位用户在所有会话中固定使用一个 VCTK 音色;副语言线索通过 TTS 的风格控制注入;环境声取自 ESC-50,按 10 dB 信噪比混入。每个带线索的轮次都保留一个配对版本:文字和音色完全相同,只是去掉了线索,供质检使用。所有会话都用同一 TTS 系统和该历史中用户的音色合成,音色和录音质量都不会暴露会话的角色。助手轮次以文本给出:按设计它们不携带答案关键的声学证据,这样不能生成语音的 LALM 也能评测,所有模型拿到的历史完全相同。
干扰会话够不够“难”?作者训练了一个只看文本的分类器区分证据会话和干扰会话,准确率仅 51–56%,接近打乱标签时的 47–49%。也就是说,模型必须借助问题才能找到证据,靠表面模式不行。
受控长度。每道题都放进 8K、16K、32K、64K 四种长度的历史。长度统一用 Whisper 编码器计量(音频每秒 50 个 token,文本用 Whisper 分词器),不依赖任何被测模型的分词方式,约合 2.5 到 20 分钟音频。长历史严格包含短历史的全部会话,只增加干扰和填充会话,因此四个长度下的问题、答案和证据完全相同,准确率变化只能归因于历史变长。证据和干扰会话在历史中均匀分布,位置和时间戳都不会暗示答案所在。
拒答题由已通过质检的可答题派生,共五种规则:完全移除证据、移除多会话证据链的一部分、保留文字但中和声学线索、去掉事实与提问者声音之间的绑定、保留多个同样合理的候选。第三、四种是语音特有的:文字还在,但能锁定答案的声学信息没了。166 个派生变体中有 130 个通过完整验证。
两级质检。QC-1 在会话级检查转写保真度、说话人一致性和目标线索是否可感知。QC-2 在题目族级(一道可答题的四个长度及其拒答变体)检查三件事:答案与操作是否有效(删除或重排证据会话,确认答案只按预期变化),声学是否必要(能靠转写或配对版本答出的音频原生题被剔除),全历史是否有效(有无泄漏、替代答案,拒答题是否仍可作答)。所有基于模型的检查都用 Gemini-3.7-Flash,它不在被评测模型之列。
最终数据:799 道题(669 道可答题 + 130 道拒答题)× 4 种长度 = 3,196 个评测实例,34,743 个语音会话,约 177 小时,覆盖 20 个日常话题。
⏩这些题真的要“听”才能答吗
作者用 Gemini-3.7-Flash 在 8K 下对全部 669 道可答题做了对照:把每个用户轮次替换成它的合成文本,其余不变。
| 证据类型 | 题数 | 完整音频 | 仅转写 | 下降 |
|---|---|---|---|---|
| 说话人身份 | 126 | 69.8 | 10.3 | 59.5 |
| 副语言线索 | 222 | 42.8 | 3.2 | 39.6 |
| 环境声 | 126 | 28.6 | 0.8 | 27.8 |
| 语音语义 | 195 | 75.9 | 71.0 | 4.9 |
| 全部 | 669 | 54.9 | 23.8 | 31.0 |
音频原生题的准确率从 46.2% 降到 4.4%,语音语义题只从 75.9% 降到 71.0%。即使给出完美转写,音频原生题也基本答不出来。
⏩实验结果
评测设置。共 15 个 LALM:10 个开源(涵盖音频专用和全模态架构),5 个闭源(3 个 Gemini、2 个 Qwen),都走原生音频接口。输入中用户轮次是音频、助手轮次是文本;会话边界只靠每次会话开头的时间戳标识,模型需要自己推断会话结构。所有题都是开放式短答案,由 Gemini-3.7-Flash 作为裁判按答案类型判分,用 GPT-5.6-Luna 复判的一致性 κ = 0.95。
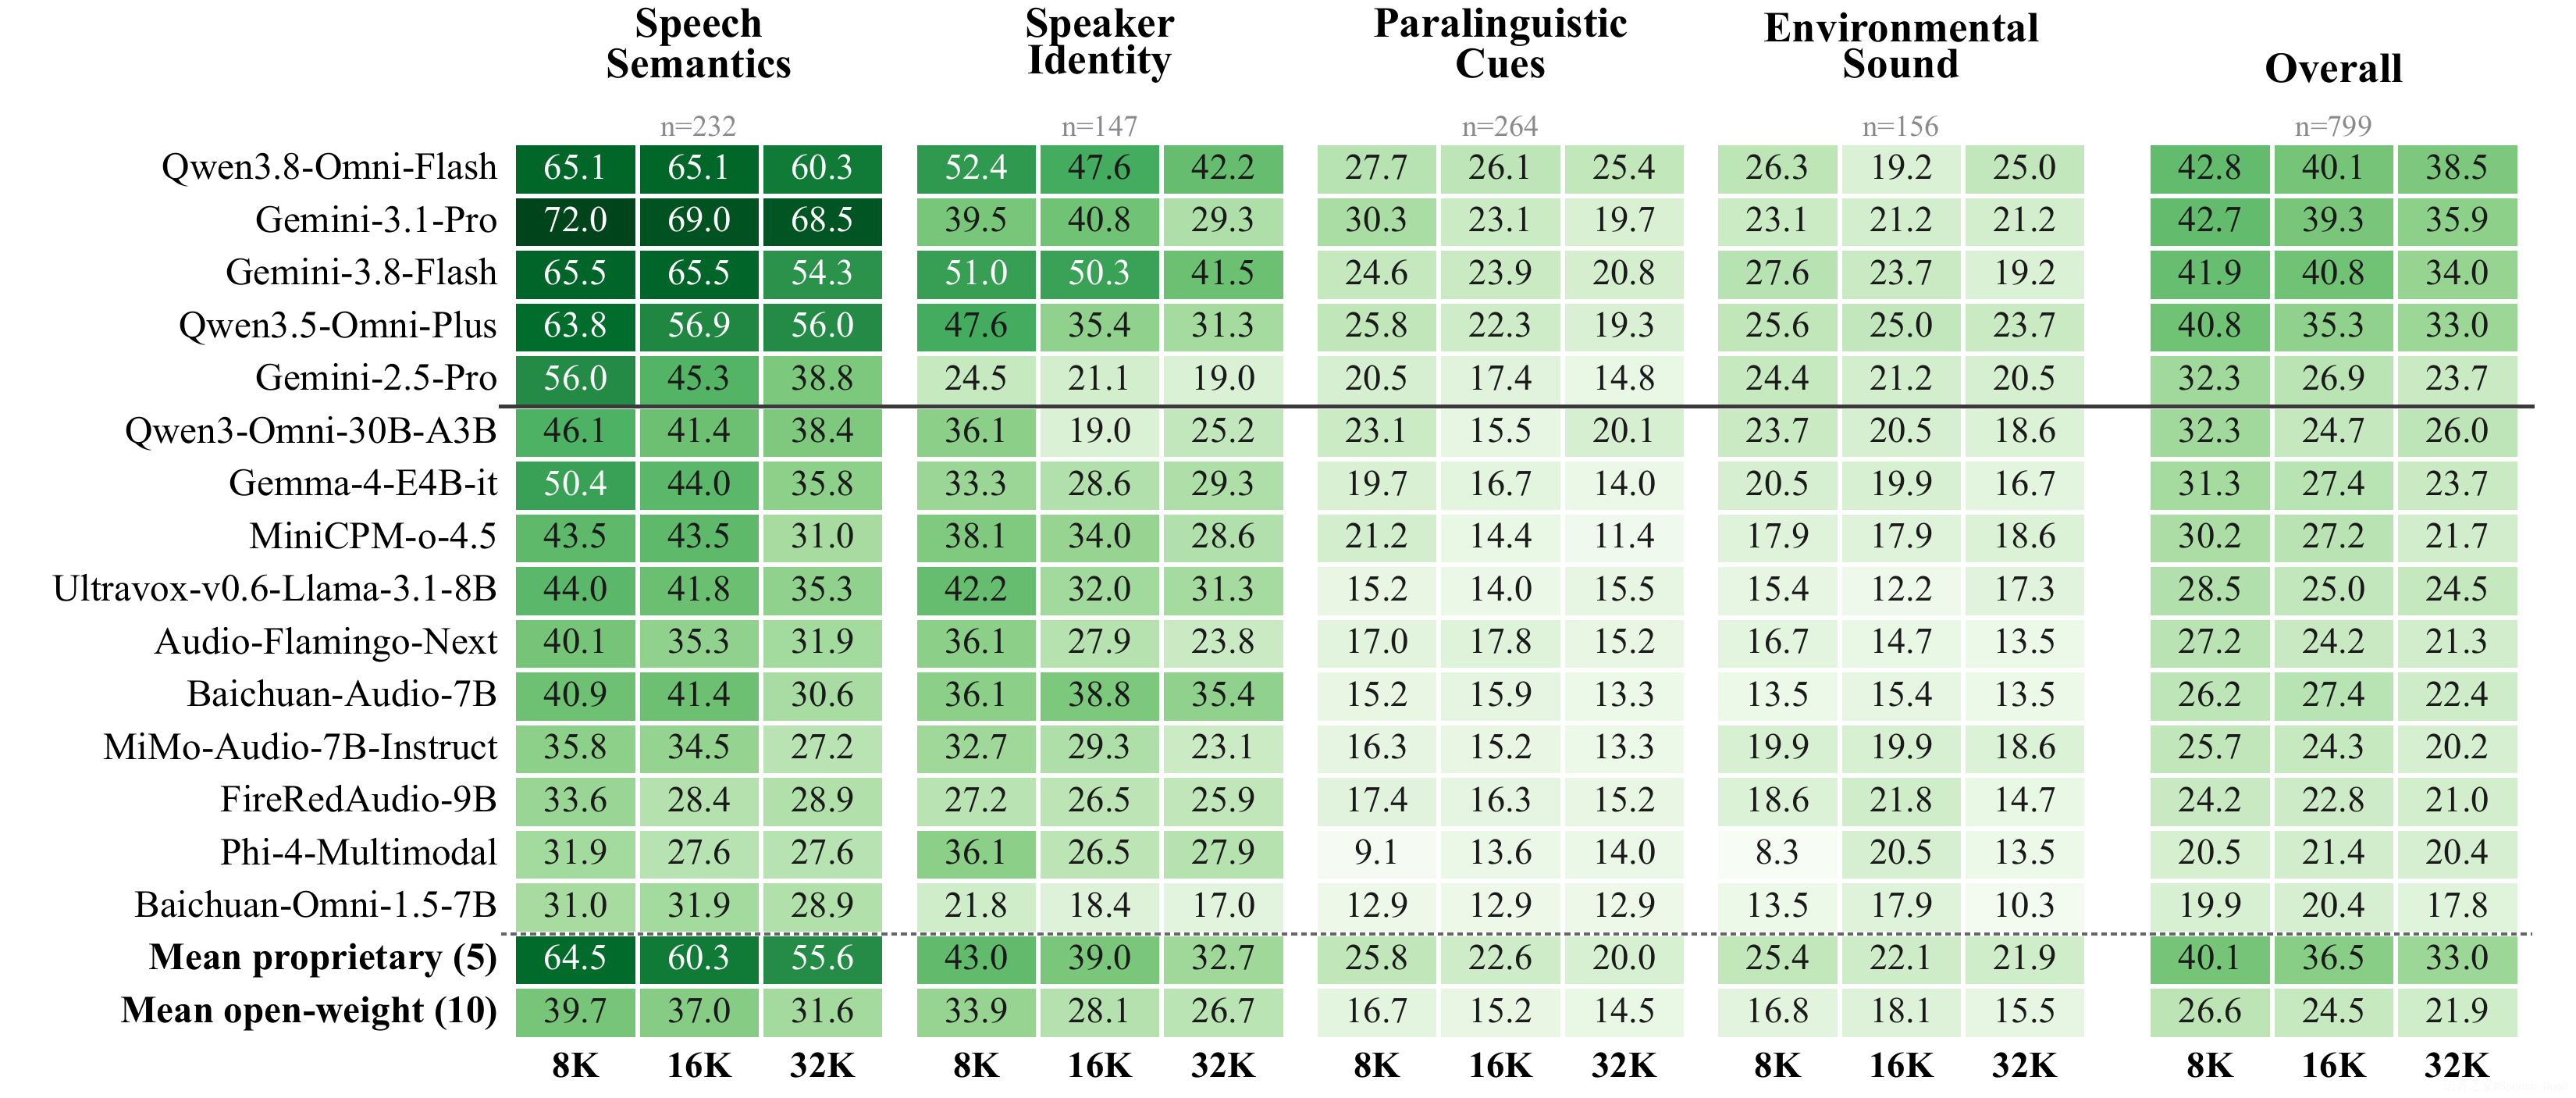
发现 1:离可靠的语音对话记忆还很远。32K 下没有模型整体准确率超过 40%,最好的 Qwen3.8-Omni-Flash 为 38.5%;闭源平均 33.0%,开源平均 21.9%。
发现 2:非词汇声学信息比语义难记得多。32K 下闭源模型平均:语音语义 55.6%、说话人身份 32.7%、副语言 20.0%、环境声 21.9%;开源模型分别为 31.6%、26.7%、14.5%、15.5%。结合上面的转写对照,词汇层面的好成绩掩盖了声学记忆上的大量失败。
发现 3:难度取决于操作和证据类型的组合。图5 是 15 个模型在 32K 下的平均准确率。多会话推理相对稳健:语义 41.8%、说话人 43.1%,副语言和环境声也有 26.7% 和 25.2%,明显高于对应的信息抽取(8.8% 和 13.5%),可见跨会话整合不一定比单会话检索更难。时序追踪则不同:语义状态能追到 44.5%,说话人降到 20.0%,副语言和环境声几乎失效,只有 3.4% 和 1.2%。论文认为,问题不在时间推理本身,而在维护和更新由语气或环境声承载的状态,这可能反映了当前 LALM 的状态建模能力有限。
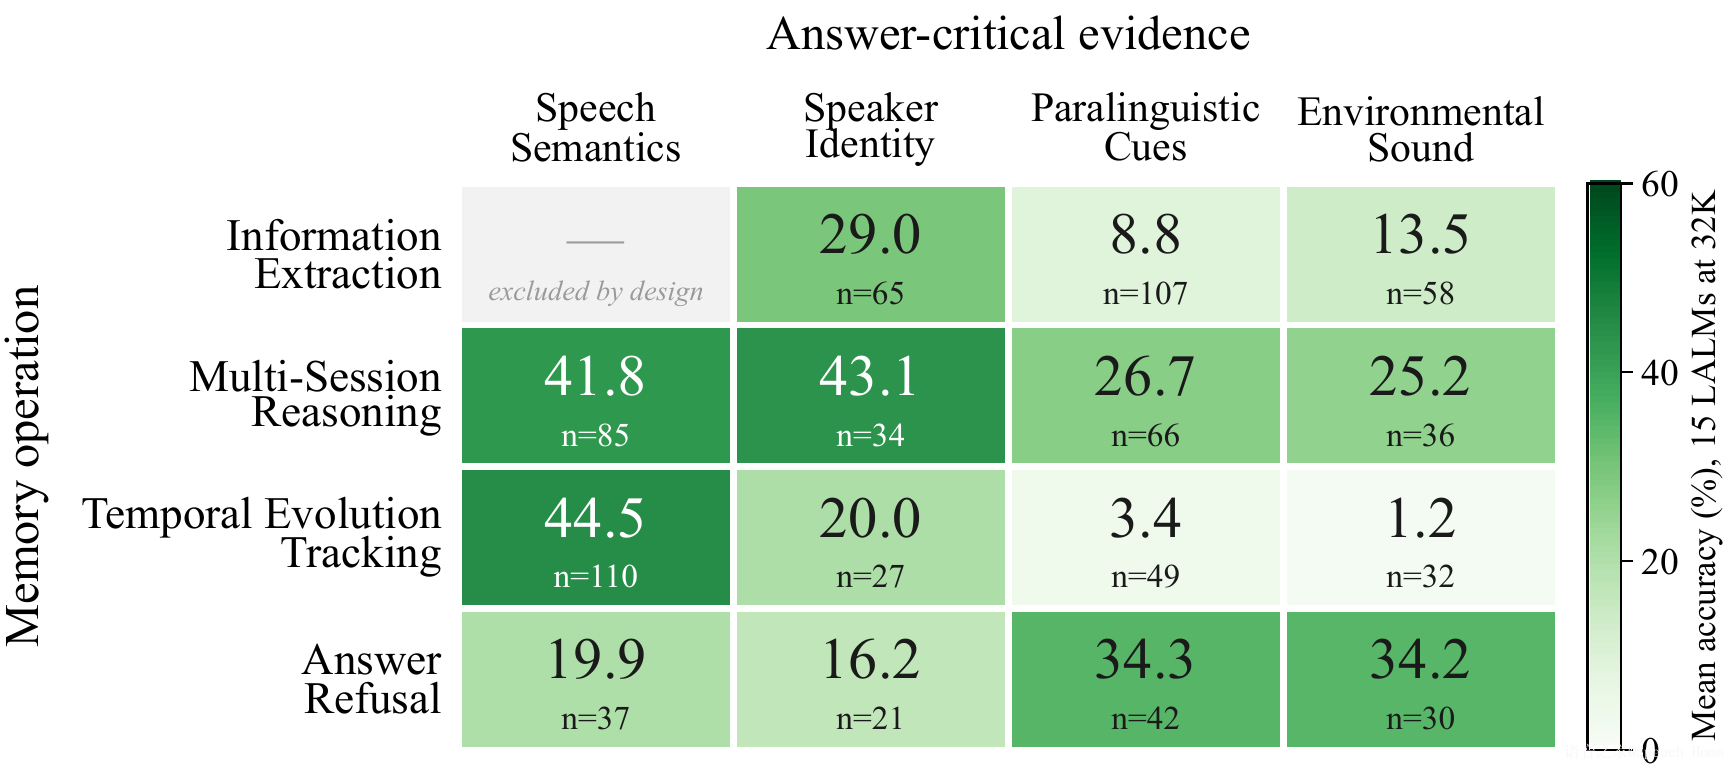
发现 4:拒答呈现相反的规律。副语言和环境声题的拒答准确率(34.3%、34.2%)高于语义和说话人题(19.9%、16.2%),与可答题相反。论文的解读是:模型拒答往往不是因为判断出证据缺失,而是即便证据在场也难以识别和使用声学信息。声学题上较高的拒答准确率,反映的是普遍的声学处理困难,并非真正意识到证据不足。
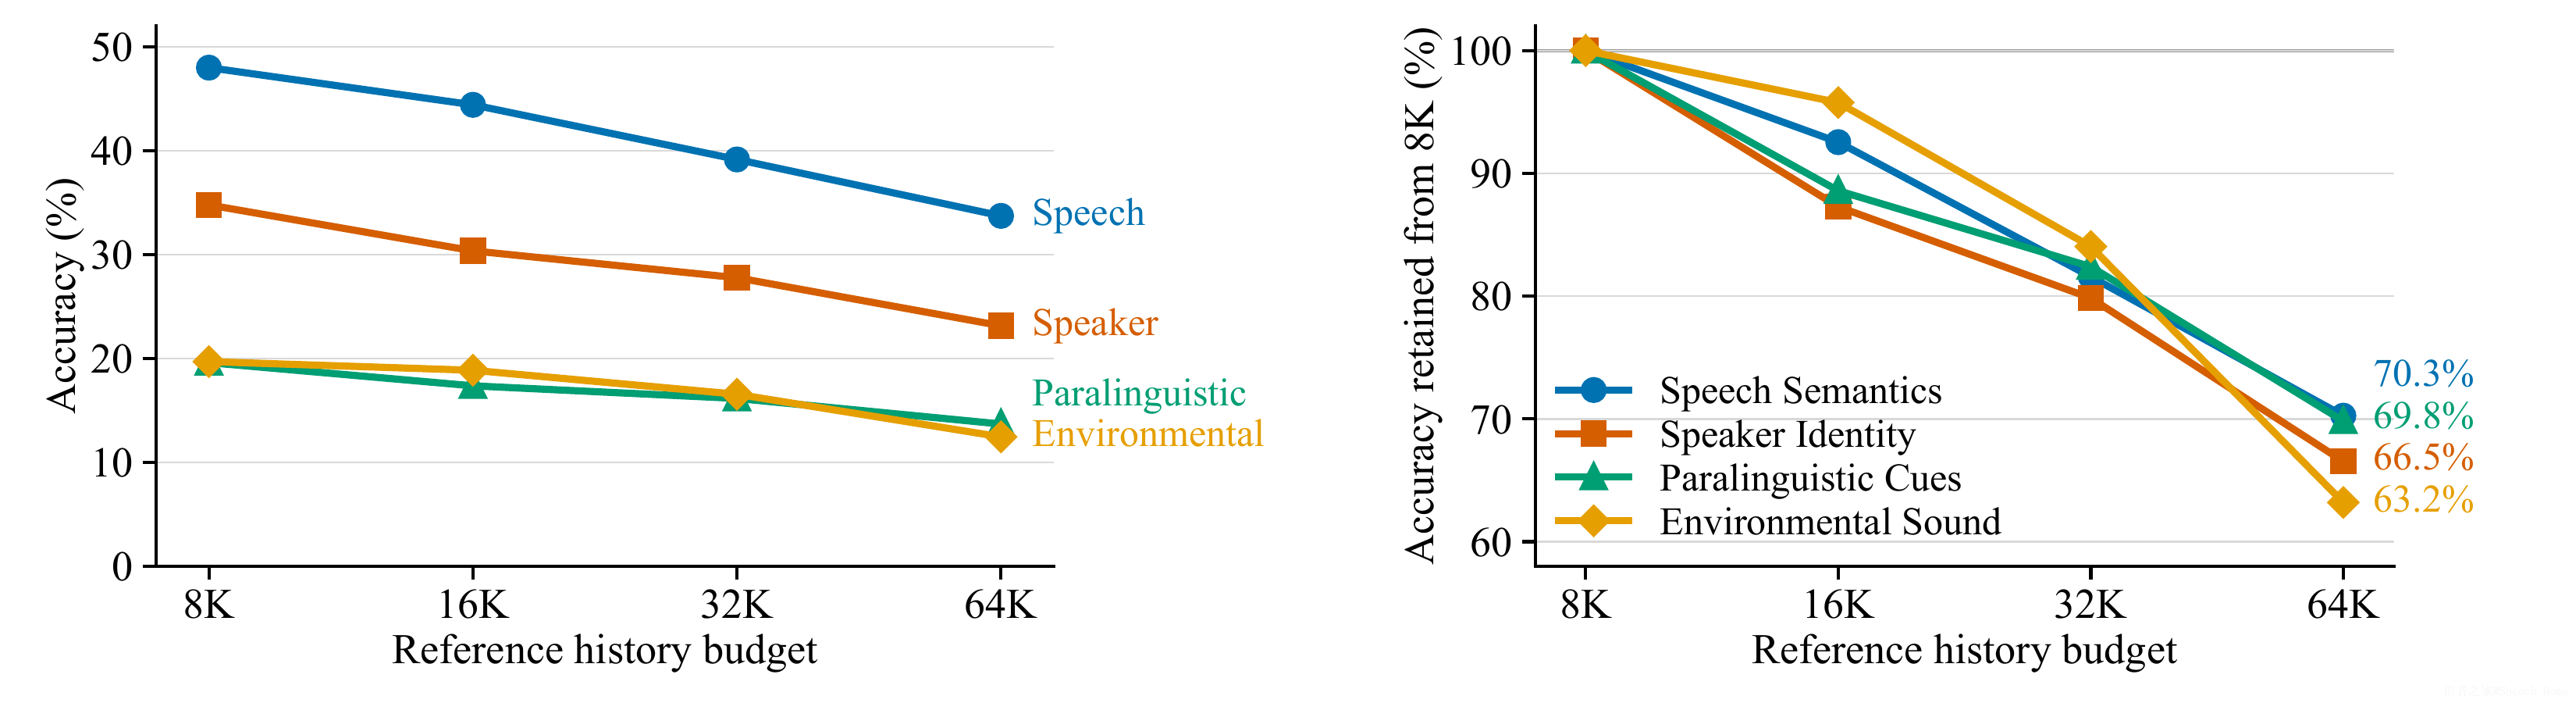
发现 5:同样的证据,历史越长越难取回,且各类型衰减速度不同。8K 到 32K,闭源平均从 40.1% 降到 33.0%,开源从 26.6% 降到 21.9%。在能处理完整 64K 历史的 10 个模型上,四类证据都持续下降(图6)。64K 相对 8K 的保留率:语义 70.3%、副语言 69.8%、说话人 66.5%、环境声 63.2%。副语言的绝对准确率最低,衰减速度却与语义相近;说话人和环境声衰减最快。“基线低”和“对长度敏感”是两种不同的失败模式。
⏩错在哪一步:错误归因
作者用 Gemini-3.7-Flash 对 64K 下的错误回答(不含拒答)做了归因,按记忆查询可能失败的顺序分为:证据识别/定位失败、绑定/关联错误(内容对了但挂错了说话人或会话)、操作执行错误、无依据答案,每个错误归到最早失败的那一步(图7)。
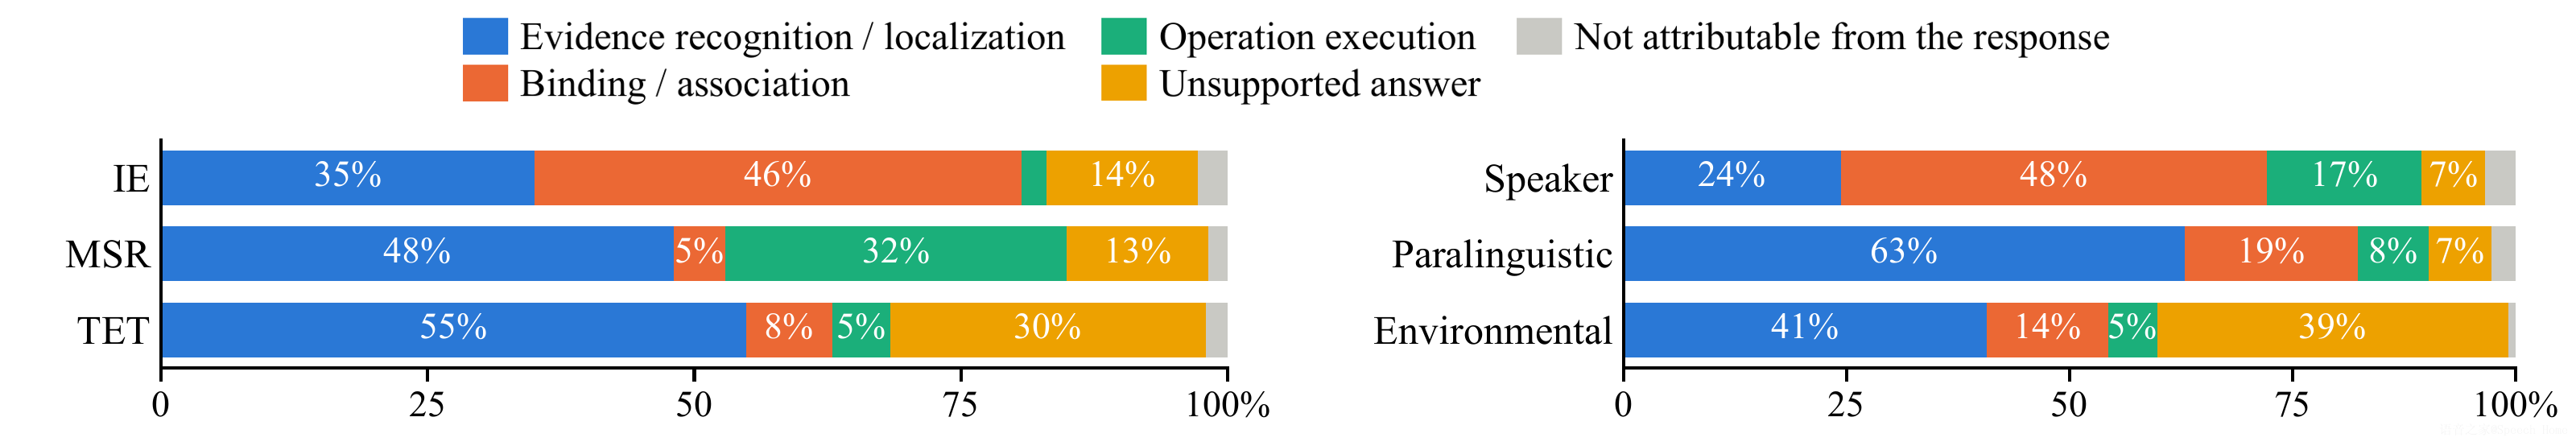
发现 6:错误构成在操作和证据类型上都有质的差别。按操作看,IE 错误以绑定错误为主(46%),模型找到了声学线索,却没能把它和正确的上下文联系起来;MSR 错误分布在证据定位(48%)和操作执行(32%);TET 错误大多是定位失败(55%),操作执行错误只有 5%,追踪在推理开始之前就失败了。按证据类型看,说话人错误多为绑定错误(48%),“声音—内容”的跨会话关联没能维持;副语言错误以定位失败为主(63%),答案关键的语气线索往往根本没被取回;环境声错误分布在定位失败(41%)和无依据答案(39%)。
附录里的真实案例很直观。一道说话人计数题的正确答案是 2,Audio-Flamingo-Next 回答“有 10 次对话符合”:10 次会话都提到了这个话题,但只有 2 次满足说话人条件,模型数的是话题而不是条件。另一道环境声题里,证据会话的背景声是引擎声和母鸡叫,Gemini-3.8-Flash 却编出了“厨房清洁声”的分组和计数。
⏩总结
VoxMem 用“声学证据 × 记忆操作”的二维分类法,在多会话、受控长度的设置下系统评测了 LALM 的语音对话记忆。结论很清楚:模型记住“说了什么”的能力远好于记住“谁说的、怎么说的、听到了什么”;只有状态变化被说出口时,它们才能较可靠地追踪;历史越长,已有证据越难取回;不同类型的失败性质也不同,说话人题多是把信息记到了别人头上,副语言题多是压根没留住那段声学线索。
论文指出,仅仅支持更长的音频上下文,不足以支撑持久的语音交互。未来的系统需要保留非词汇的声学信息,并在时间上维护它与说话人、事件和会话之间的关联。VoxMem 的代码和数据均已开源。
