
 语音小管家
同一句话播放两遍,内容一模一样,只是第二遍音调更高,让它挑出音调更高的那一遍。能把语音转写准确的模型,未必答得好这样的题。类似的问题还有:一段对话里有几位说话人?一段音乐的节奏有没有加快?这些任务都在提醒我们:知道“说了什么”,不等于听懂声音里的全部信息。
EvoAudio 的思路,是让训练跟着模型的能力变化来调整:先找短板,再生成合适的练习题;训练后验证是否进步,然后决定下一轮怎么练。
这就是 EvoAudio 引入音频理解任务的“递归自我改进”(Recursive Self-Improvement,RSI)。据研究团队所知,这是音频领域首个将数据生成、模型训练与评估整合在同一闭环中,推动训练数据与模型共同迭代的自进化系统。
论文题目:EvoAudio: Recursive Self-Improvement for Audio Understanding
论文链接:https://arxiv.org/pdf/2609.27389
项目主页:https://jensenyx.github.io/EvoAudio.github.io/
过去,要补齐模型的听觉短板,研究者通常需要先定位问题,再收集、标注或清洗数据,重新训练。这个过程不仅耗时耗力,还面临两个问题。
一是数据不一定足够可靠。 人工标注成本高,借助更强的多模态模型标注,也不意味着答案一定正确:强模型同样有自己的能力边界。
二是同一套训练题,不一定适合所有模型。 有的模型擅长音乐理解,有的擅长多人对话。统一准备的数据,未必刚好对应每个模型的短板。训练过程中,还可能出现一种能力提高、另一种能力下降的情况。
因此,问题不只是“有没有足够多的数据”,还包括:这些练习适不适合当前模型?等模型进步了,下一轮又该练什么?
让高中生刷小学数学题、或让小学生硬啃高中物理,都很难获得理想的训练效果。题目太简单,提升空间有限;题目太难,又难以得到有效的学习反馈。音频大模型训练也是同理,需要因材施教,循序渐进。
EvoAudio 每轮都会重新给模型做一次“体检”:逐一检查模型在 47 项听觉技能上的表现(基本涵盖了音频理解的各个维度),看看哪里薄弱、哪里正在进步、哪些技能已经轻松掌握。
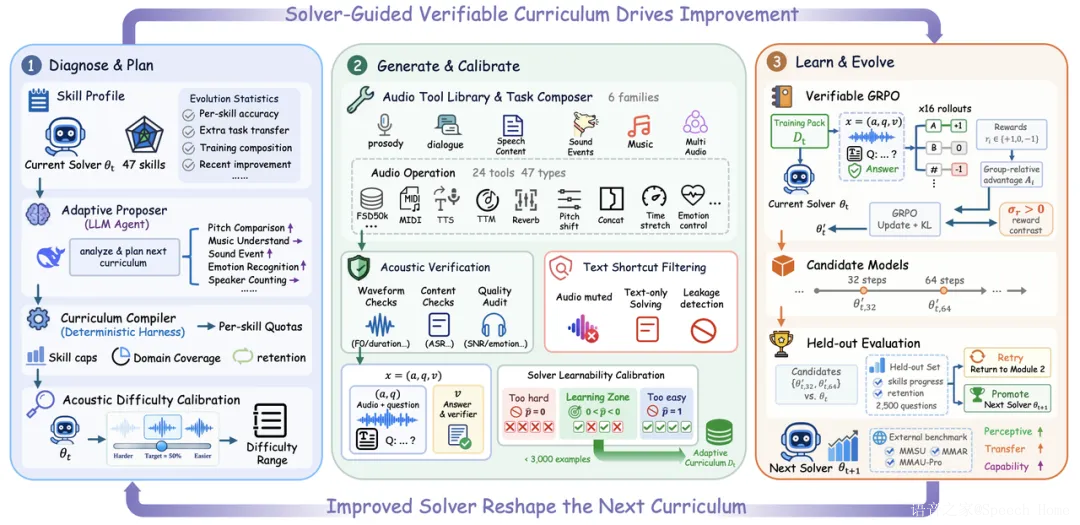
EvoAudio架构图
接着,负责规划的大语言模型根据“体检报告”调整训练重点,给出出题计划;音频工具库再把计划变成具体的声音和问题。系统会保留少量已掌握的任务用于巩固,把更多训练资源留给薄弱能力。题目难度则尽量控制在一个合适的区间:模型能答对一部分,但还不能稳定拿满分。 随后,系统使用 GRPO 强化学习,依据作答是否正确的反馈来更新模型。
不过,一轮训练不代表模型一定变强。训完的模型(我们称为候选模型)需要在固定的 2,500 道独立验证题上取得比训练前更好的表现,才能替代原模型,进入下一轮。没有通过验证,就保留原模型,重新组织后续练习。
这也是“递归”的关键:晋级后的模型重新接受能力诊断,它的新能力和新短板,决定下一轮重点练什么、如何构造音频、把难度调到哪里。
在既定的工具库、任务范围和验证规则下,这一迭代流程可以自动运行,不需要每一轮都由研究者重新安排训练任务。
自进化要持续下去,有一个重要前提:题目和答案必须靠得住。听力题比文字题多了一层麻烦:题目大纲写对了,不代表声音真的构建对了。如果题目生成时音高变化太微弱、或混音盖住了要辨认的声音,拿着预设答案去训练,就可能把模型带偏。
EvoAudio 如何减少这类问题?回到开头那道题。系统先生成一句话,再复制一份,对其中一段做音高变换,然后把两段声音拼接起来。这样,“哪一段音高更高”的答案,就可以根据音频的变换记录确定,而不必再请人工或另一个模型逐条标注答案。
在最终确定为训练数据前,EvoAudio还会测量最终波形,检查实际的音高变化是否符合预期,确保音频、题目、答案三者一致且正确。此外它还会做一道过滤:只保留问题、去掉音频,筛掉那些不听声音也能作答的题,减少模型绕开音频的机会。筛选校验后留下来的训练数据,才更有可能促使模型认真理解声音中的信息。
EvoAudio的出题工具库包含24种工具(比如TTS,TTA,音乐生成模型,MIDI等),覆盖6大类共47种可核验题型,涉及语音韵律、说话人、声音事件、音乐和长音频场景等。
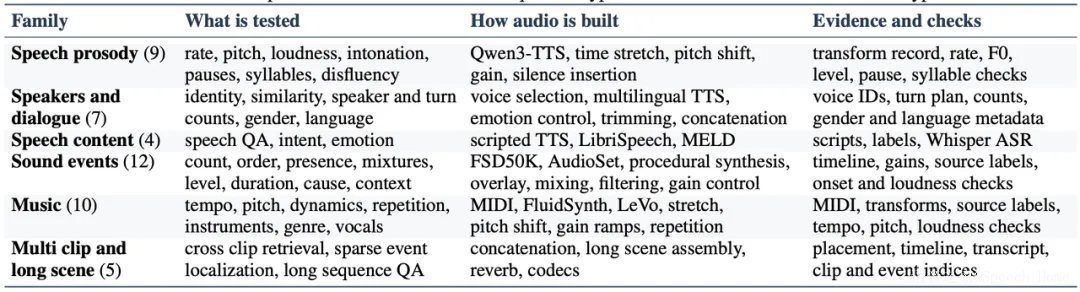
EvoAudio包含24种音频工具,覆盖6大类共47种可核验题型,涉及语音韵律、说话人、声音事件、音乐和长音频场景等。
这里需要区分两个角色:大语言模型可以参与规划“出什么题”,但这些训练样本的答案来自音频构建过程或已有标签,无需再由人工或外部大模型逐条标注。
因此,EvoAudio 并不是简单地“多生成一些数据”,而是把三个环节连在一起:题目和答案可靠,难度适合当前模型,训练后还有独立验证。
研究在 Qwen2.5-Omni、Kimi-Audio、Audio Flamingo 3、MiMo-Audio 和 MiniCPM-o 4.5 五个音频模型上进行了 13 轮迭代实验。需要注意,一轮迭代是一次改进尝试,并不意味着每一轮都会产生一个通过验证的新模型。
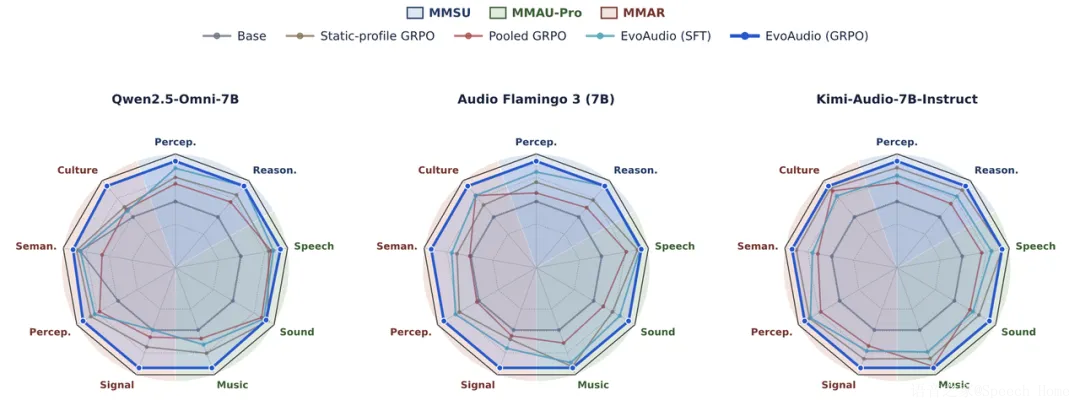
EvoAudio在不同模型、不同 benchmark 上的表现
- 在 MMSU、MMAU-Pro 和 MMAR 三项评测的平均准确率上,五个模型全部有提升,增幅在 1.4 到 6.3 个百分点之间。
- 更直观的一组结果来自 Qwen2.5-Omni:它在 MMSU 声学感知(acoustic perception)分项上的准确率,从 44.5% 提到 61.5%,提高17 个百分点,一次实打实的“听力补课”。
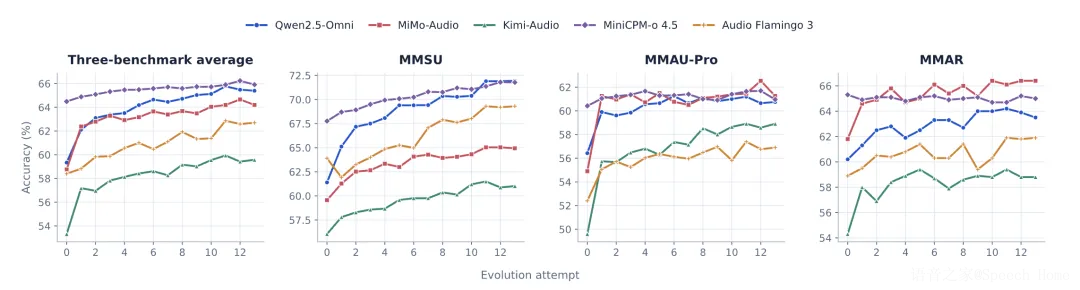
各模型表现随进化轮次增加的变化趋势
训练数据跟着模型变化,究竟有多大作用?论文给出了一个直接对照。
在 Qwen2.5-Omni 上,同样进行 13 轮迭代,训练更新预算也相同。如果训练重点、题型配额和难度始终沿用初始设置,三项评测的平均准确率为 62.8%;采用 EvoAudio 的动态训练安排,则达到 65.4%,高出 2.6 个百分点。
这组结果支持了一个判断:除了训练本身,根据模型的新能力持续调整练习内容,也能带来额外收益。
但这套方法也有其边界,后期收益会逐渐放缓:音频工具库能生成的题型、可稳定验证的任务范围,以及待训练模型本身的上限(比如受编码器encoder的限制),都会限制它的性能上限。
EvoAudio 的价值,不只是多做了几轮训练,而是初步跑通了一个持续改进的闭环:模型暴露短板,系统据此生成练习;练习帮助模型进步,更新后的模型再决定下一轮需要什么数据。
这就是“数据飞轮”:数据推动模型进步,模型的变化反过来指导数据生成。 只要系统能持续提供有针对性、可验证的训练数据,就有机会降低对人工标注和更强教师模型的依赖。
这也留下了更大的想象空间:类似的方法能否用于 TTS,让合成语音的韵律和情感更细腻?能否用于 ASR,让模型适应更复杂的口音与噪声?
工具更多,并不必然意味着能力更强;关键仍在于,它们能否针对模型的短板生成有价值的练习,并提供可信的反馈。“自进化”的关键,不是让模型不停地练,而是让它持续练对题,并用可靠的评测确认进步。
