
 语音小管家
最近语音合成大模型圈子发生了太多令人惊喜的事情,我按照时间线来梳理下。
1、ChatTTS
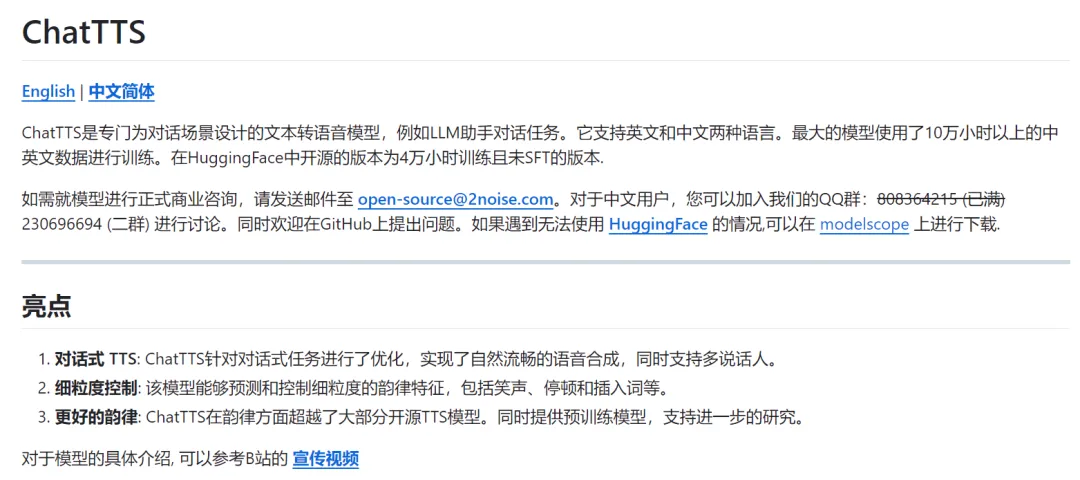
视频版本如:https://www.bilibili.com/video/BV1zn4y1o7iV/
题外话:chattts团队太厉害了,2个年轻人搞定了这块,并拿到了融资。
2、字节的SEED TTS
Seed-TTS:由字节跳动开发的几乎完美接近人类的文本到语音(TTS)模型.该模型能够生成高质量、几乎无法与人类声音无法区分的语音。无需训练的情况下,只需要简短的语音片段即可克隆生成高度自然且富有表现力的语音。完全能否胜任读小说、配音等任务.Seed-TTS 还提供了对各种语音属性的高级控制能力,包括但不限于情感、语调、说话风格等。还可以通过编辑文本来编辑生成的语音。同时支持不同语言间的语音转换,帮助跨语言沟通和交流。Seed-TTS 在多个实验中表现优异,其生成的语音在自然度和说话者相似度上接近人类语音。(以上来自微博互联网那点事的描述)
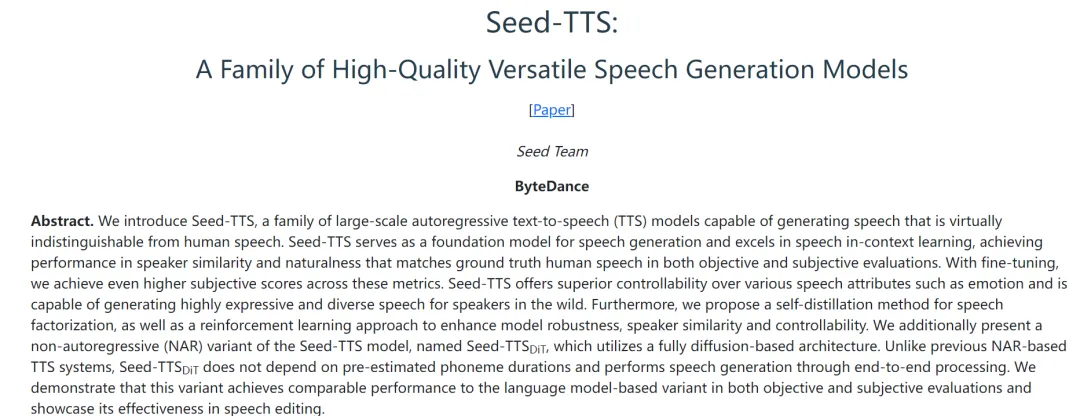
可以去这里听下样音,也可以走豆包APP体验。
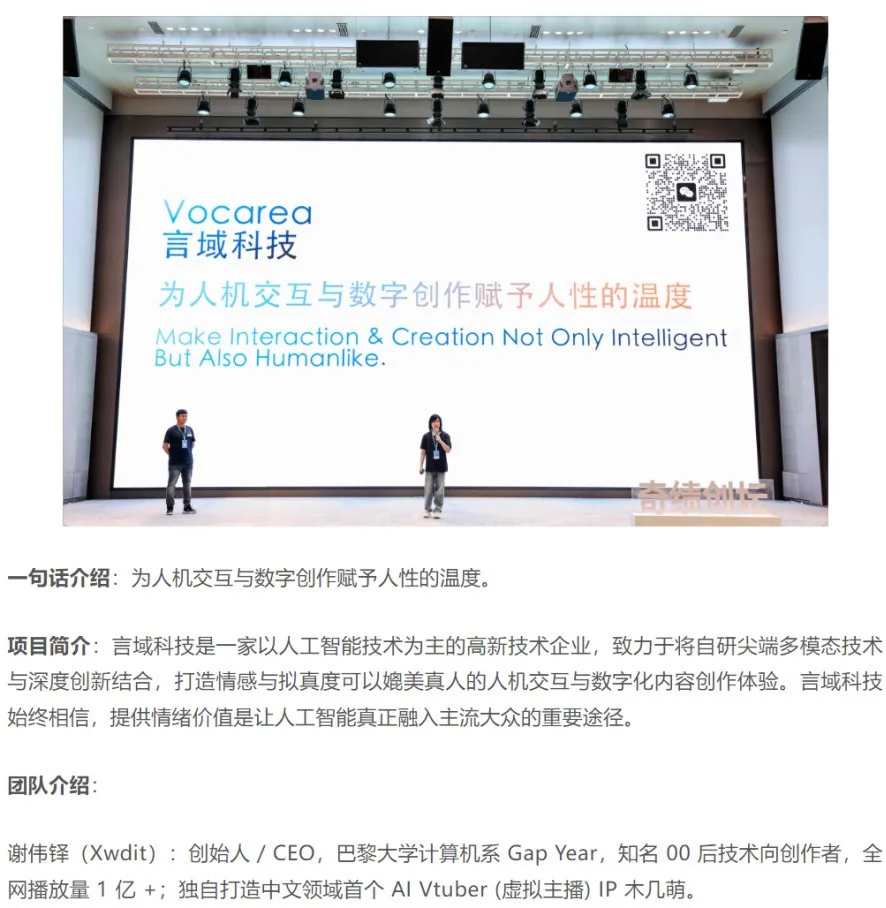
3、Reecho睿声人声大模型
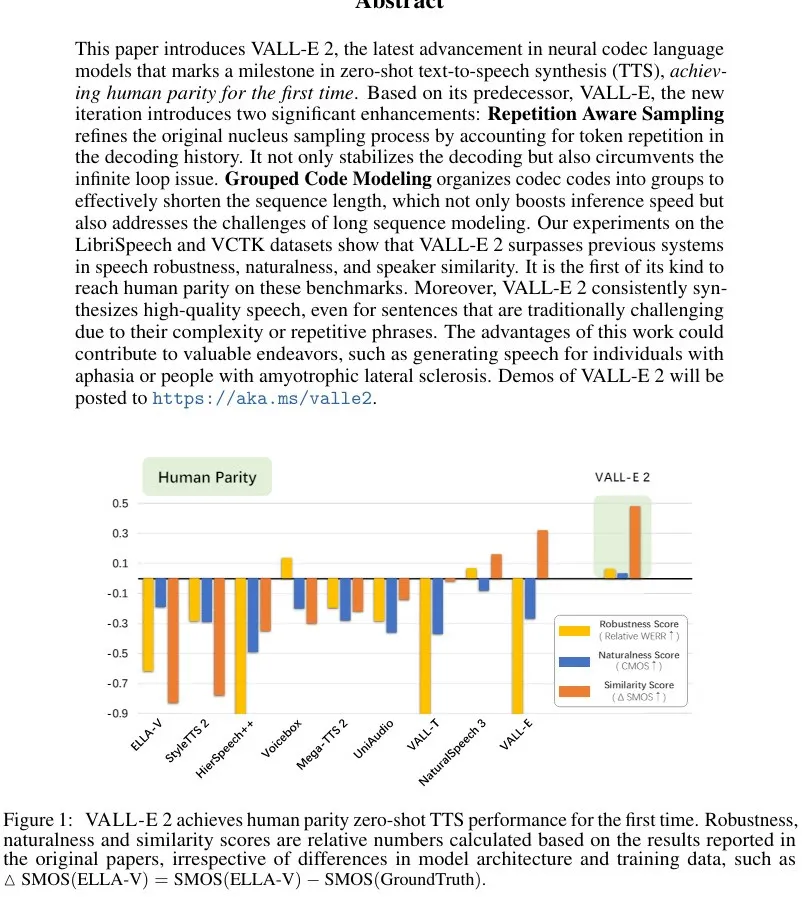
4、VALL-E 2
大家都知道合成大模型的原点是VALL-E,VALL-E首次把识别的数据放到合成领域,已经到达上万小时的数据来训练。大佬自己说本次2代模型:改进了解码算法,增强了稳定性,在model方面确实没有太大更新,但模型的性能还是提升挺大的。样音还在法务review阶段,待开放。
论文地址:https://arxiv.org/pdf/2406.05370
5、WenetSpeech4TTS
合成大模型出来了之后,大家都在找数据。这不,谢老师和Wenet团队把数据清洗好放出来了。论文已经被2024 interspeech录用,待开放中。
地址:https://wenetspeech4tts.github.io/wenetspeech4tts/
最后,期待每个做语音合成的团队都能做出来自己的语音合成大模型。随着GPT-4o的demo版本问世,大家都在尝试此类的预研。如果有想聊聊,可以后台私信。祝愿语音的各位同仁们继续攻克新的课题。
