Rumik-OSS 1:30 亿参数多语言 TTS 开源模型,支持 22 种语言混说

印度语音 AI 团队 Rumik 开源 Rumik-OSS 1,一款约 3B 参数的多语言 TTS 模型,支持 22 种语言、原生文字输入及语言混说,并可通过文字描述控制音色的情绪、口音和语速,同时在句子中插入笑声、轻笑和叹气等非语言声音。…
23 0 0

印度语音 AI 团队 Rumik 开源 Rumik-OSS 1,一款约 3B 参数的多语言 TTS 模型,支持 22 种语言、原生文字输入及语言混说,并可通过文字描述控制音色的情绪、口音和语速,同时在句子中插入笑声、轻笑和叹气等非语言声音。…
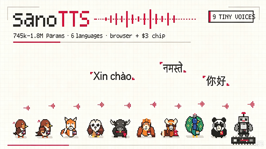
地址:https://tts.ampixa.com/sanoTTS/ 尼泊尔语音 AI 实验室 Ampixa Labs 开源超小型神经 TTS 模型家族 sanoTTS,模型规模覆盖 29.4 万至 227 万参数,包含 11 个声音、6…
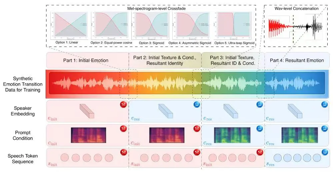
心理学研究证明,人的情绪是一个随时间连续演化的动态过程:会上扬、会回落、可以在几秒内完成从一种情绪到另一种情绪的过渡。然而当下的情感语音合成(TTS)系统,大多只能给一整句话贴上一个离散标签或一个静态情绪向量,与情绪的时间本质错位。本文提出…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. SpeechGym: An Aud…
今日论文合集:CS.SD语音与音频 | 共 8 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Domain-Adaptive A…
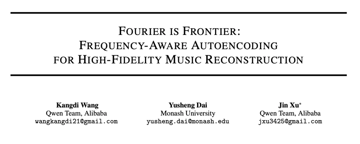
本文旨在介绍论文《Fourier is Frontier: Frequency-Aware Autoencoding for High-Fidelity Music Reconstruction》的相关内容,详情如下: GitHub:htt…
今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. EXAM$^2$: $\under…
今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Multi-Task Learn…
今日论文合集:CS.SD语音与音频 | 共 3 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Towards Quantifyi…
今日论文合集:CS.SD语音与音频 | 共 5 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Geometric Iterati…
