
 语音小管家
本文旨在介绍论文《Fourier is Frontier: Frequency-Aware Autoencoding for High-Fidelity Music Reconstruction》的相关内容,详情如下: GitHub:https://github.com/Eps-Acoustic-Revolution-Lab/EAR_VAE2
Paper:https://arxiv.org/abs/2608.19843
Demo Page:https://eps-acoustic-revolution-lab.github.io/EAR_VAE2/
音频生成的LDM范式依旧稳固, 音乐目前也不例外。但目前的Waveform AE/VAE普遍存在一些结构性问题:
高频泛音衰减与金属质感毛刺:高频的resonance普遍刺耳,上游模型训练不充分或极端情况下很明显,连带电流声,是AI味的主要来源;
相位不连贯与瞬态松散:打击乐的瞬态响应受到破坏,听感浑浊不清,能量本身不够集中,有明显的phase cancellation,集中在vocal的中低频段(eg:500-1k Hz);
立体声声像收窄与声场塌缩:左右声道的空间分离感退化,原本开阔立体的混音声场变窄变扁,且vocal和乐器元素之间存在明显的景别差异,没有远近关系上的平滑过渡。
这些问题的根源在于:时域波形表征将时间、频率、相位以及双声道空间线索紧密揉杂在了一维采样序列中。模型缺乏明确的“物理频率坐标”,因而无法针对不同频段各自独特的声学规律进行针对性的参数化建模与残差修正。
针对这些问题,ε ar-VAE2 提出直接在复数的频域上进行建模。通过建立物理频率坐标轴、设计按频点自适应的周期激活函数,并引入基于心理声学“双耳理论”的分频 refiner,ε ar-VAE2 为高保真音乐重建与生成提供了一套高效、保真的底层底座。
⏩一、 为什么选复数谱?
在音频表征的学习中,存在多种可能的输入表征:直接输入一维时域波形、切片重排的时域局部块(Waveform Patch)、仅保留能量强度的幅度谱(Magnitude Spectrogram),以及同时保留实部与虚部的复数频谱(Complex STFT)。
为了厘清不同表征在同等资源约束下的本质差异,研究团队在控制模型参数规模、latent 特征维度、训练数据分布与优化策略完全一致的前提下,开展了横向对比实验。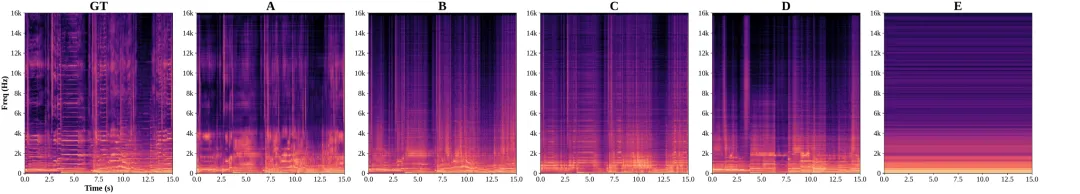 图 1:受控等预算表征对比实验重建谱图。(A) Complex STFT; (B) Waveform Patch; (C) Magnitude-only; (D) Waveform Conv1D; (E) Patch Transformer; (GT) Ground Truth 参考。
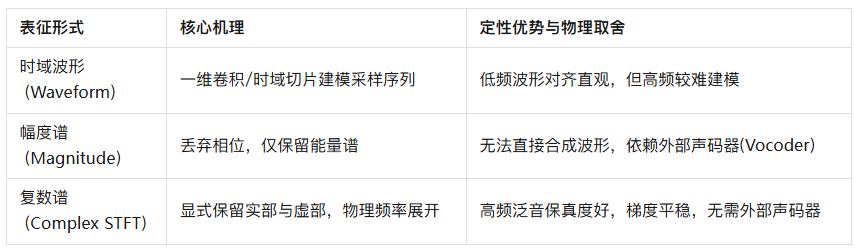
定性分析揭示了关键的声学与工程权衡:
1、时域波形方案在低频信号波形匹配上具有直观优势,但随着频率上升,其建模难度增加,导致高频频谱误差偏高,并在对抗训练中伴随较剧烈的梯度波动;
2、传统幅度谱方案虽然具备频率轴,但由于主动丢弃了相位信息,必须外挂神经声码器(如 HiFi-GAN 或 Vocos)进行反向波形预测。这种级联模式不仅结构割裂,声码器自身的还原上限也直接限制了最终音频质量;
3、复数 STFT 方案则通过实部与虚部的组合完整保留了相位和幅度,能够通过完全可微的逆变换(iSTFT)直接还原时域波形,避免了外部声码器的限制。从图 1 的重建谱图可以清晰观察到,复数 STFT 在全频带、特别是 8kHz 以上的高频敏感区域展现出更好的泛音连续性与保真度。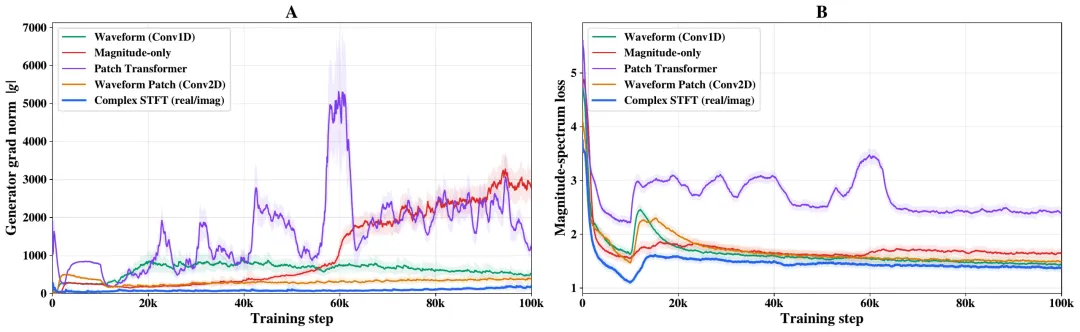 图 2:100k 步受控训练过程中 encoder 梯度范数(左)与幅度重建损失(右)轨迹。复数 STFT 方案呈现出更平稳的梯度范数轨迹与更低的损失收敛。
最本质的收益在于:STFT 将一维音频信号展开为了具有确定物理意义的二维时间-频率网格。在这一网格上,纵轴的每一个位置(Frequency Bin)都对应着固定的物理频率。这种显式的物理对齐,为在神经网络内部设计针对不同频段声学特性的定制化模块提供了结构支持。
此实验的一个先验动机是,团队认为傅里叶变换有很好的性质,能将音频从原始采样点级别的稠密信息进行高效时域压缩的同时,也引入一个具有明确可解析物理意义的表征dimension,且过程可逆(听感接近无损),非常利于深度学习模型进行进一步表征,处于一种“semi-latent”的状态
⏩二、 怎么看整体架构设计?
ε ar-VAE2 整体采用端到端 VAE-GAN 架构。输入 48kHz 立体声音频首先经过复数 STFT 转换为复数频谱,由 2D 卷积构成的频域 encoder(Spec Encoder)压缩为 25Hz 的连续高维 latent 序列,再由频域 decoder(Spec Decoder)生成粗重建复数谱,最后通过专门设计的心理声学 Refiner(Duplex-Aware Refiner)进行残差范式的精细化修正,最终经由可微逆变换(iSTFT)重构为立体声音频。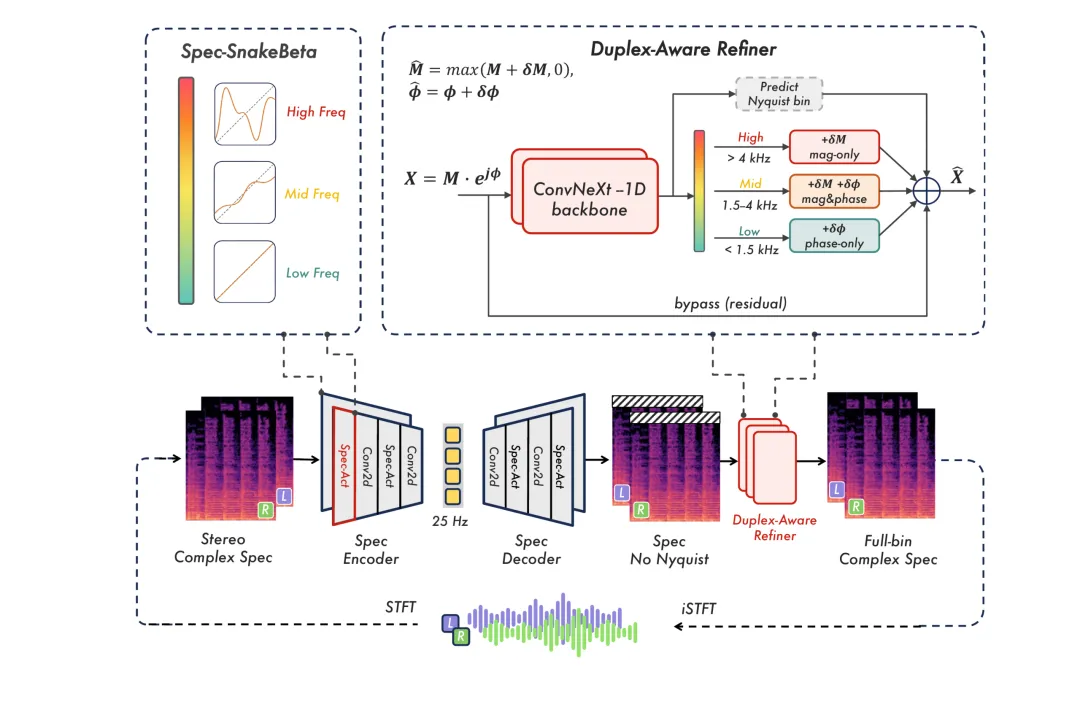 图 3:ε ar-VAE2 架构总览。立体声音频经精确对齐 STFT 转换为复数谱;Spec Encoder 压缩为 25Hz 连续 latent 序列,Spec Decoder 重建粗谱;随后 Duplex-Aware Refiner 进行分频复数残差修正并补齐 Nyquist 频点,最后由 iSTFT 逆变换合成最终波形。
⏩三、 怎么利用频域的良好性质?
1. Spec-SnakeBeta:沿物理频率轴自适应的周期激活函数
传统的非线性激活函数,在建模连续周期性信号时整体效率较低。BigVGAN 将 Snake 激活函数引入时域波形生成中,通过引入可学习的周期残差项,提升了音频的周期拟合能力。
然而,传统的 Snake 及解耦变体 SnakeBeta 是按网络特征通道(Feature Channel)来参数化周期的: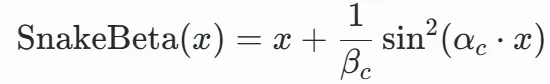 在时域波形网络中,一个通道对应全局时域特征;但在频域 2D 卷积网络中,同一个特征通道在垂直方向上横跨了从几十赫兹(低频基音)到两万多赫兹(超高频空气感)的所有物理频点。如果对所有频点强行应用同一组周期参数 图片,违背了频谱在不同物理频段具有不同振荡特性的物理规律。
为此,ε ar-VAE2 提出了沿物理频率轴参数化、并在特征通道间共享的 Spec-SnakeBeta: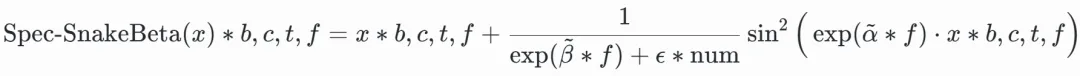
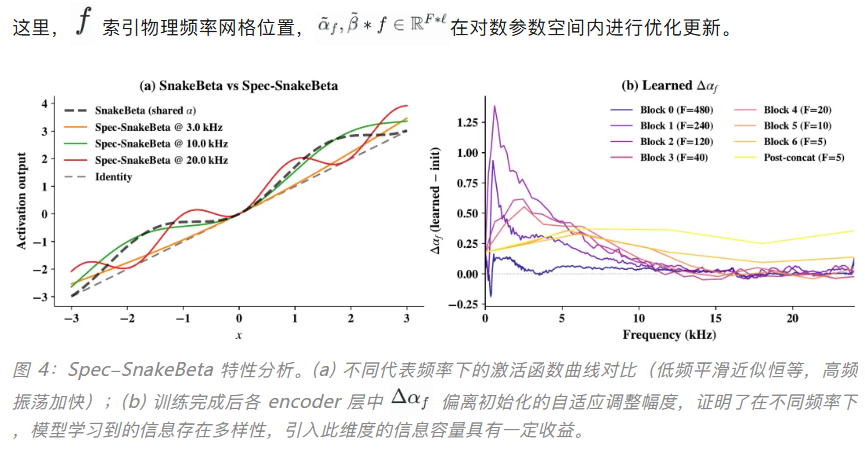 图 4:Spec-SnakeBeta 特性分析。(a) 不同代表频率下的激活函数曲线对比(低频平滑近似恒等,高频振荡加快);(b) 训练完成后各 encoder 层中 图片 偏离初始化的自适应调整幅度,证明了在不同频率下 ,模型学习到的信息存在多样性,引入此维度的信息容量具有一定收益。
对数空间频率比例初始化先验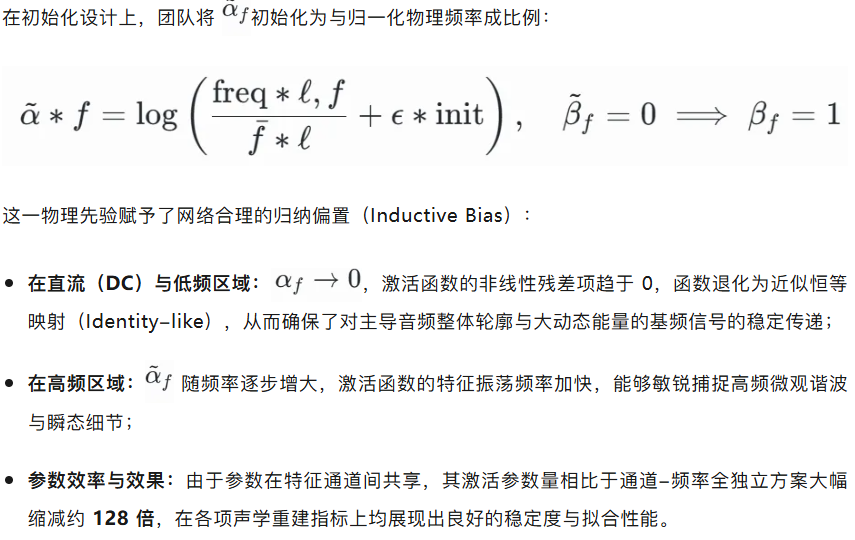
2. Duplex-Aware Refiner:将“双耳双重理论”融入神经网络
在经过 encoder-decoder 的重构后,音频的主体能量骨架已然形成,但在频谱细节处依然残留着微弱的系统性重构误差。
分析已训练完成的 decoder 输出误差,可以观察到清晰的频段结构化规律:幅度误差主要集中在 1.5kHz ~ 4kHz 的中频过渡区域,而相位角误差在 4kHz 以上的高频段迅速上升至随机相位 baseline。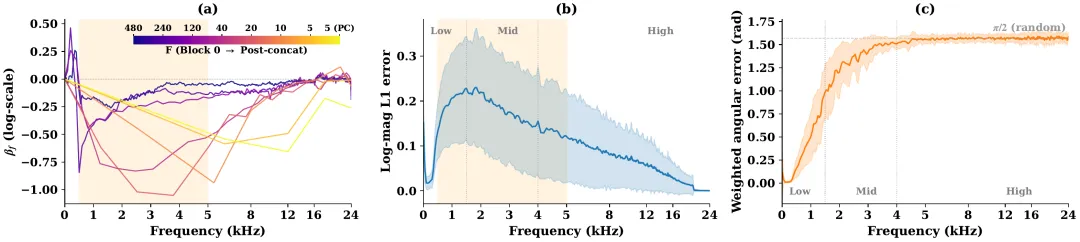
 这一经验误差特性与经典的心理声学Rayleigh 双耳理论(Duplex Theory)呈现出高度吻合:
1、人类听觉系统在感知声音空间方位时,对<1.5 kHz的低频主要依赖双耳时间差/相位差(ITD/IPD);
2、对> 4.0 kHz的高频,由于波长短于头颅尺寸产生明显的头部阴影效应,主要依赖双耳声级差/能量差(ILD),对绝对相位不再敏感;
3、1.5 ~4.0 kHz则属于二者交织的平滑过渡带。
基于此,ε ar-VAE2 构造了专门设计的轻量化Duplex-Aware Refiner:
Duplex-Aware Refiner 心理声学分频修正机制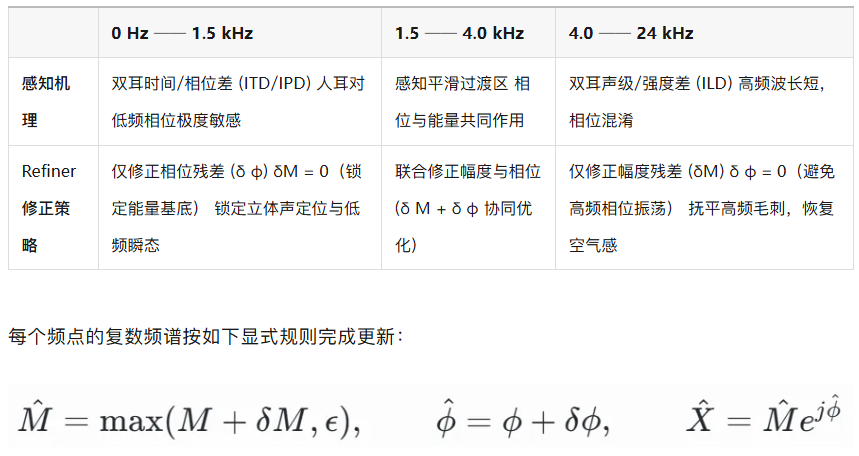
这种基于听觉感知的结构约束带来了两方面优势:
1、计算与参数大幅精简:相较于全频段无约束修正(Unconstrained Refiner),其残差输出维度直接削减了约 45%;
2、声学质感改善:规避了高频相位在对抗学习中的无效拟合,降低了双耳相位差(IPD)和双耳声级差(ILD)的偏离误差,使得重构音频的声场更加通透开阔,声音定位更加凝聚清晰。
⏩四、 怎么做数据管线?
在VAE模型的训练中,数据集的acoustic信息质量直接决定了模型的高频建模与立体声重构能力。海量wild音频源中普遍混杂着各种“假无损”音频,最典型的包括:
1、转码伪无损:将低码率有损音频(如 128kbps MP3)重新封装为 FLAC 或 WAV 格式;
2、升采样伪高频:低采样率文件(如 16kHz/24kHz)强制重采样到 48kHz,高频区域(如 >12kHz 或 >16kHz)实际为空白或仅有低能量噪声;
3、伪立体声:左右声道完全一致或差分能量极低的单声道硬复制文件;
4、母带失真与响度过载:极端削顶失真(Clipping)、动态范围被严重压缩或过分安静的异常曲目。
如果将这些脏数据直接送入网络,自编码器会学习到虚假的高频能量分布或错误的声道相位关系。为此,研究团队设计了一套全自动的音频质量与来源审计流水线。
整套流水线从元数据探查与物理波形解码两条并行路径展开审计,覆盖来源可信度、码率特征、响度与动态、立体声真实性以及频谱有效带宽五个维度,共包含十五项具体判据,确保入库音频在声学物理特性上的一致性。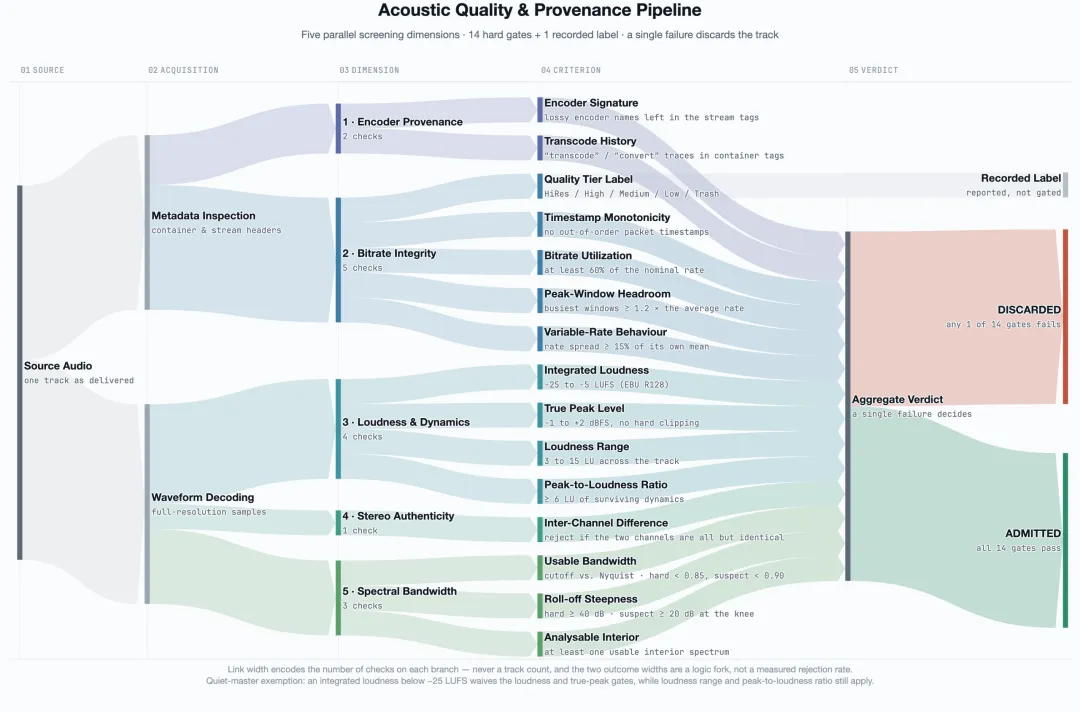 图 6:音频质量流水线的数据流拓扑。左起为输入音频,分为元数据探查与波形解码两路,汇入五个检测维度及其判据,最终给出初步的二元入库判定,后续再进行质量分层。
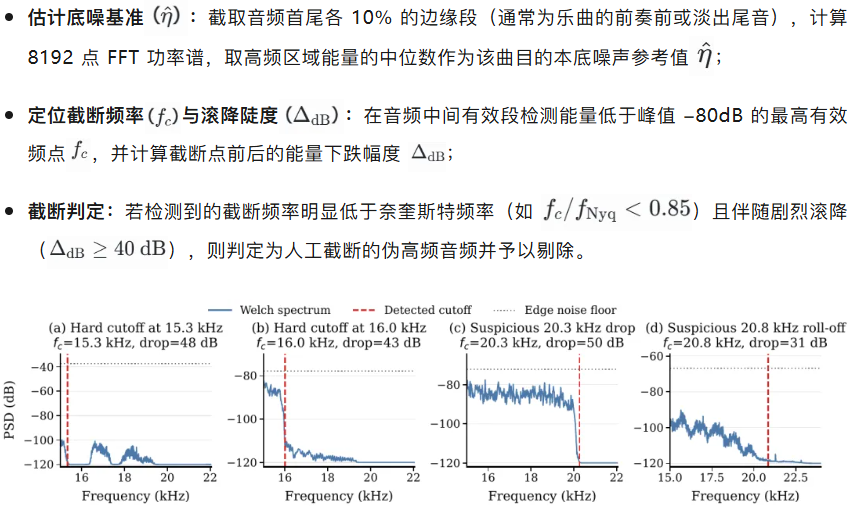
1. 结合本底噪声的高频截断检测
识别升采样伪高频的关键在于将真实的高频声学能量与录音设备本底噪声区分开来。传统基于固定能量阈值的检测方法容易把高噪声的假高频误判为真高频,或将高频原本就平缓的真实乐器误杀。
流水线采用了边缘段与主体段解耦的动态检测方案:

2. 多维度声学规则检查
在频谱检测之外,流水线还执行多项物理与容器级检验:
1、转码与编码工具痕迹:检查容器和音频流标签,过滤带有已知转码工具(如 lavf, lavc, ffmpeg, lame)重编码标记的伪无损文件;
2、码率与时间戳连续性:验证 PTS 时间戳单调性,检查 VBR 码率波动系数与标称码率利用率,过滤异常截断或填充无用码流的文件;
3、响度与动态范围标准:参考 EBU R128 标准,对综合响度图片、响度范围(LRA)及峰值响度比(PLR)设定门槛,同时对古典/室内乐等弱录音设置豁免路径,避免误杀大动态优质录音;
4、双声道差分检验:统计左右声道逐采样点差分绝对值低于图片的比例,剔除假立体声。
⏩五、 呈现了什么工程经验?
为了确保在大规模数据上训练收敛稳定,团队构建了一套分步演进的工程训练体系: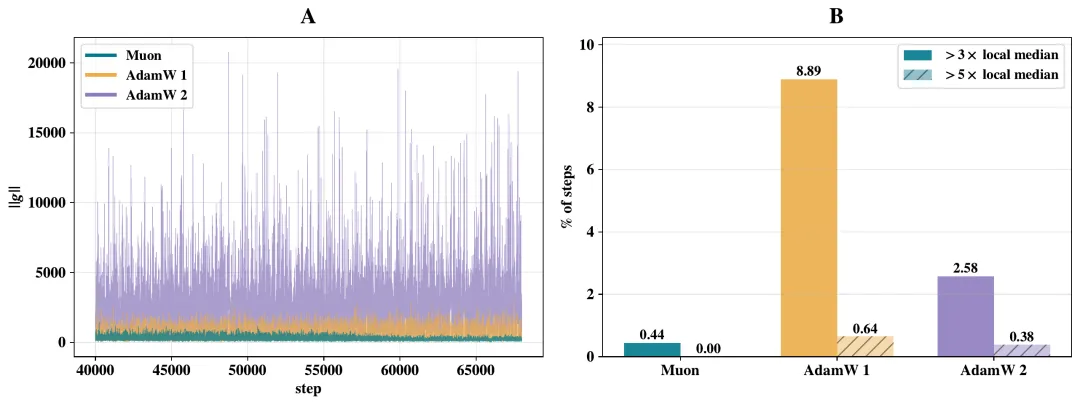 图 8:(A) Muon 与 AdamW 在训练稳定期的梯度范数 g 变化轨迹;(B) 局部梯度尖峰发生率对比(Muon 展现出更低的尖峰发生率与更好的稳定性)。
1. 卷积适配的 Muon 优化器
Muon 优化器原本用于大型 Transformer 模型中 2D 权重矩阵的正交化更新。为了将其引入频域 2D 卷积网络中,团队将多维卷积核张量展平为二维矩阵,利用五阶 Newton-Schulz 迭代进行动量正交化。如图 8 所示,Muon 优化器有效平抑了对抗生成训练过程中频繁出现的局部梯度尖峰,使模型在保持较高学习率的同时稳步收敛。
⏩八、 总结与在线体验
ε ar-VAE2 从频域物理坐标与人类双耳声学规律出发,通过复数 STFT 表征、按频点周期自适应激活(Spec-SnakeBeta)、心理声学分频修正器(Duplex-Aware Refiner) 以及规范场判别优化等一系列技术设计,缓解了传统时域波形自编码器在高采样率立体声重建中存在的高频毛刺感与声像塌缩问题。
面向更广泛的研究者、创作者与工程师群体,ε ar-VAE2 的交互式试听主页现已完整开放,代码与权重也已开源:
交互式 Demo 体验主页:https://eps-acoustic-revolution-lab.github.io/EAR_VAE2/
