Cactus Compute 开源 16.9MB 语音识别模型 Whistle

Cactus Compute 发布开源语音识别模型 Whistle,面向手机、可穿戴设备、机器人、汽车和微控制器等端侧设备。 模型文件仅 16.9MB,直接在 CPU 上运行,并与其端侧工具调用模型 Needle 共用同一套 C++ 推理引…
开源资讯
15 0 0

Cactus Compute 发布开源语音识别模型 Whistle,面向手机、可穿戴设备、机器人、汽车和微控制器等端侧设备。 模型文件仅 16.9MB,直接在 CPU 上运行,并与其端侧工具调用模型 Needle 共用同一套 C++ 推理引…
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。 相比此前主要面向语音识别的 YODAS,v3 加…
过去两年,TTS(文本转语音)赛道的竞争焦点发生了一次微妙的转移。 早期大家比的是“像不像真人”——音色克隆、自然度、音质MOS分。但当ElevenLabs把Voice Design的概念带火之后,一个新的问题浮出水面:一个声音“好听”,不…
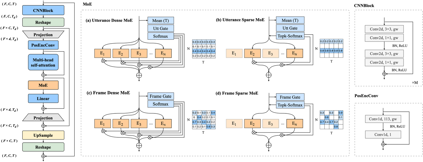
近日,蚂蚁集团-大安全机器智能-AI身份智能团队,推出基于混合专家机制(MoE)的声纹识别模型 MECT(Mixture of Experts CNN-Transformer),首次将 MoE 机制引入全监督训练说话人识别领域。在权威基准
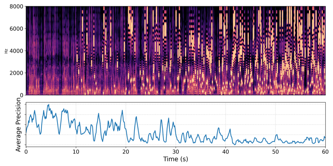
传统声纹识别只估计一个「均值」——一个确定的嵌入点,却从不估计它的「方差」——这个估计到底有多可信。而一段语音里,并不是每一帧都「平等」:噪声、混响、静音都在悄悄稀释说话人的身份线索。这个缺失的方差,正是「不确定性」。本文提出的 U³-xi…
AI 做音乐这件事,过去一年我们看着 Suno、Udio 一路高歌,Demo 一个比一个惊艳,价格也一个比一个贵。 然后我们再回头看开源世界——不是模型出不来歌,就是质量差一截,或者干脆闭源让你摸不着它是怎么把词变成旋律的。 最近,港科大、…
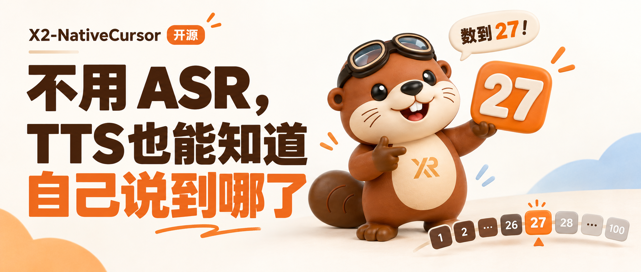
你让一个全双工 AI 助手“从 1 数到 100”。它采用 token 级流式 TTS(文字转语音):大模型生成数字序列,TTS 持续合成,播放器一边接收一边播放。 假设大模型已经生成了完整的数字序列,声音却刚播到 27: 模型已经生成:1…
由于大规模实录多通道音频数据集的匮乏,基于深度学习的多通道语音增强和声源定位非常依赖于房间冲激响应以及多通道扩散噪声的仿真。然而,仿真数据与实录数据的声学特性差异会使得模型在泛化到真实场景中时增强与定位性能下降。为了降低仿真到真实泛化带来的…
声纹识别是语音领域一个重要的问题,一个鲁棒性强的声纹模型也能够让许多下游任务(语音分离,说话人日志等)受益。然而,声纹识别一个重要的痛点在于说话人人数的多少,这也间接影响着语种,信道的多样性。为了丰富开源语音语料库,为训练声纹大模型提供强有…
随着人工智能新一轮浪潮兴起,AI语音对话技术日趋成熟,带来越来越好的智能语音交互体验。但全球仍有大量语言障碍的人无法进行正常的沟通交流以及与智能语音产品交互。因此,为了加快技术迭代,快速推动相关项目的研发,希尔贝壳(AISHELL)开源了A…
