
 语音小管家
根据3月29日在上海召开的全国声学大会语言声学分论坛上的现场报告整理而成。
报告摘要
在深度学习的推动下,语音识别取得了显著进展,但语音识别相关产品在落地上并不尽如人意。因此,在语音识别的基础技术上进行大胆创新,突破现有技术的边界,是人工智能研究的核心内容,具有重要学术价值。本报告将简单回顾从上世纪七十年代以来,语音识别研究中出现的几代典型技术,然后探讨新一代语音识别技术的若干新特点,特别是数据高效、自动机器学习以及可信赖。报告将分享我们的若干进展,包括:基于神经时序分类状态拓扑条件随机场(CTC-CRF)的端到端语音识别,跨维随机场语言模型(TRF),以及基于直通梯度的神经网络架构搜索(ST-NAS)。
报告人:欧智坚
一、语音识别简史
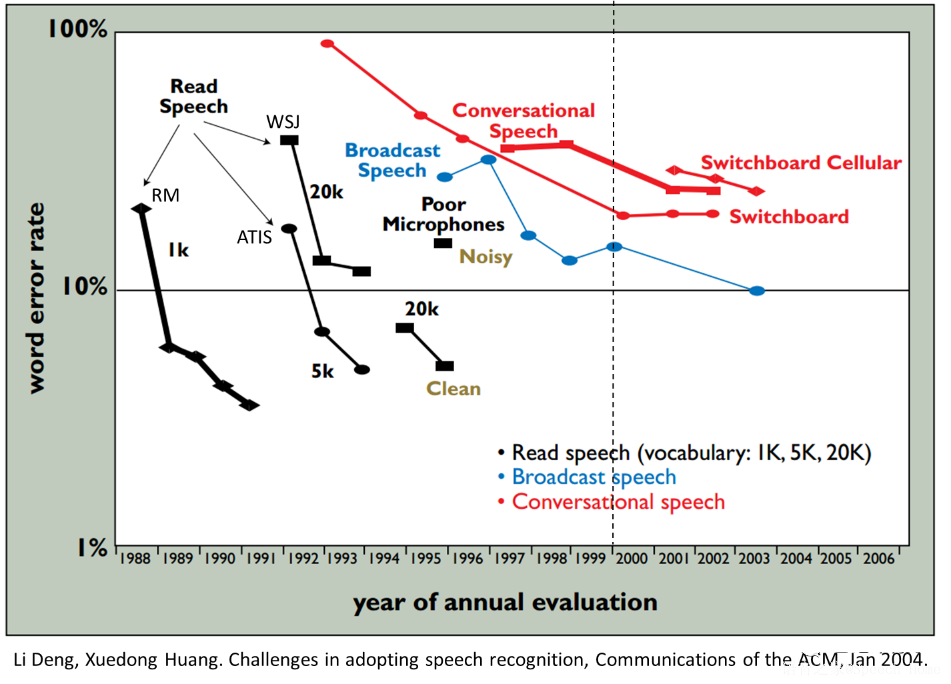
语音识别的历史可以追溯到上世纪70年代甚至更早,从上世纪80年代有了明显进步,词表大小从1k、5k到20k;识别任务从对朗读语音,广播新闻到对会话语音的识别。上世纪90年代呈现比较快速的进步,2000之后进展缓慢。Switchboard是对电话会话的语音识别,是研究者常用的基准测试。2000之后在Switchboard基准任务上的WER(错误率)几乎陷入了停滞,这种停滞直到深度学习登上历史舞台,并在2010年完全成为主流。
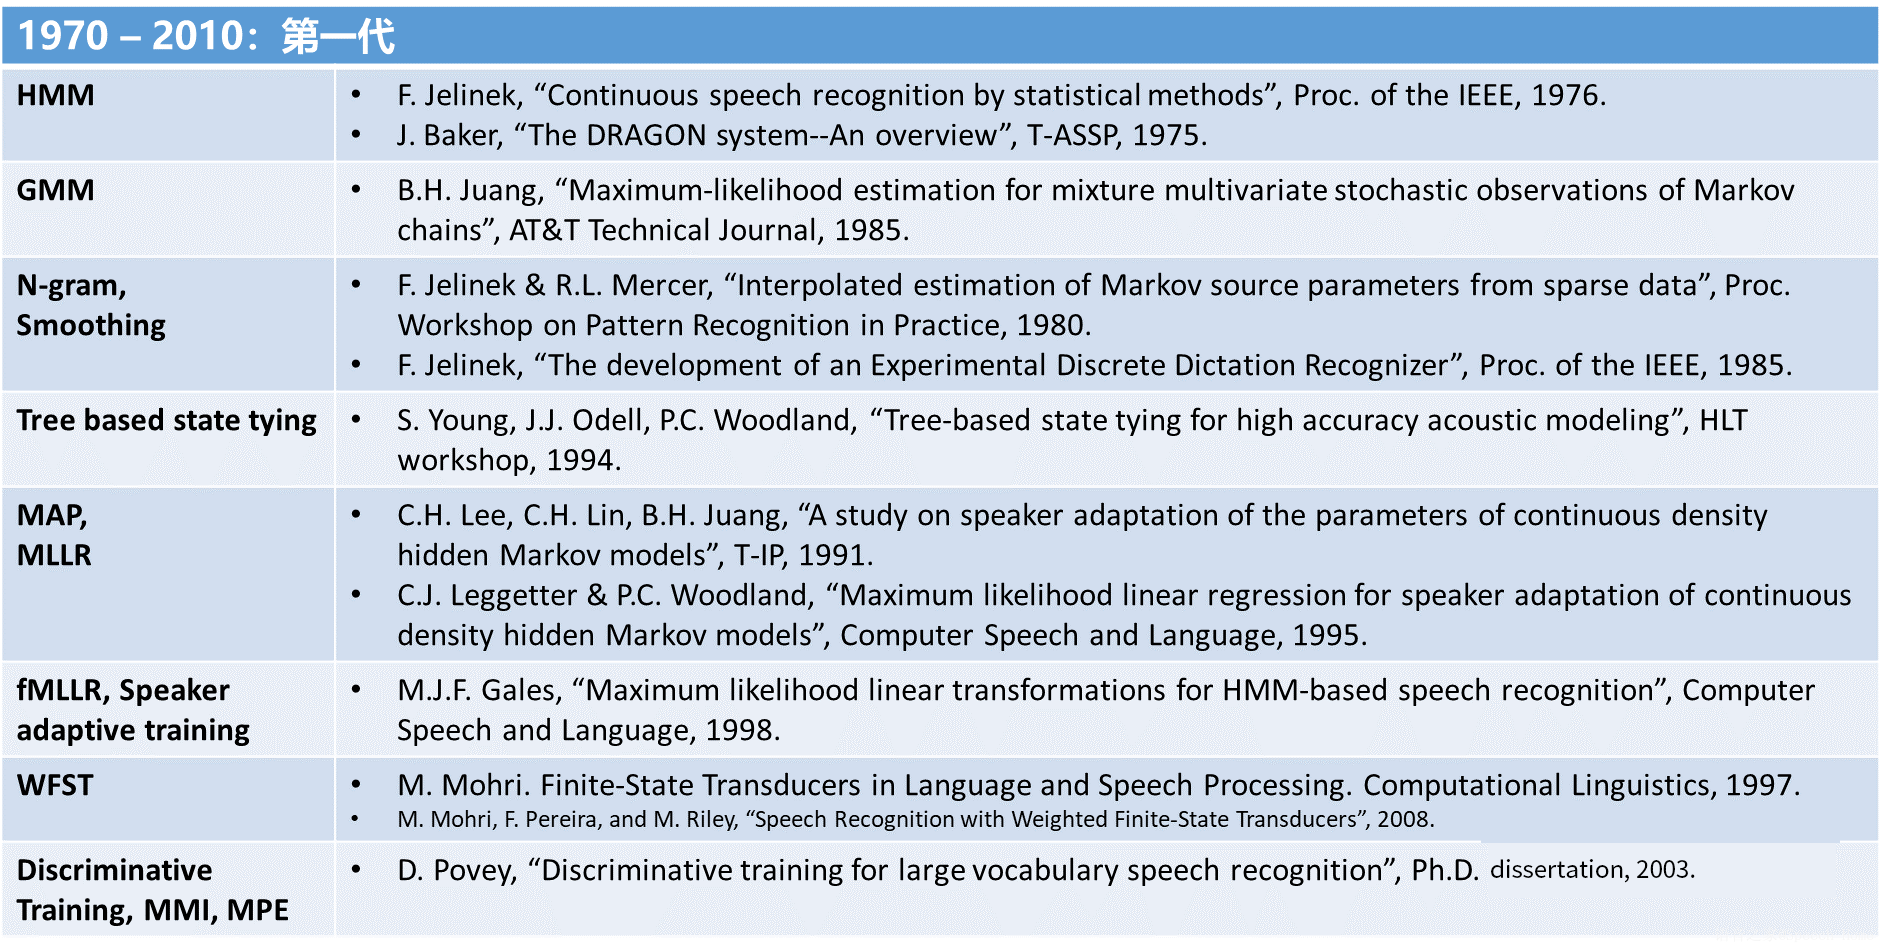
从技术呈现的基本特点出发,把1970到2010年称为第一代,上图总结了第一代语音识别40年间发展的主要技术,以及公开发表的最早文献。1975年左右,建立了以HMM(隐马尔可夫模型)为基础的统计语音识别框架,并影响至今。80年代,发展了GMM(高斯混合模型)、n-gram(n元文法)、以及基于决策树的上下文状态捆绑,进一步完善了这个框架,笼统可称为GMM-HMM技术。之后,说话人自适应、特征变换、以及说话人自适应训练,改善了语音识别说话人无关稳健性,相继得到较多关注与研究。上世纪末发展的WFST(加权有限转换器)框架,有效整合各种知识源(HCLG),并压缩优化了识别状态空间,极大简化和改进了语音识别系统的构建。HMM作为生成式模型的训练目标(最大似然)与识别目标(最优分类)不十分一致,针对此发展起来的鉴别训练,到本世纪初,已趋成熟。这些差不多构成了第一代语音识别的基本特点,或者说它们定义了第一代语音识别。
2011年是个分水岭,在Interspeech2011上微软研究者展示了在Switchboard基准任务上,运用DNN-HMM,错误率降到了百分之十几,而这之前第一代系统(鉴别训练的GMM-HMM)徘徊在百分之二十几。
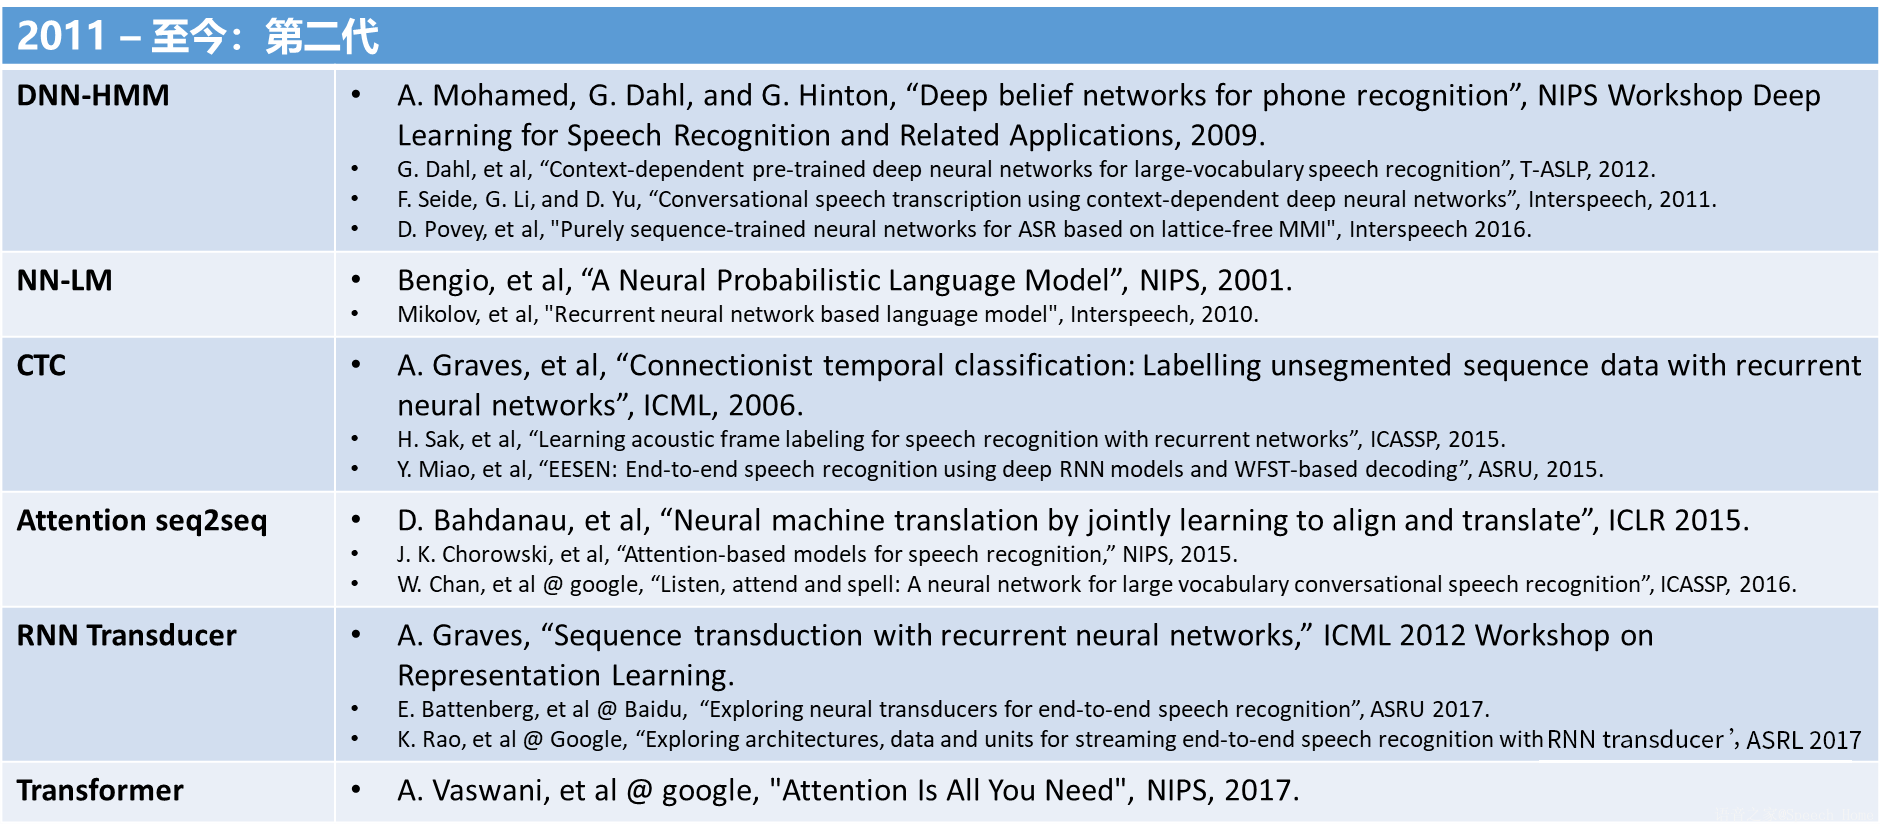
不妨认为,从2011开始,语音识别全面进入第二代,上图总结了2011年至今发展的主要技术,以及公开发表的最早文献。在这期间,声学模型发展了DNN-HMM(深度神经网络-隐马尔可夫模型),语言模型发展了NN-LM(神经网络语言模型)。鉴于DNN-HMM是一种混合式(hybrid)系统,不能自举,需要GMM-HMM提供状态对齐,另外还需要决策树构建上下文音子,近年来一个研究趋势是,端到端语音识别,旨在更多使用神经网络来简化语音识别系统,涌现了不同的模型架构,主要有基于CTC(神经时序分类),Attention seq2seq(基于注意力的序列到序列),RNN Transducer(递归神经网络转换器)。在第二代语音识别中,神经网络架构,成为制约模型性能的关键因素。Transformer通过使用自注意力(self-attention)利用长程依存性(long-range dependencies)同时避免了RNN(递归神经网络)的梯度消失问题,得到比较多关注。这些差不多构成了第二代语音识别的基本特点,或者说它们定义了第二代语音识别。
二、当前语音识别面临挑战
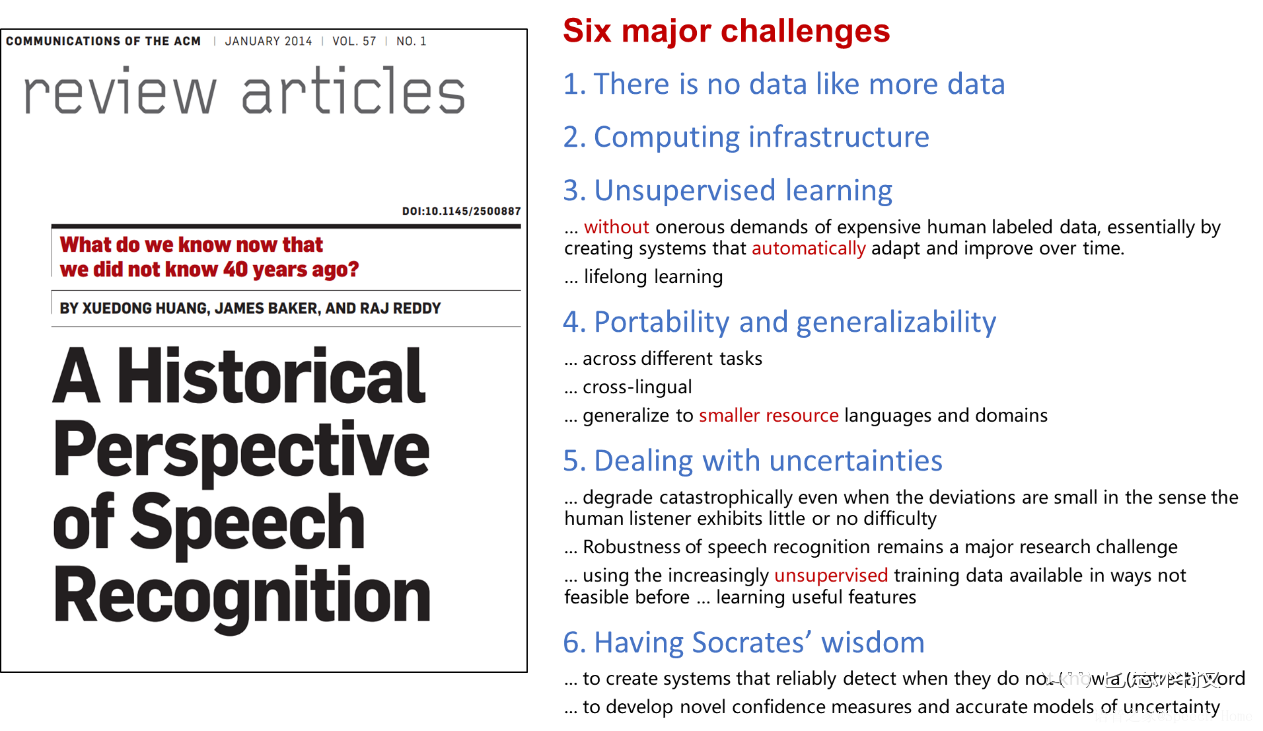
对于当前第二代语音识别技术下我们仍面临的挑战,由语音领域3位资深学者黄学东博士、James Baker、Raj Reddy在2014年发表的“语音识别的历史透视”一文中阐述了六大挑战。第一,需要更多的(标注)数据;第二,需要更强大的计算基础设施;第三,无监督学习;第四,可移植性和泛化性;第五,处理不确定性;第六,具有苏格拉底式的智慧。
第一为语音技术研究提供数据基础,第二提供硬件基础,一直以来非常重要。
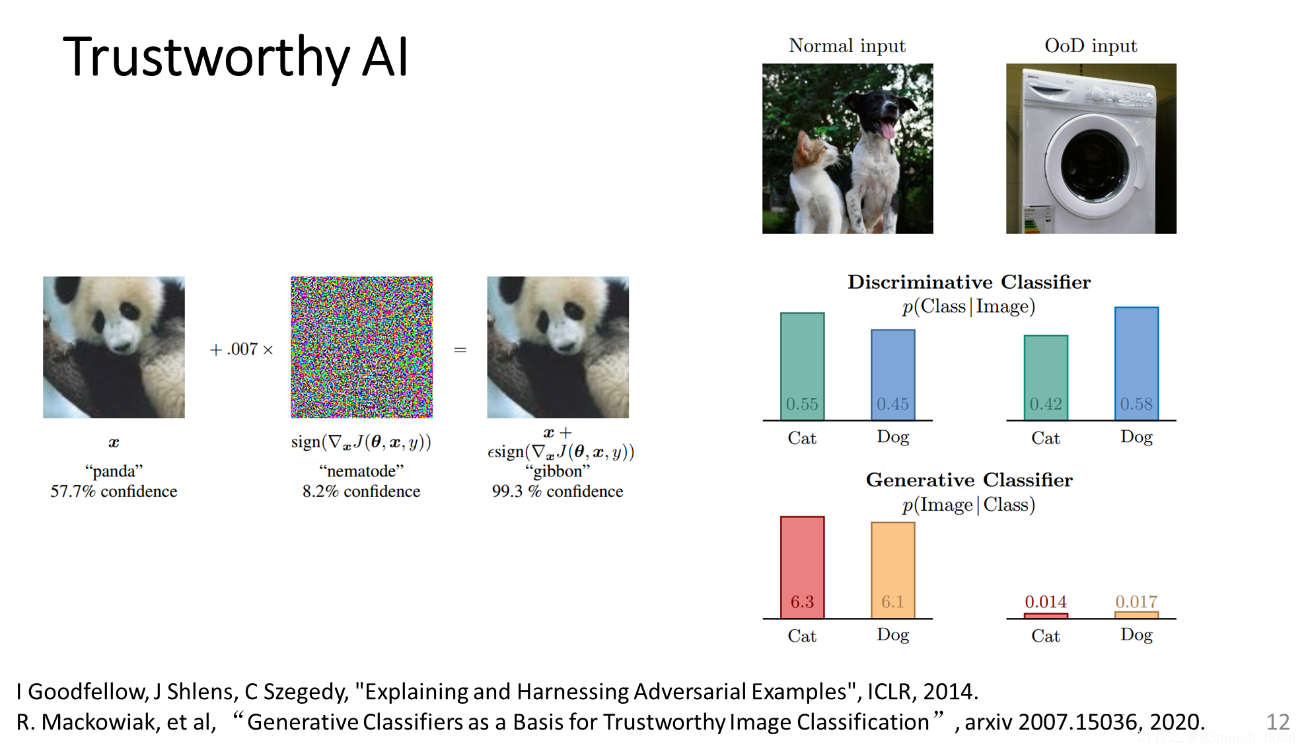
先来看第六条,苏格拉底式的智慧指“自己知道自己不知道”,这正是现在的神经网络系统欠缺的。现在的神经网络系统大都过于自信(over-confident),在出错时分类或预测的后验概率仍出奇得高,让人难以信赖。下面为便于理解,以图像为例举了两个不同情形的例子。左边,一幅熊猫图片加上人眼无觉察的对抗噪声,被神经网络识别成了“长臂猿”,而且是99.3%后验概率。另外,没受到攻击也容易出错,而且出错时也不知道自己出错了。右边展示了,现在神经网络对OOD输入(分布外的输入)的识别,存在的“不可信赖”的问题。考虑我们训练了一个分类器,来鉴别一张图是猫,还是狗?对于通常的鉴别式分类器,对左边这张有猫有狗的图,识别成55%的概率是猫,45%是狗,这挺不错。对右边这个洗衣机的图片,识别成42%是猫,58%是狗,这就错的离谱。研究者提出生成式分类器,可以计算出更为合理的后验概率。计算结果可信赖(Trustworthy),应该是新一代语音识别乃至人工智能的基本特点之一,因为时间关系,不再展开了。
下面我们重点从3,4,5出发来看,为迎接挑战,新一代语音识别应具备的基本特点。第3条,指出无监督学习,摆脱过度依赖于高成本人工标注的瓶颈,能够自适应,自改善,并终生学习。这意味,机器能在尽可能少的人工标注下高效学习,小样本就能训练好,并能自我演化。第4条,指出低资源下泛化性。第5条,指出能以前所未有方式,进行无监督的表征学习,这还是追求数据高效。以上这些,表明新一代语音识别应具备的特点包括,更加数据高效地建模与学习(即Data-efficient),并且自动机器学习(AutoML)。
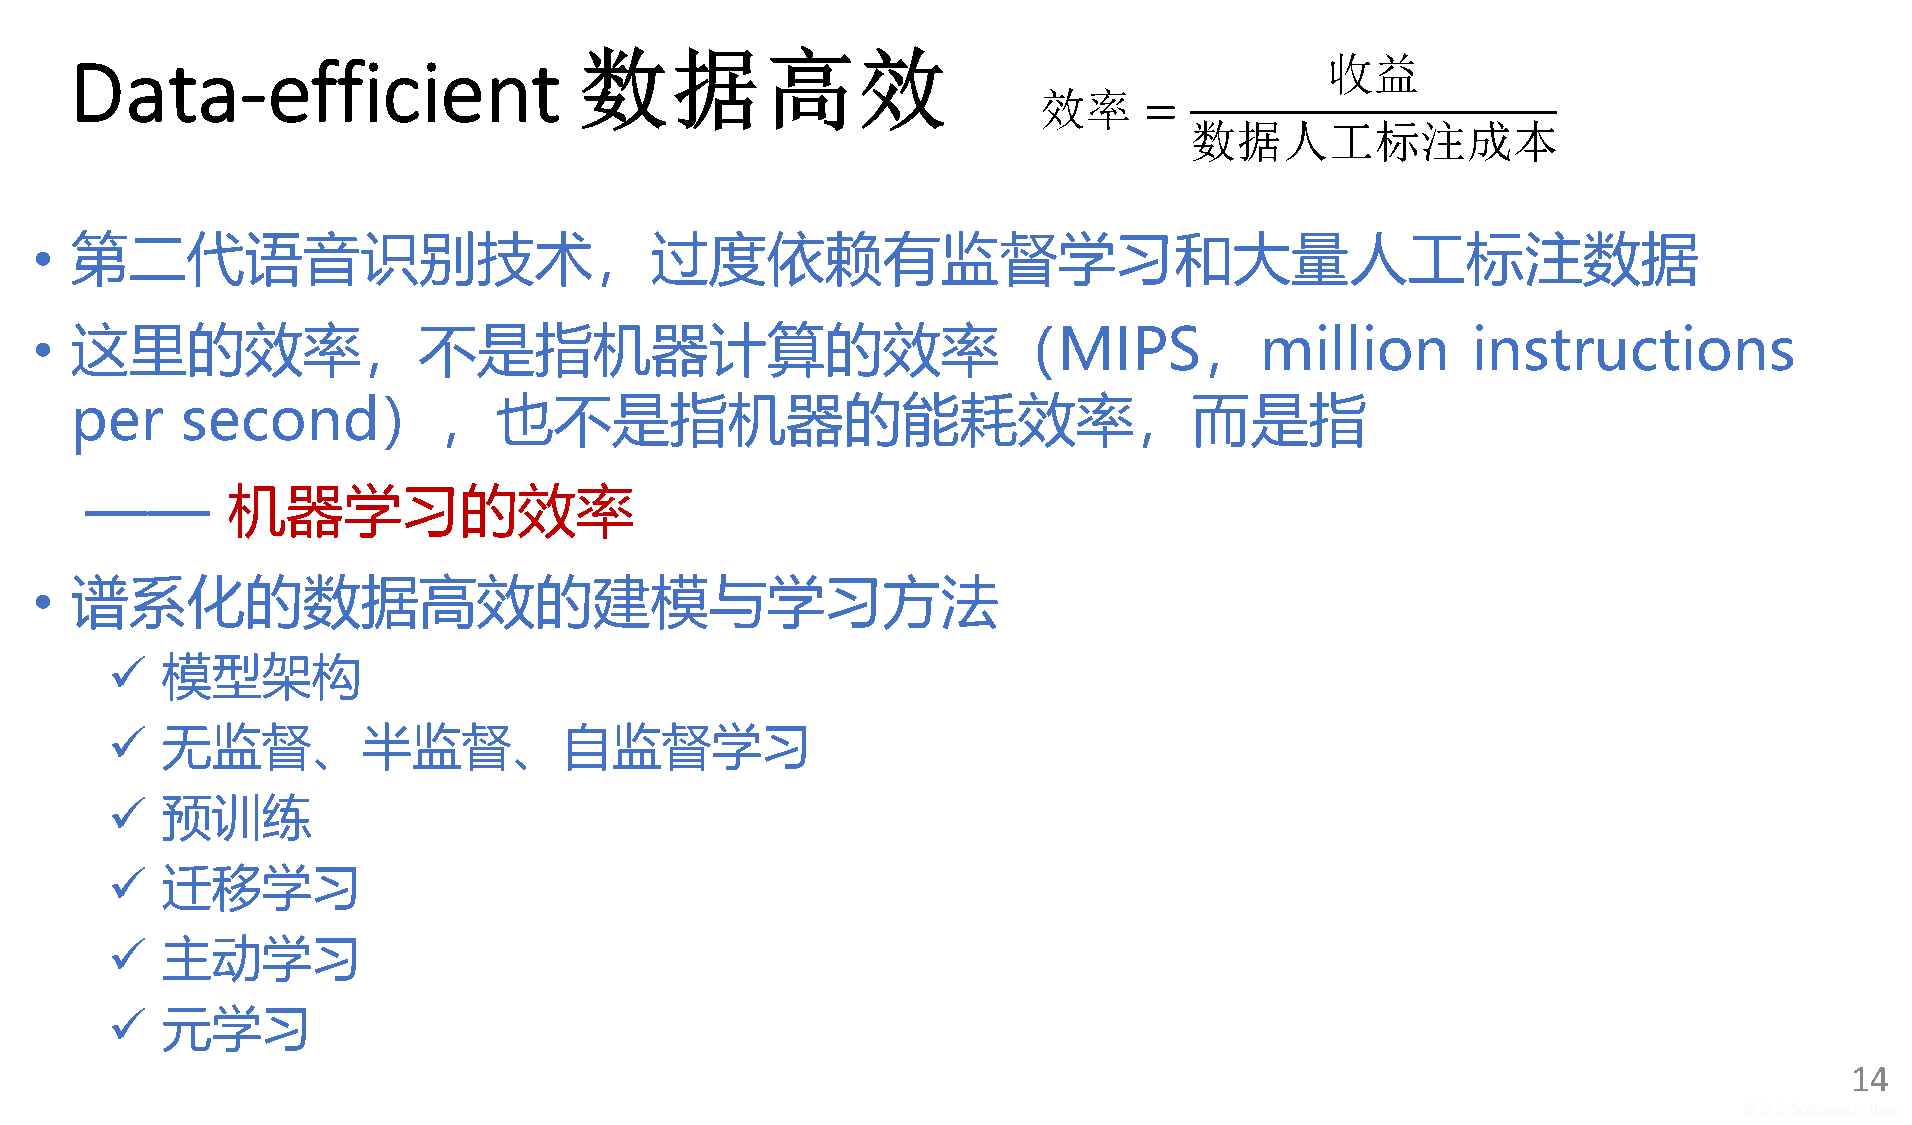
下面解释一下数据高效的概念。我们知道,效率等于收益除以成本。数据高效中的效率,不是指机器计算的效率(比如MIPS),也不是指机器的能耗效率(比如MIPS/Watt),而是指机器学习的效率,也就是在数据人工标注成本一定的条件下,系统性能的提升衡量了效率。不能仅靠大量标注数据,这样数据效率比较低。值得注意的是,数据高效不是靠单一方法来完成,而是一个系统思维,包括建模和各类学习方法,例如模型架构,无监督、半监督、自监督学习方法,目前受到较多关注的预训练加微调方法,迁移学习,主动学习,元学习等。这样,才有望突破目前第二代过度依赖有监督学习和大量人工标注数据的缺陷。
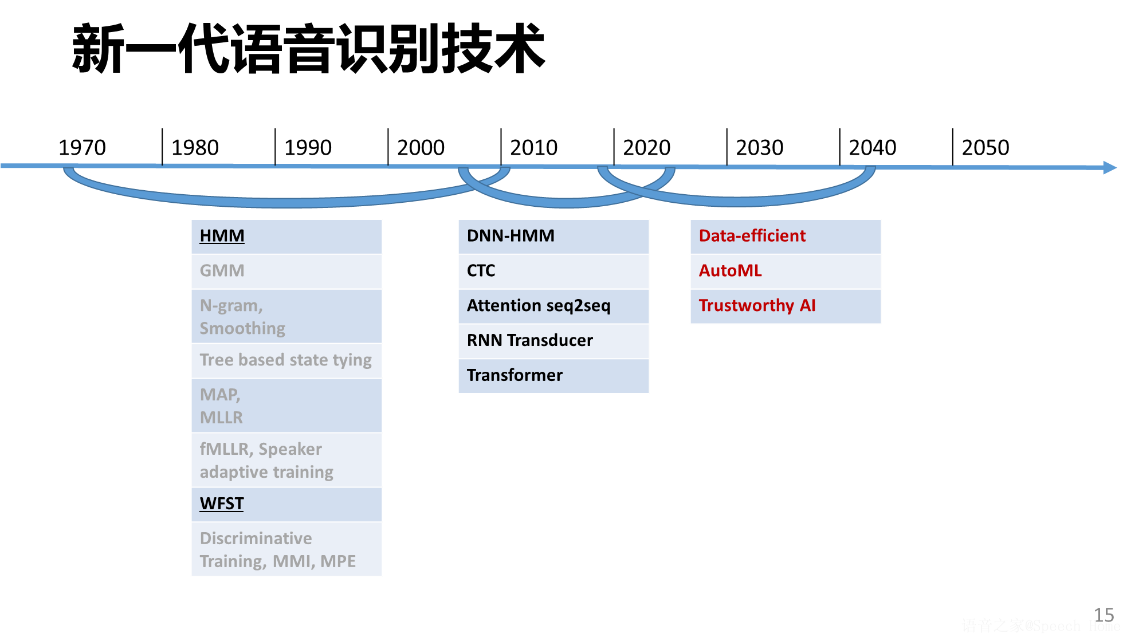
总结一下,从历史的发展看,第一代语音识别中积淀下来的HMM,WFST,至今仍被使用,其它则逐渐退出历史舞台。经历了第一代、第二代发展的历史,个人总的体会有两点。第一,相信理论,理论上正确迟早要发光。第二,相信简单可伸缩,简单可伸缩的生命力强。在第二代语音识别技术肩膀上,发展起来的第三代语音识别的基本特点,个人以为应该包括:数据高效,自动机器学习,以及可信赖。在这三点上有突破,第三代语音识别技术才真正超越了第二代的局限。下面将主要分享我们在数据高效、自动机器学习方面的若干进展。
三、新一代语音识别技术若干探索
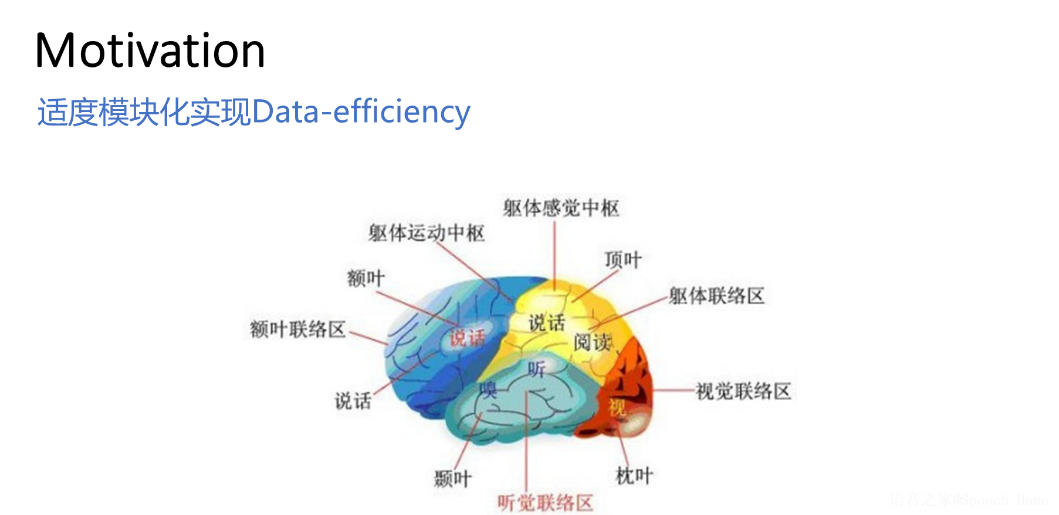
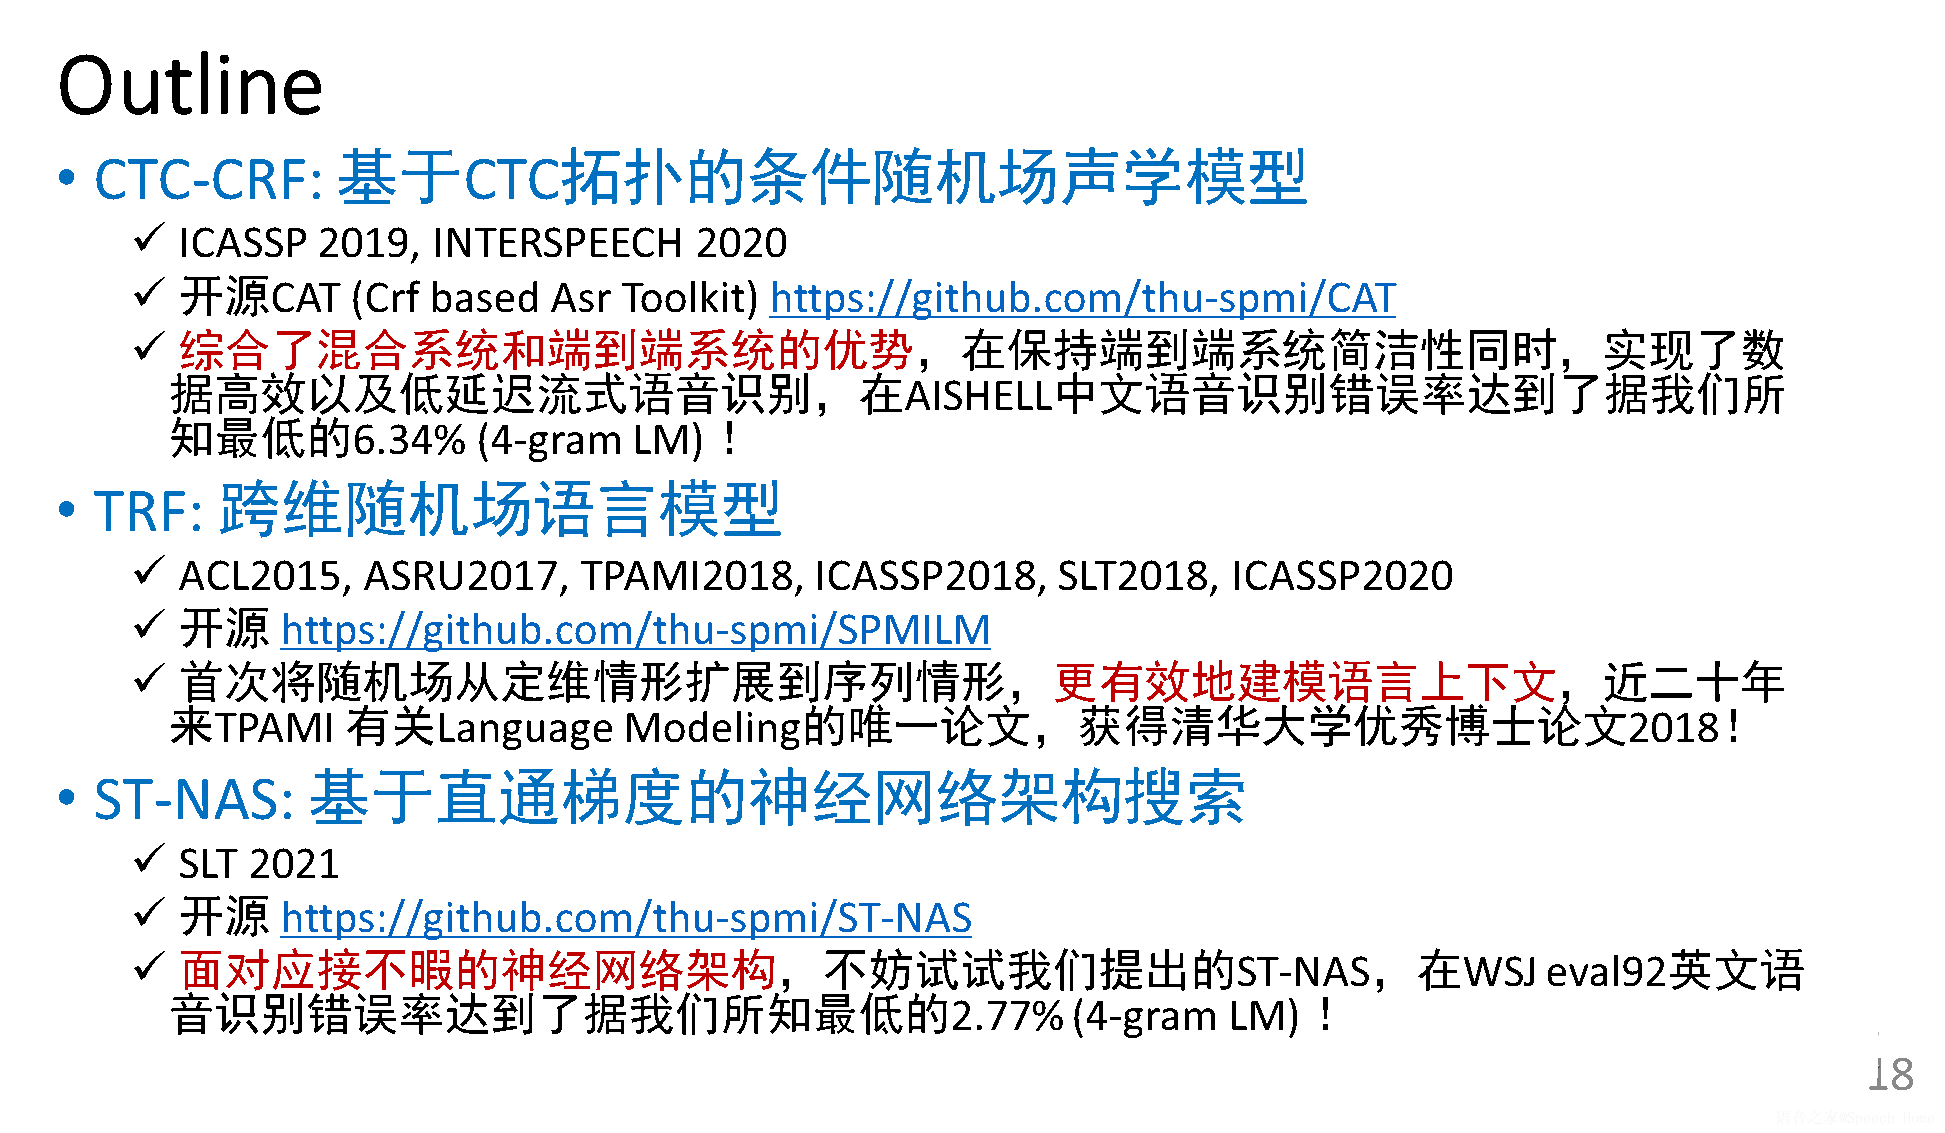
首先,面向数据高效,我们在模型架构上的一个考虑就是适度模块化,不追求过度的端到端,保留了声学模型、语言模型的必要分解,就像在人类听觉和大脑皮层系统中,听与语言阅读是分区的。在数据高效的思想指导下,我们设计了分立的声学模型,语言模型,并进一步开展了神经网络架构搜索(NAS)的研究,朝AutoML努力。下面将分开介绍我们的三个具体工作。每个工作,我们将介绍该工作的研究动机,相关工作(即该工作在学术上当前研究图景中的位置),工作本身,实验结果以及小结。
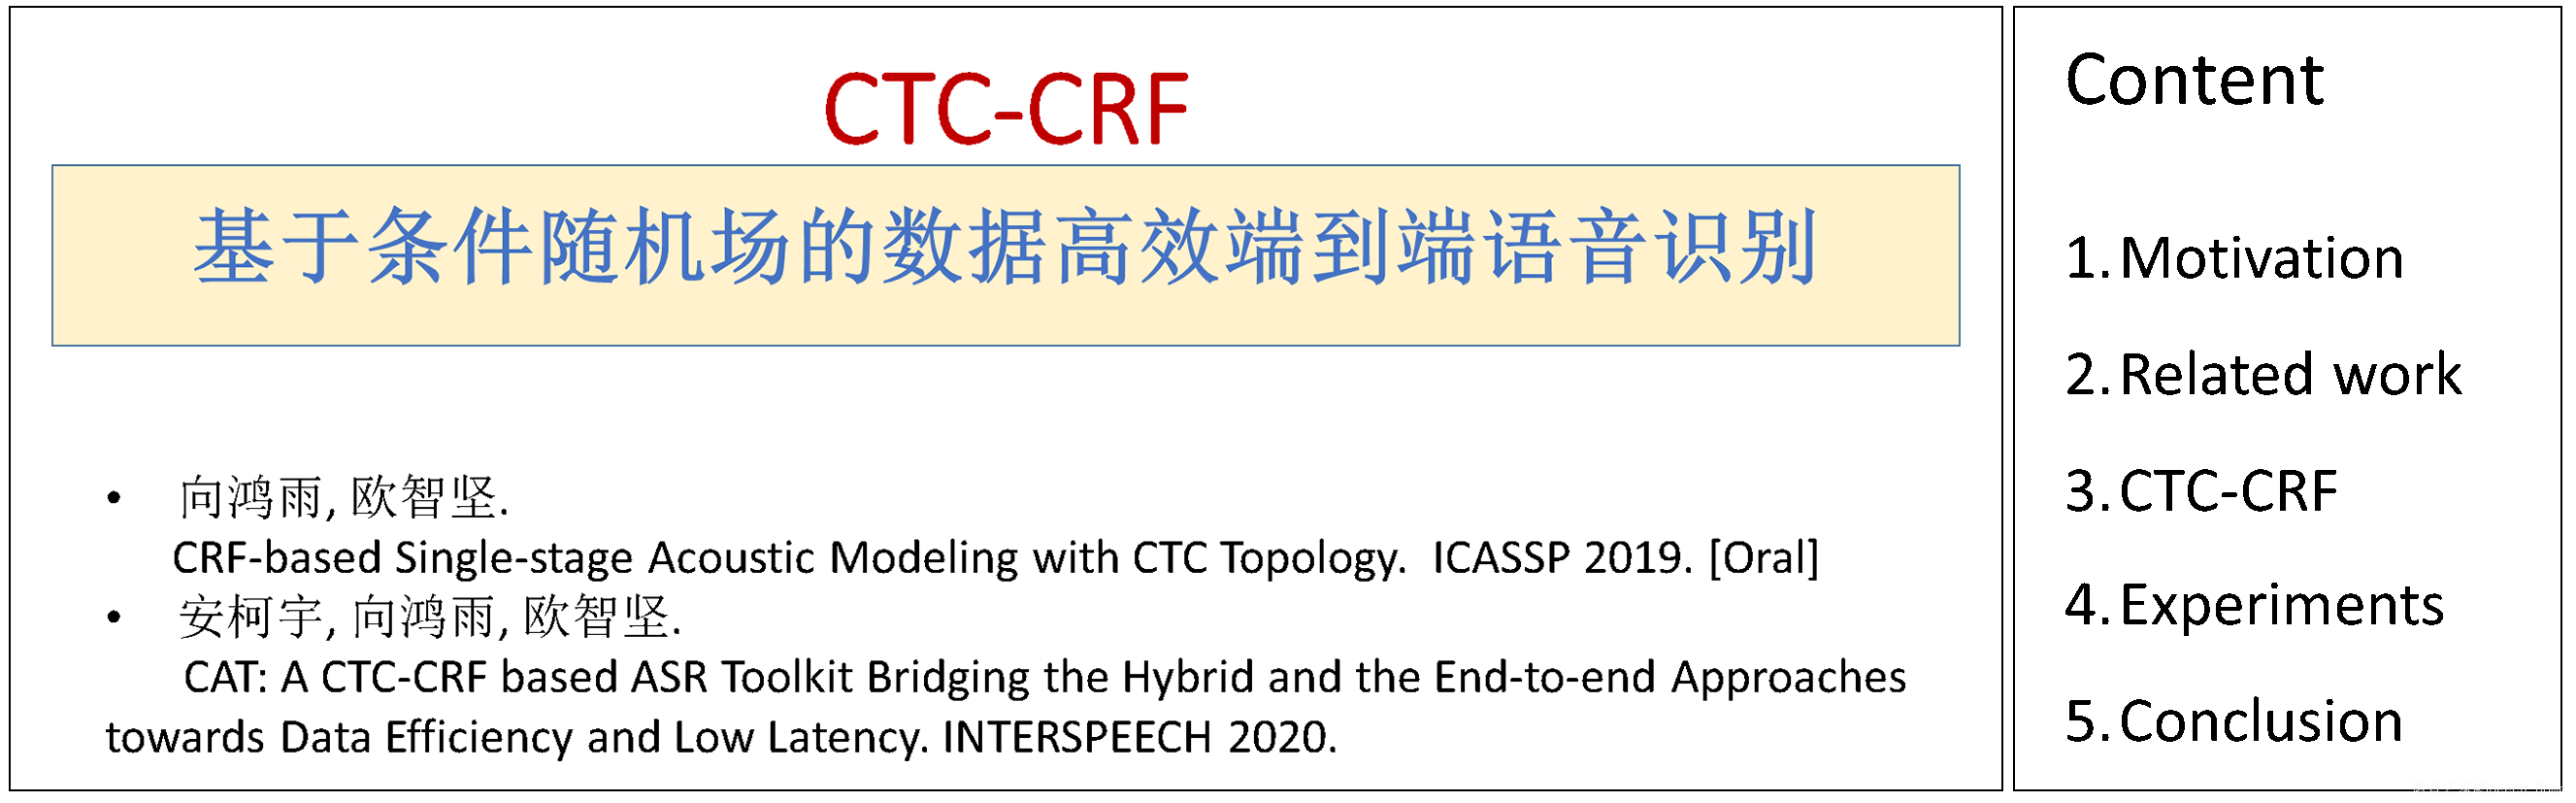
四、CTC-CRF
下面介绍“基于条件随机场的数据高效端到端语音识别”,简称CTC-CRF,包括介绍该工作的研究动机,相关工作(即该工作在学术上当前研究图景中的位置),工作本身,实验结果以及小结。
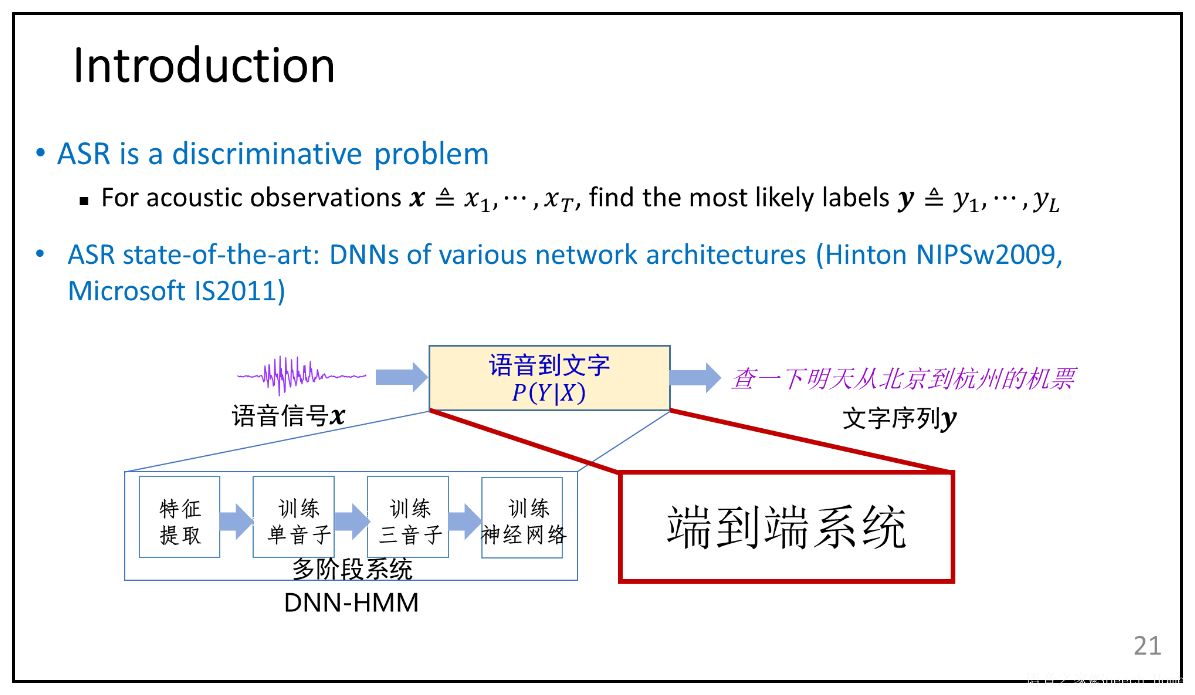
语音识别基本看来是一个鉴别问题,即在给定声学观测序列x条件下,寻找最优可能的标签序列y。目前前沿水平(state-of-the-art)的识别系统基本都是使用了各种网络架构的深度神经网络(DNN)。
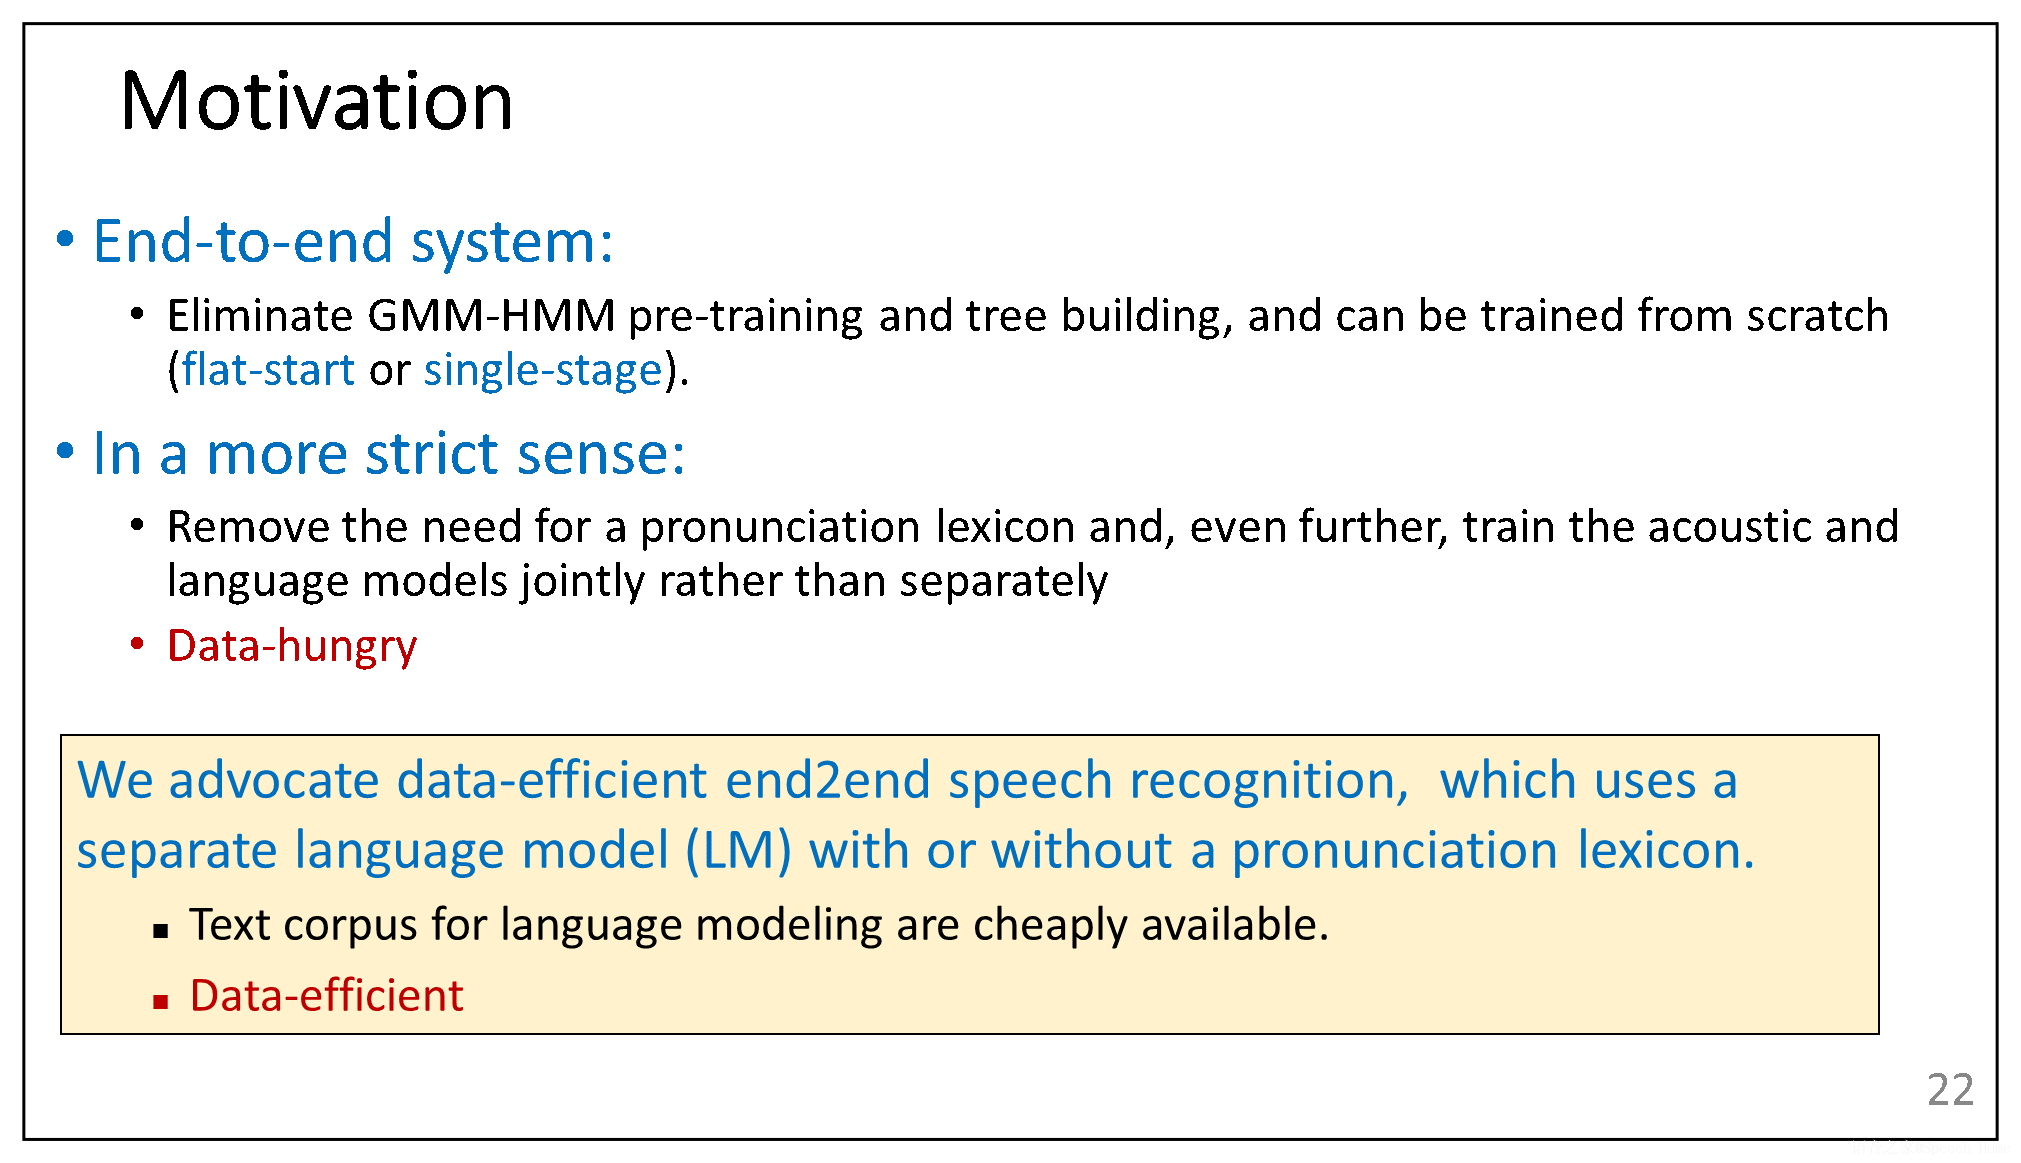
近年来发展的端到端语音识别,希望去除需要额外训练GMM-HMM的步骤和基于决策树构建上下文音子的步骤,能够做到平启动(flat-start)单阶段。在更激进的方案中,研究者希望去除发音词典,更进一步,将声学模型与语言模型联合训练而不是分开训练,但这样的系统往往更加数据饥饿(data-hungry),需要更多的标注数据来训练。我们希望发展数据高效端到端语音识别,首先,使用分立的LM(语言模型),这样可以在大量已获取的文本数据上进行语言模型训练,也方便在跨领域实现LM即插即用;其次,可以使用发音词典,在不具备发音词典时候也可以不使用发音词典。综上,这样的系统将更加数据高效(data-efficient)。
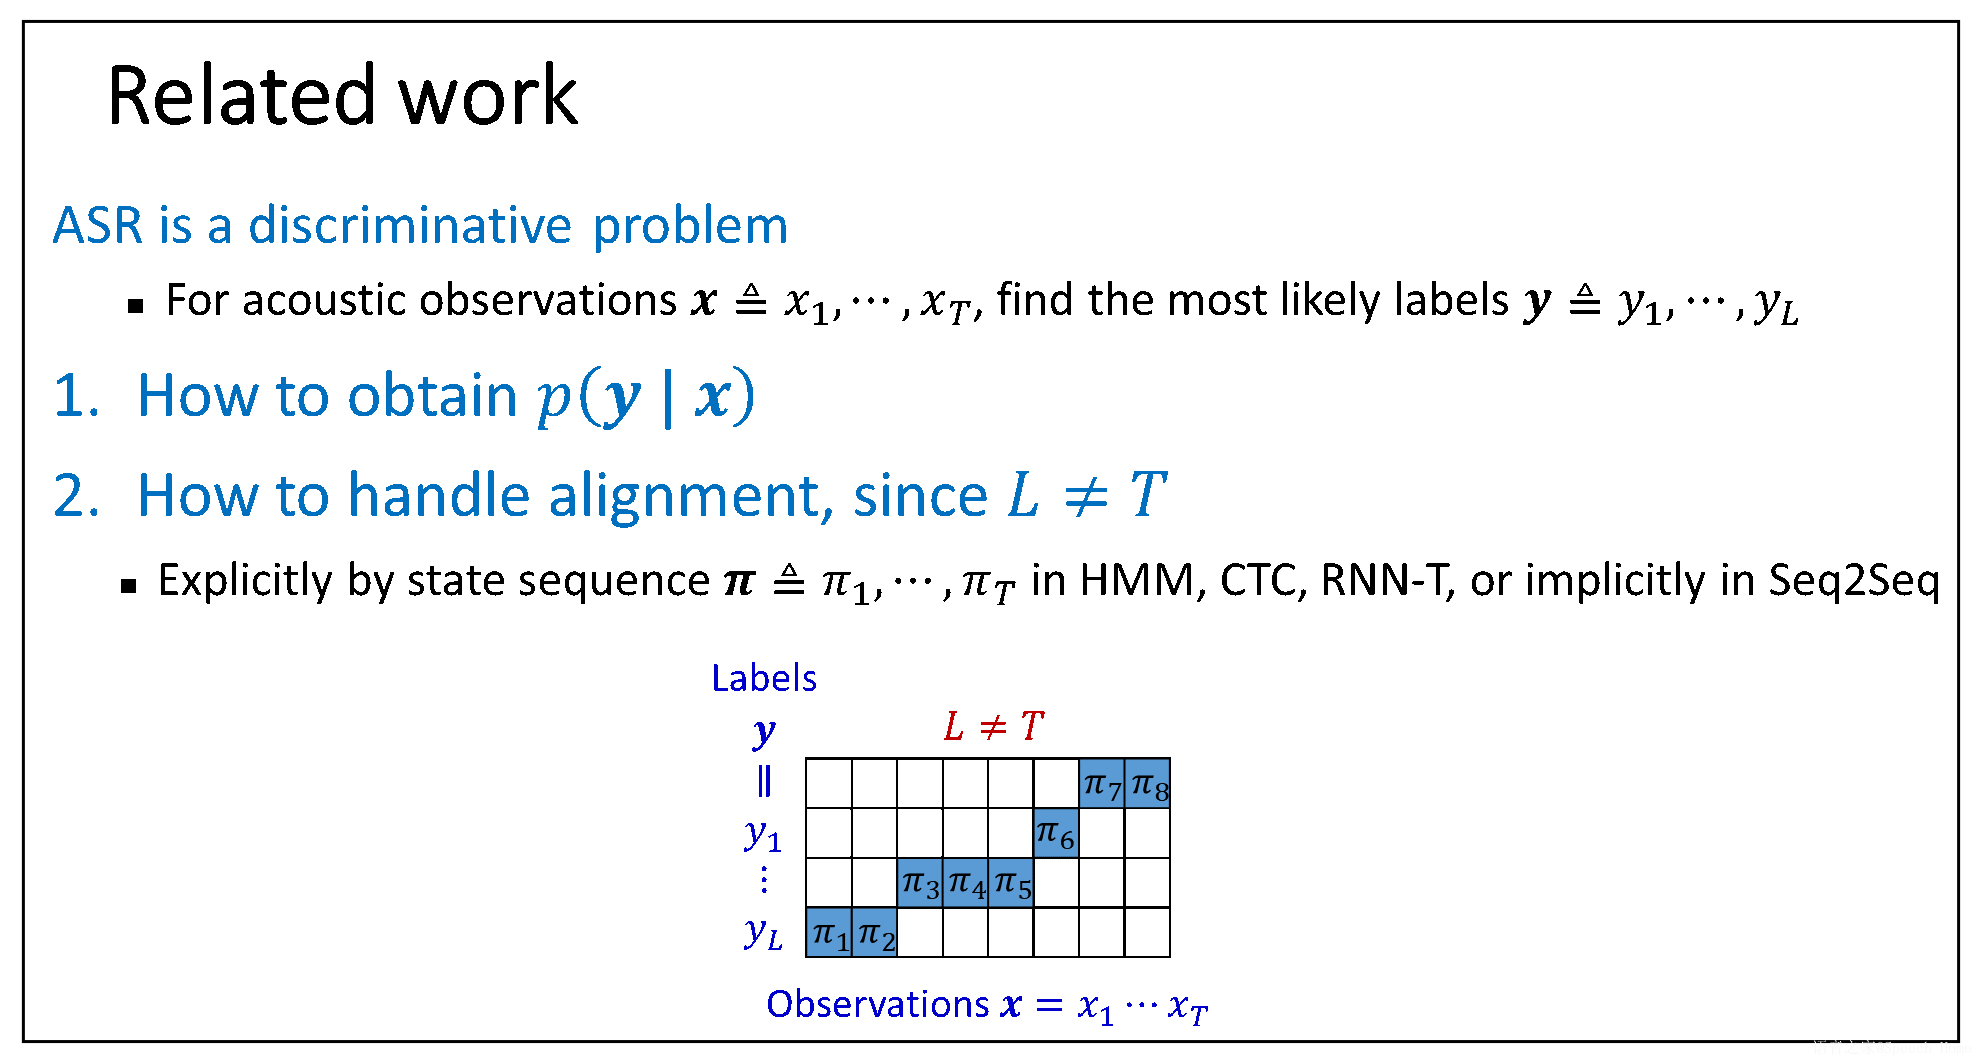
在端到端语音识别的模型架构中,有两个基本问题。一个是如何去表示后验概率p(y|x)(即给定声学观测序列x,标签序列y的后验概率);一个是,如何处理x与y的对齐,因为语音长度与标注符号长度一般不等。
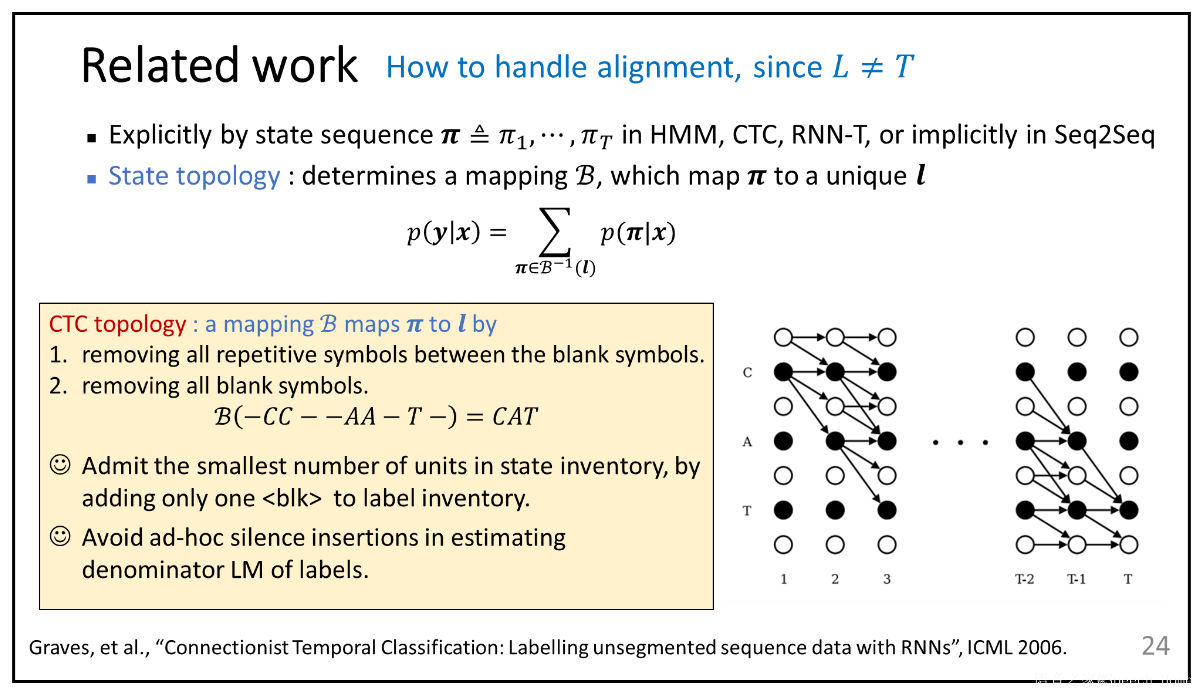
对于第二个基本问题,存在两种做法,一个是象在Seq2Seq模型中使用隐式对齐,另一个是象在HMM、CTC、RNN-T中那样使用显式对齐。在显式对齐方案中,通常会引入一个状态序列π,通过π的后验来计算y的后验。注意到,状态序列π的状态转移矩阵描述了状态拓扑,状态拓扑本质上定义了状态序列π到标签序列y的一个映射,CTC其实定义了一个特殊的状态拓扑。CTC拓扑具有许多良好的性质,例如,在保证从状态序列π能恢复唯一标签序列y的所有映射中,CTC拓扑具有最小的状态单元数(从而计算量最小);CTC译码通常出现尖峰,从而更利于快速译码。
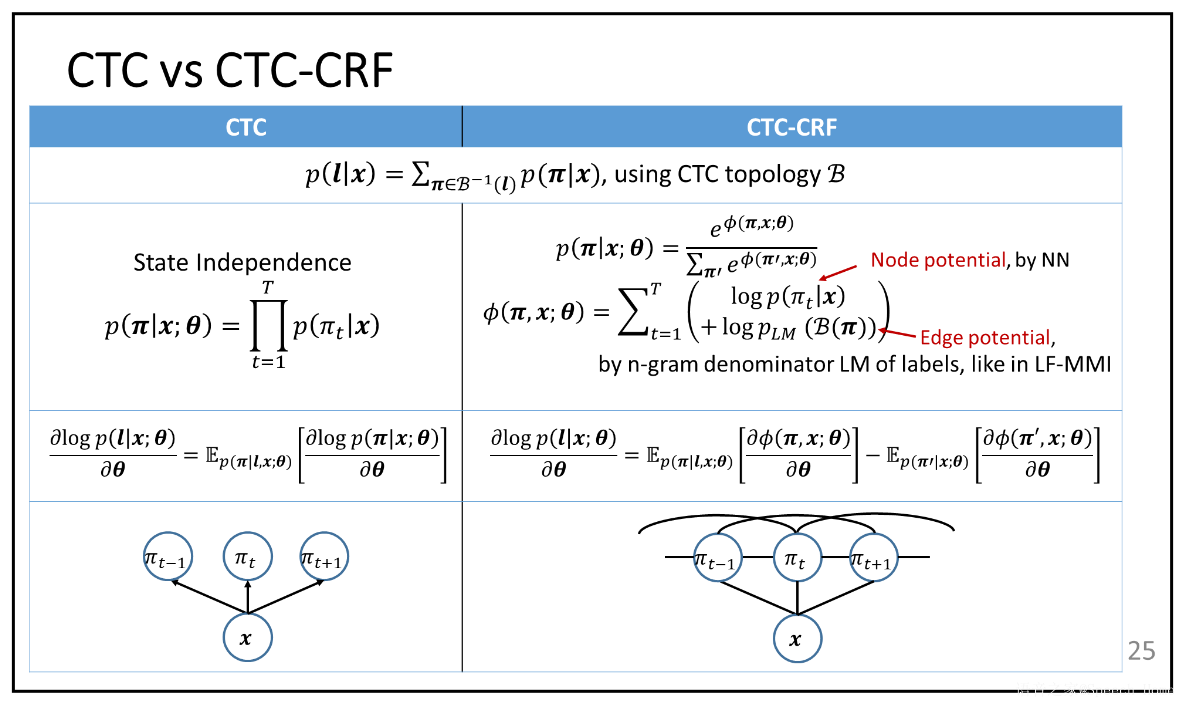
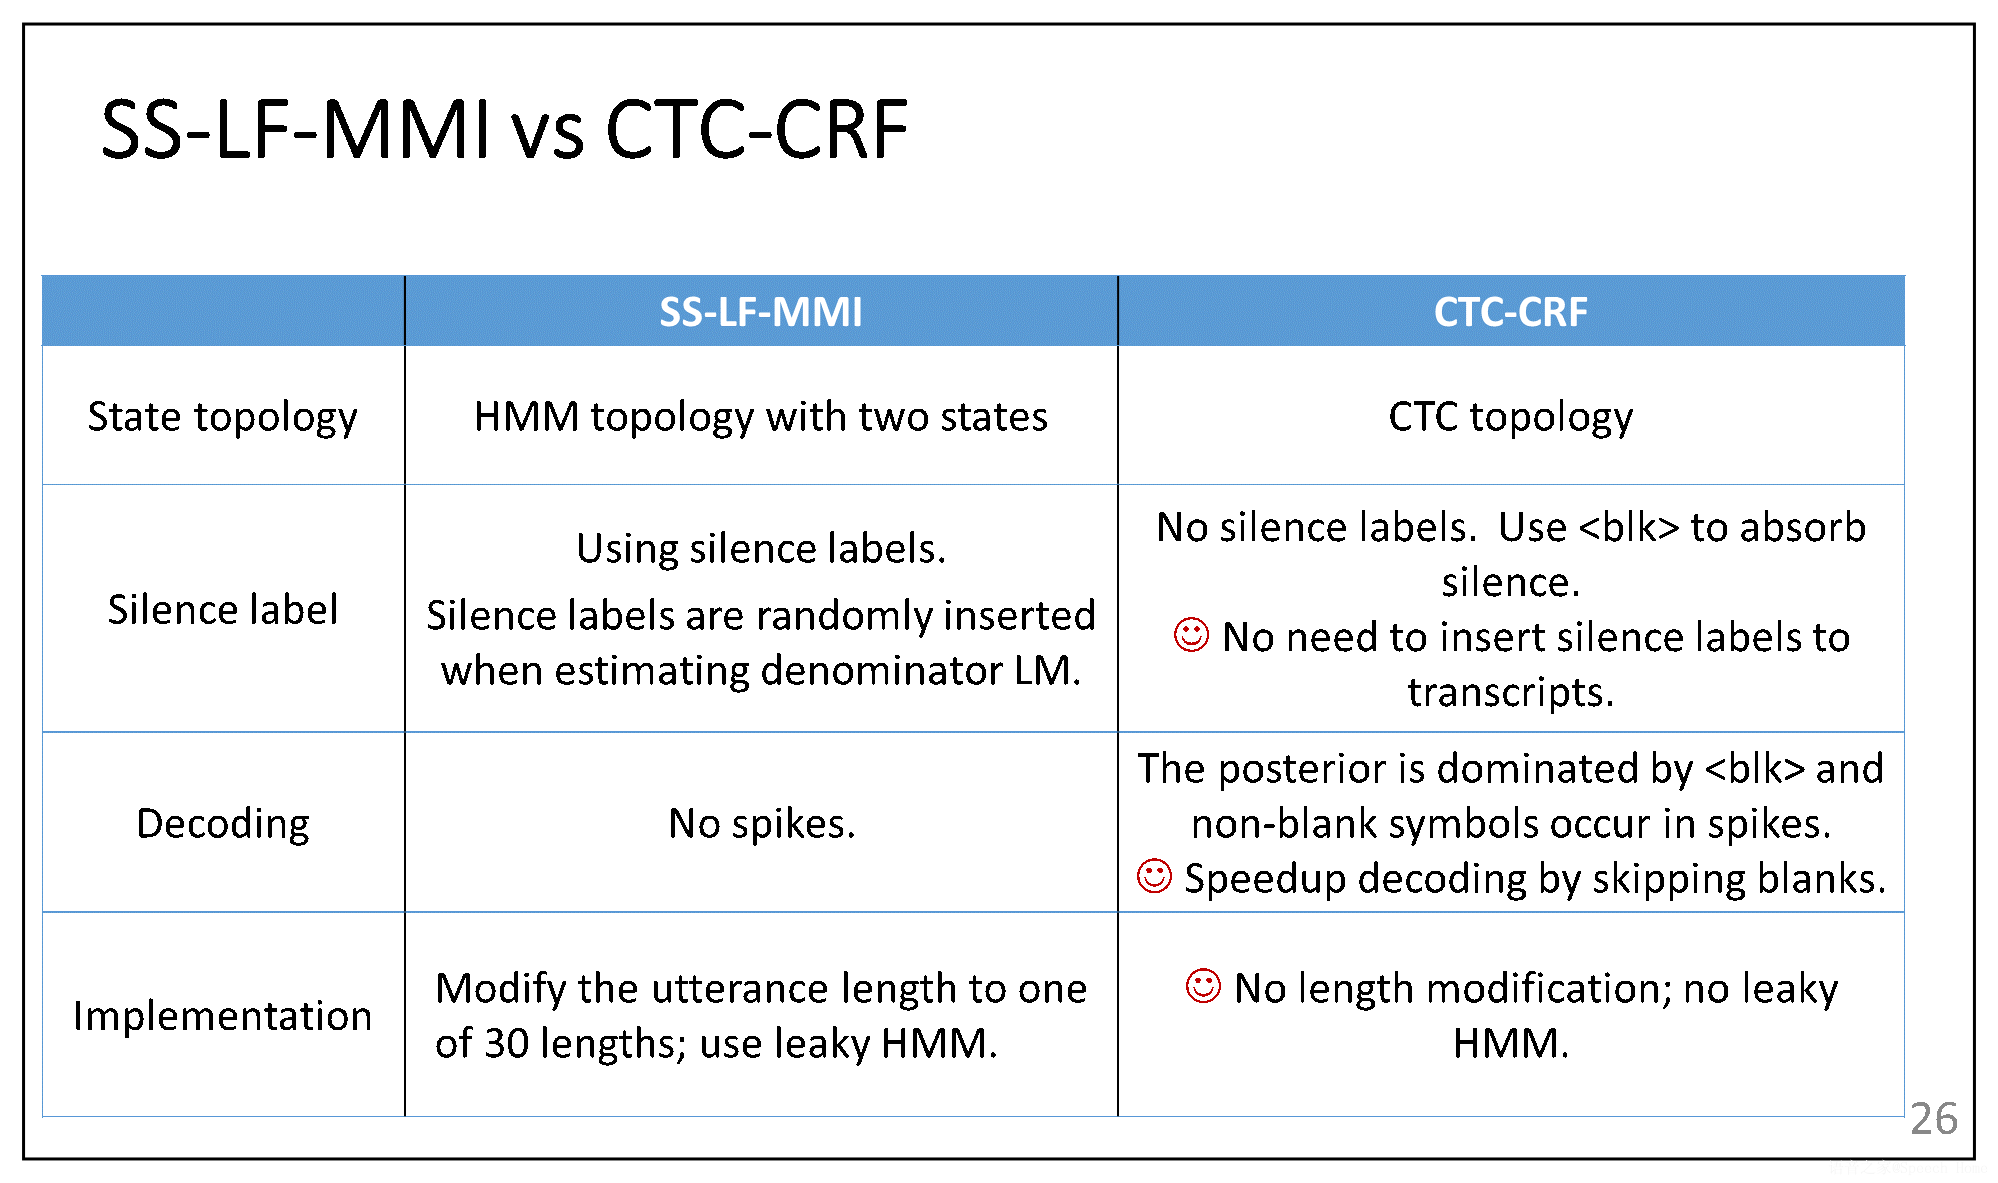
我们提出用CTC的状态拓扑来定义一个条件随机场(CRF)表示π的后验,这样得到的新模型称为CTC-CRF。条件随机场的节点势函数可以由任意架构的神经网络来计算,边势函数由标注符号的n-gram来计算,这有点类似LF-MMI模型(俗称Kaldi chain模型)中的分母LM。CTC-CRF模型的参数梯度包含两项相减,这也类似Kaldi chain模型。但CTC-CRF与Kaldi chain有诸多不同,就像下面这张幻灯片展示的,我们就不展开讲了。
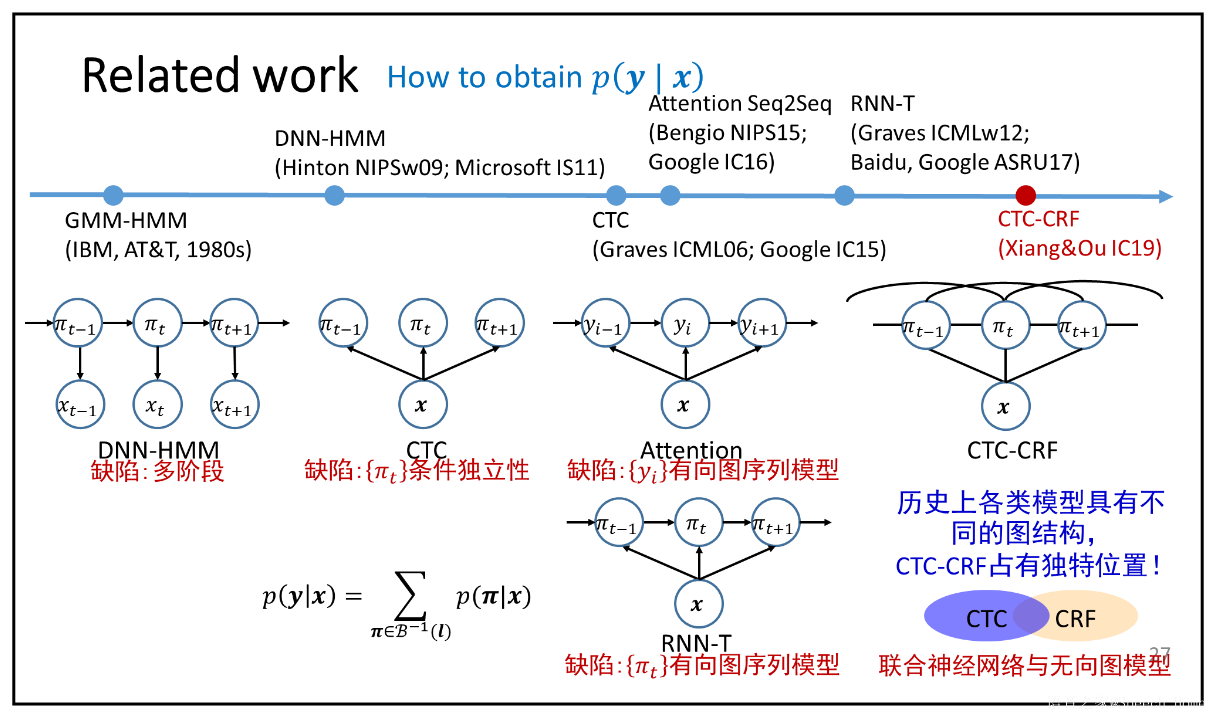
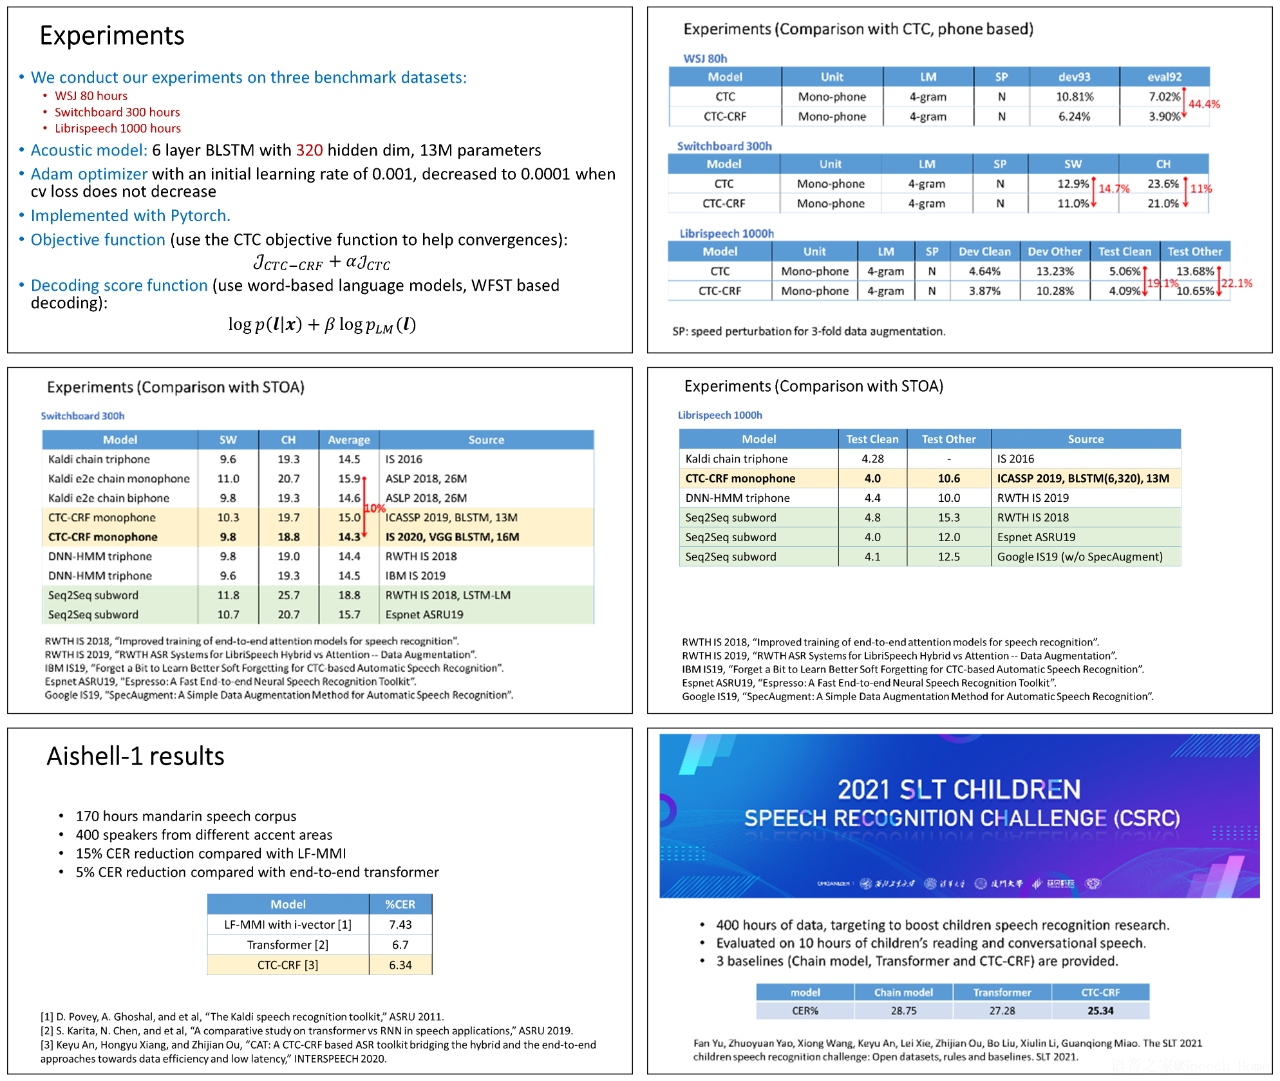
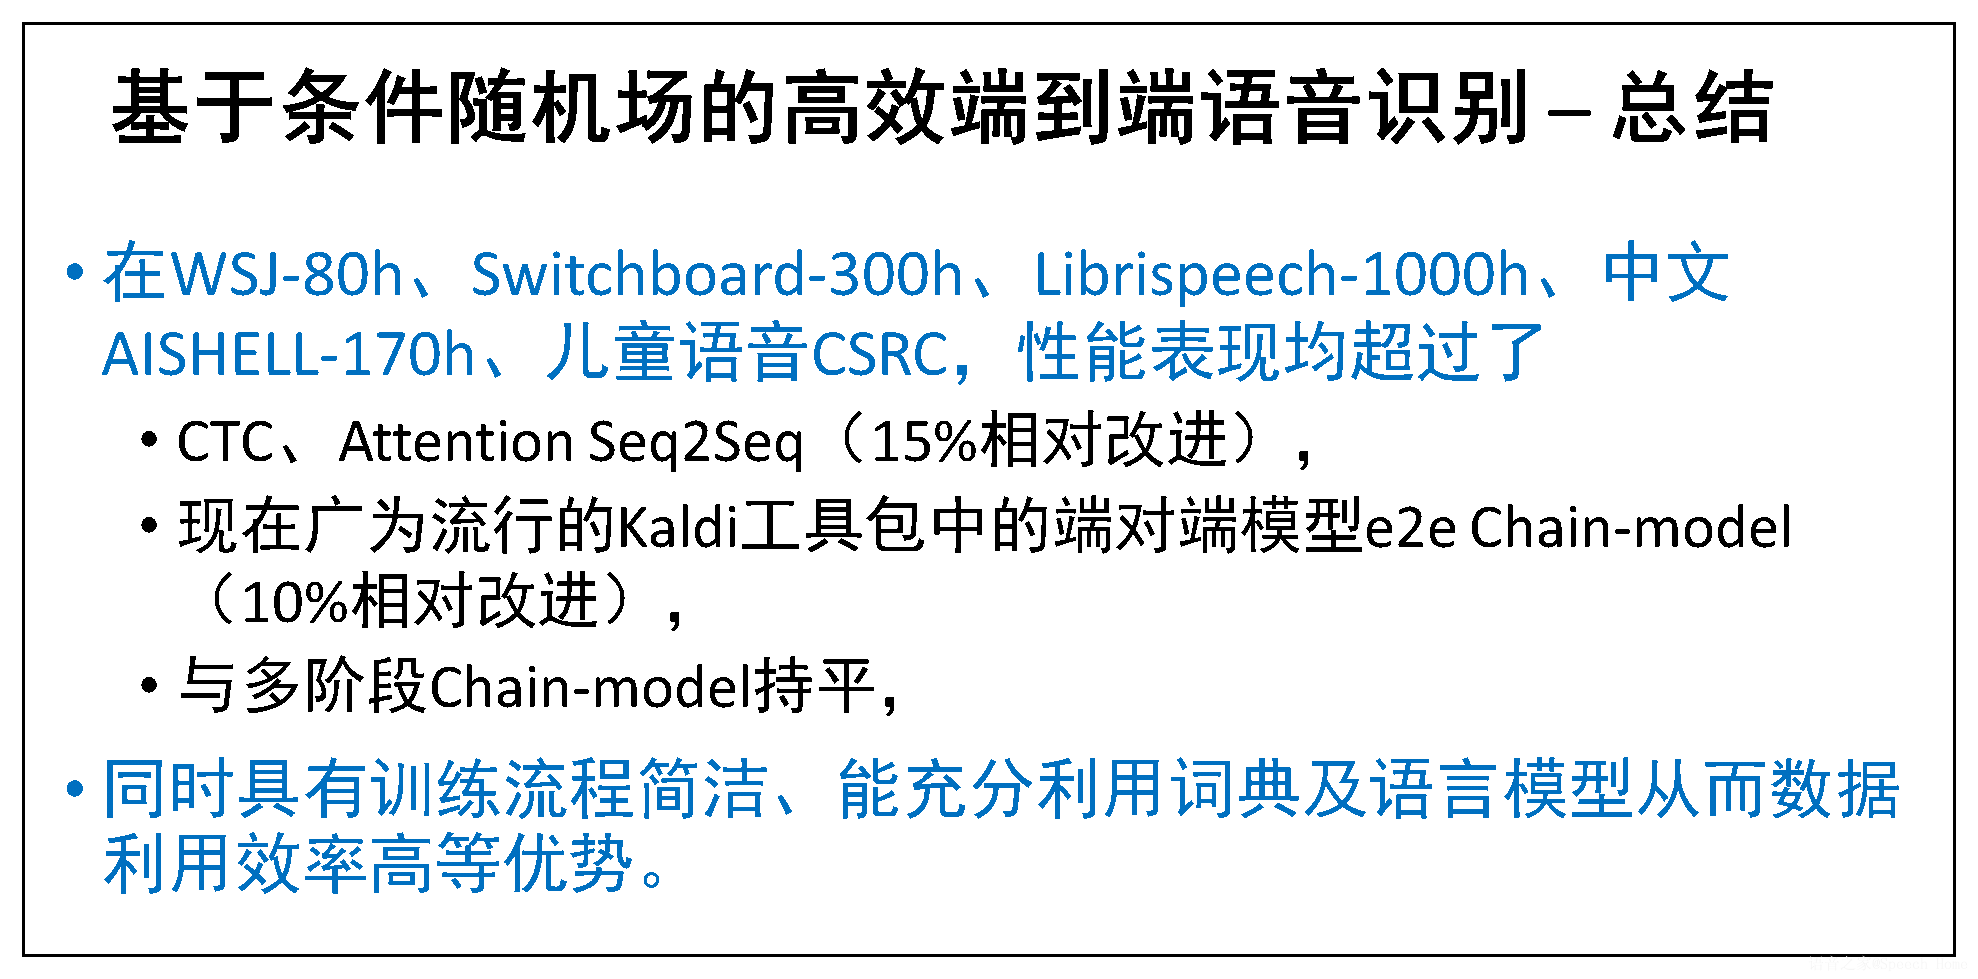
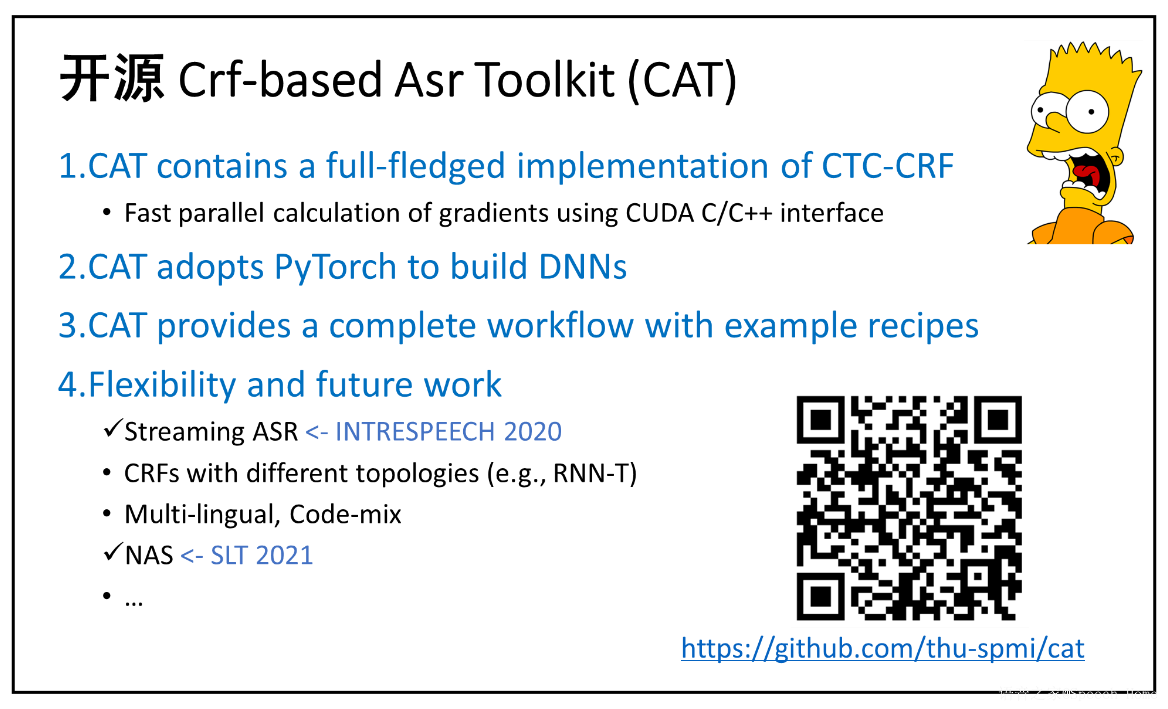
我们来看端到端语音识别模型架构中的第二个基本问题,如何表示后验概率p(y|x)。这里画出了各类模型的概率图模型结构。不难看出,与历史上出现的各类语音识别模型比较,CTC-CRF占有独特位置,第一个成功地联合神经网络与无向图模型用于端到端语音识别,并在原理上克服了历史上各类模型的不足。我们在不同规模的训练数据(80小时WSJ、300小时Switchboard、1000小时Librispeech、170小时中文AISHELL等),不同语种的多项语音识别任务中,展示了CTC-CRF的优越性。CTC-CRF的实现和实验代码已经全部开源,欢迎大家测试和提出建议。
五、TRF
下面介绍“随机场语言模型”,简称TRF,包括介绍该工作的研究动机,相关工作(即该工作在学术上当前研究图景中的位置),工作本身,实验结果以及小结。
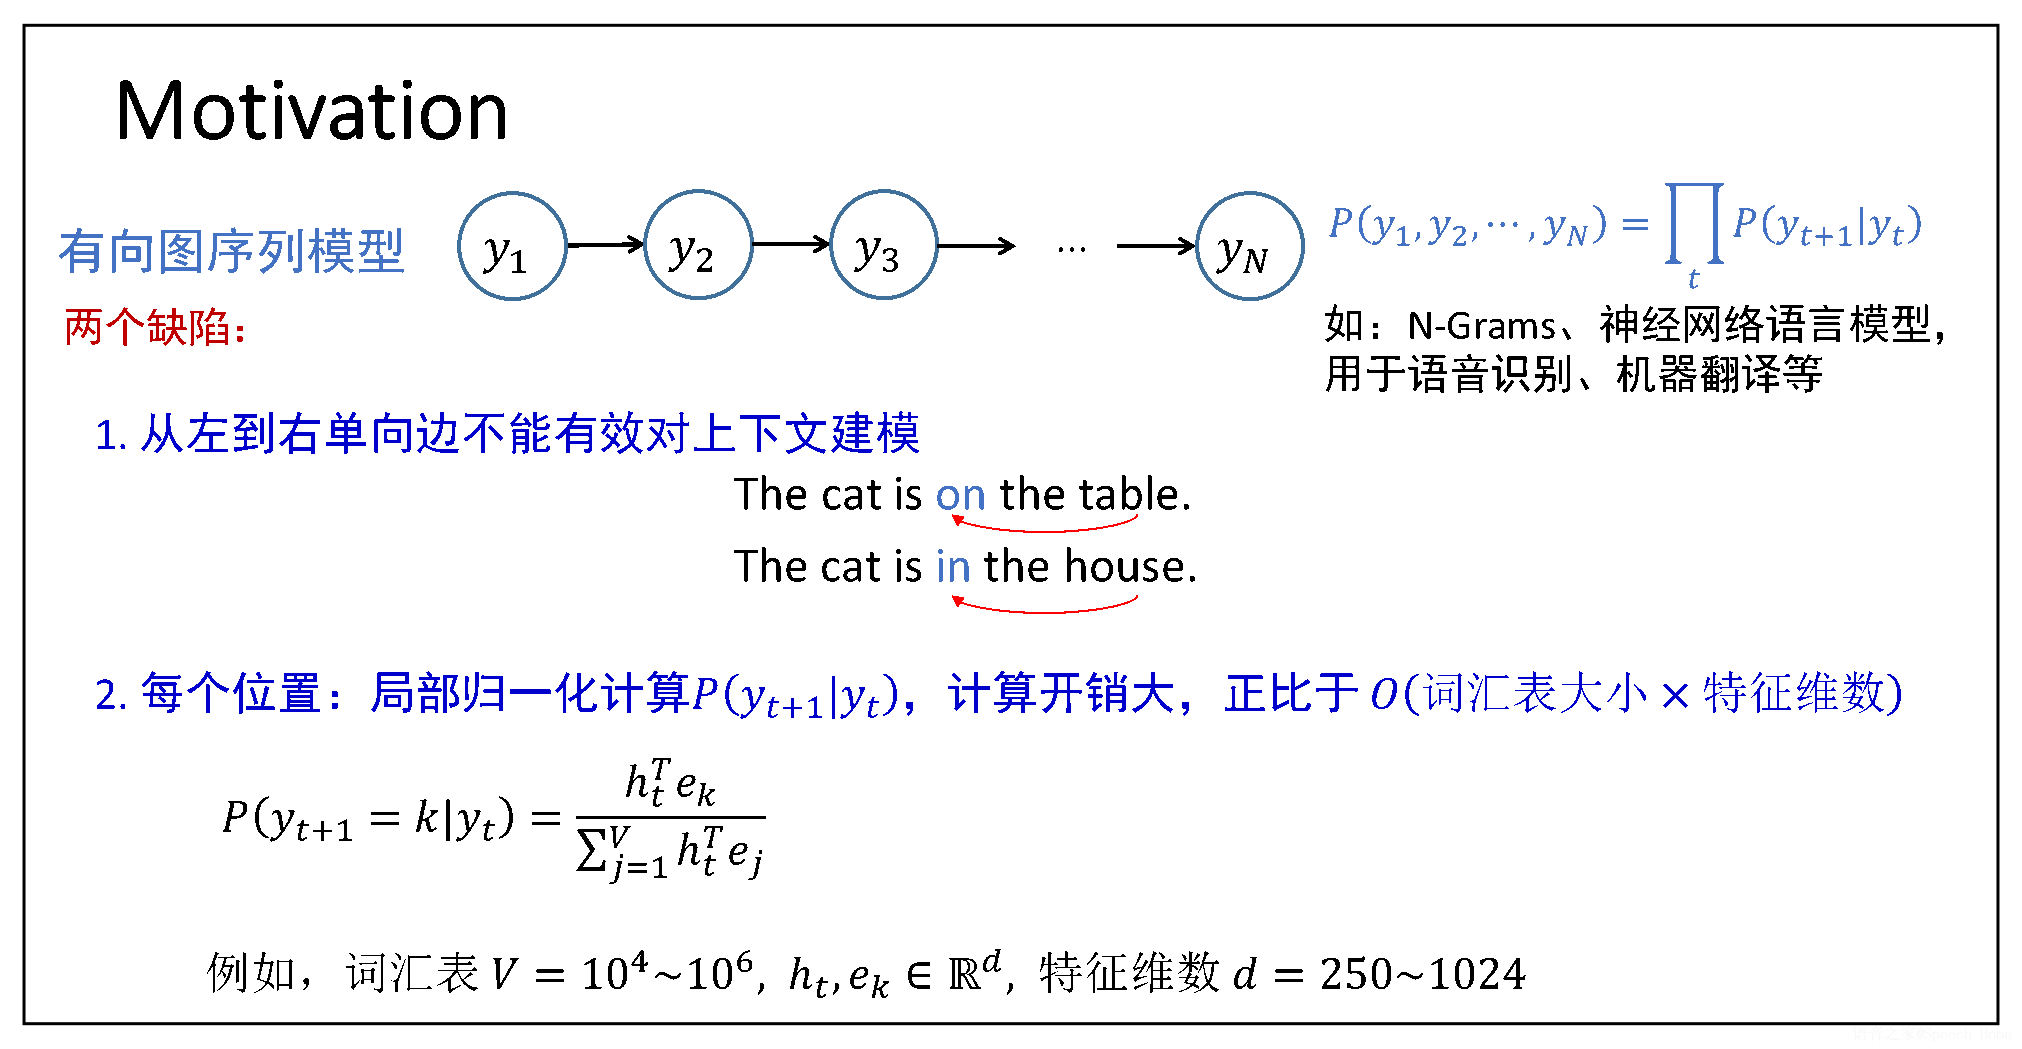
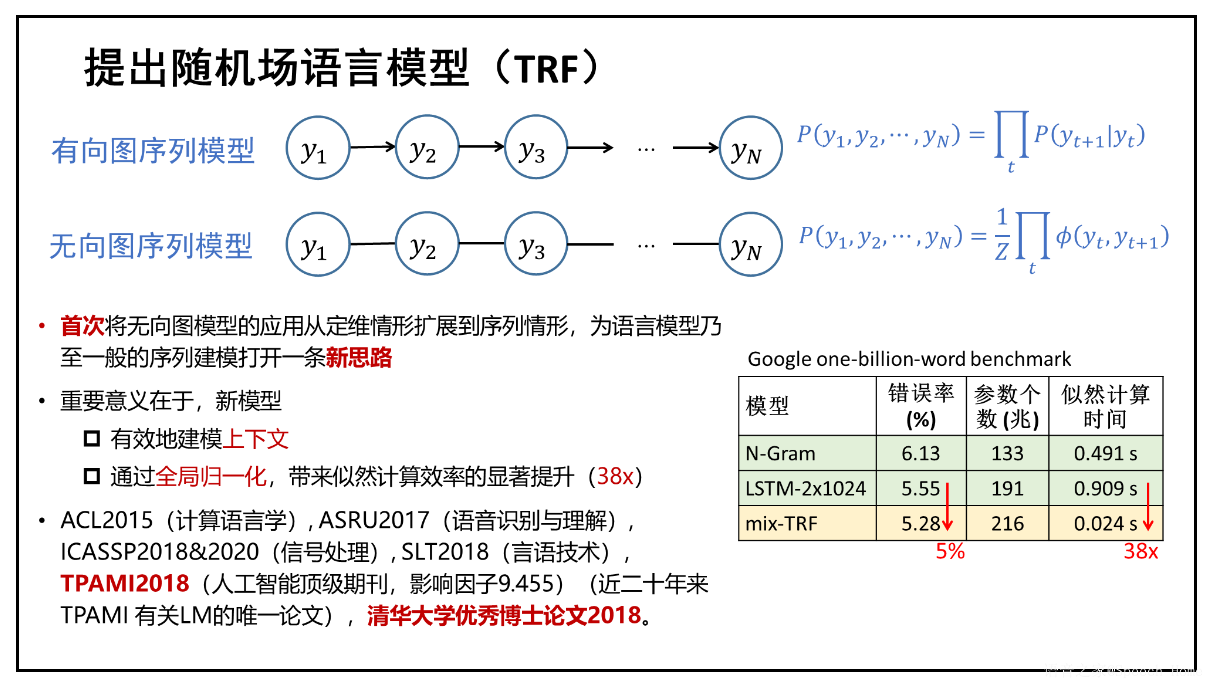
从数据高效出发,我们需要一个分立的语言模型。目前广泛使用的n-gram,神经网络语言模型都是有向图序列模型(或又可称自回归序列模型),联合分布表示成每个位置的条件分布的连乘积。自回归序列模型有两个基本缺陷。第一,自回归模型从左到右的单向边不能有效对语言上下文建模,不论是语言生成,还是语言理解,都不是单纯从左至右。例如,“The cat is on the table”,“The cat is in the house”,这两句话中后面的名词决定了前面的介词。在这一类自回归模型中,自左向右的建模还带来两个深层次的偏置问题——“标签偏置(Label Bias)”和“曝光偏置(Exposure Bias)”,因时间关系就不展开了。第二,自回归模型在每个位置都要局部归一化计算条件概率,不难看出,这样的计算开销是每个位置处正比于词表大小与特征维数的乘积,这是相当大的推理开销。
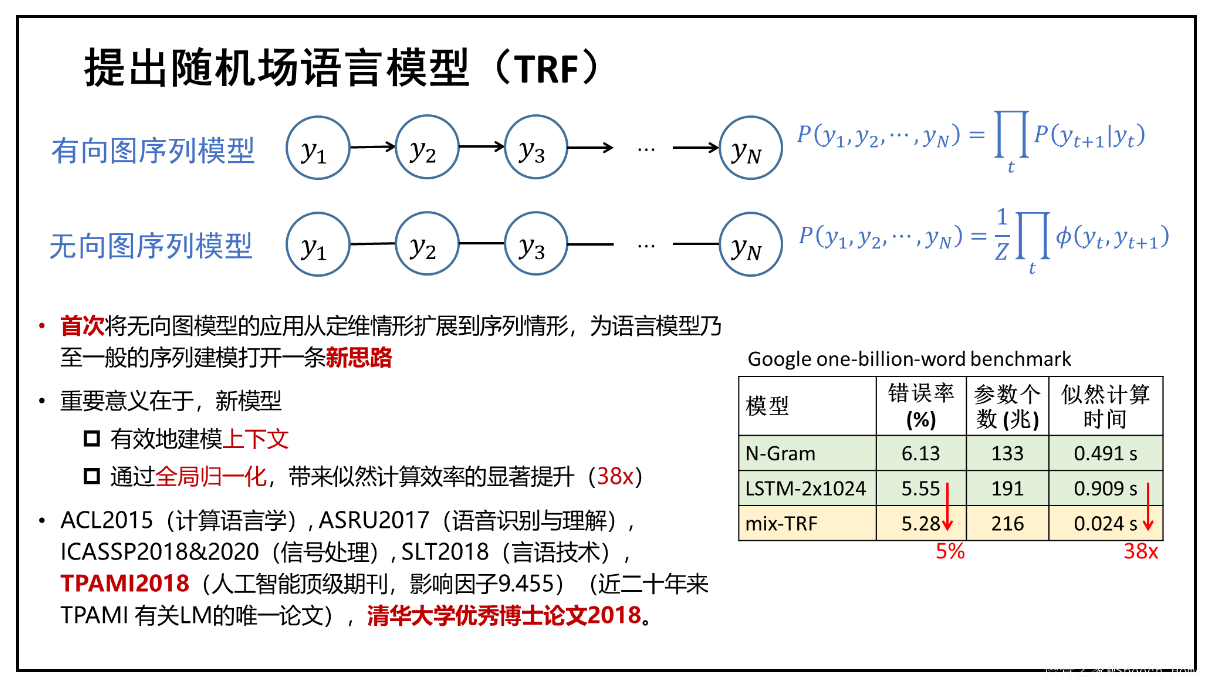
我们提出建立无向图序列模型(跨维随机场模型),联合分布表示成非负势函数连乘积,势函数不要求归一化,只需一个全局归一化。历史上,几乎没有使用无向图序列模型,很多程度上是因为存在模型拟合上的难度。我们发展了新的学习算法,首次将无向图模型的应用从定维情形扩展到序列情形,为语言模型乃至一般的序列建模打开一条新思路。重要意义在于,新模型能有效地建模上下文,上下文就是互相影响,无向边相当于双向边;另外, 通过全局归一化,可带来高达38倍的似然计算效率的显著提升。我们发表了系列文章,包括人工智能顶级期刊TPAMI,有意思的是,我们有关跨维随机场语言模型是近二十年来TPAMI 有关LM的唯一论文,后面我们可以看到LM研究中有趣的故事。
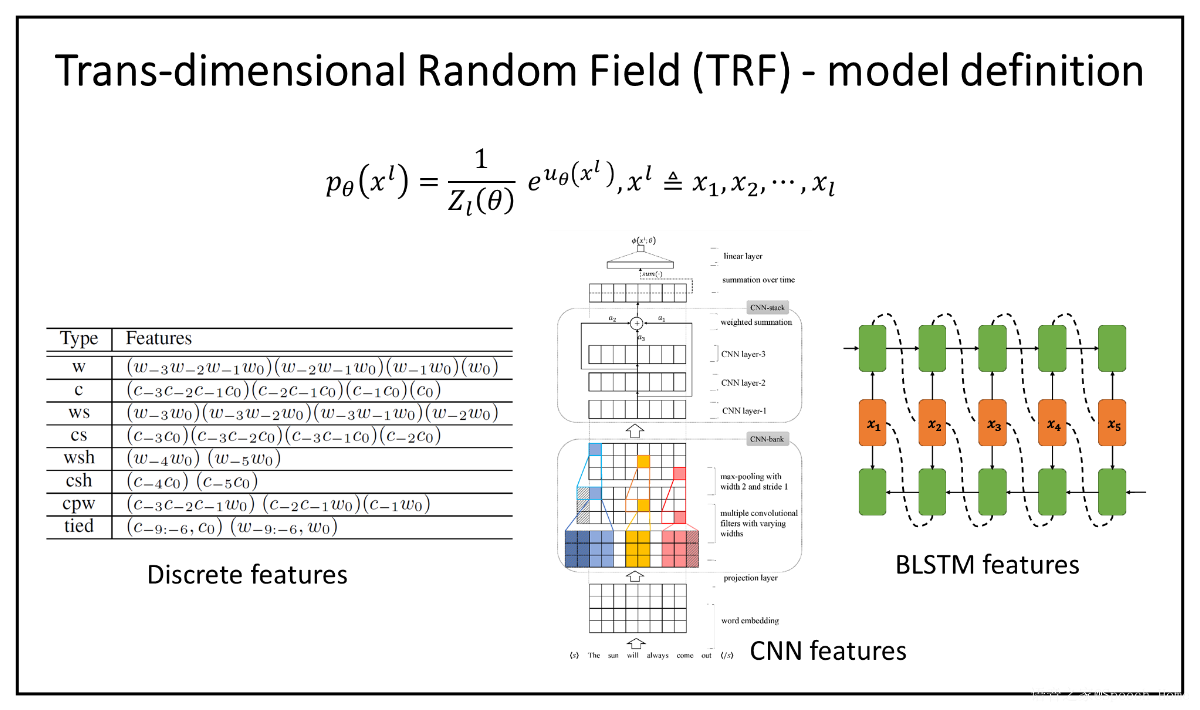
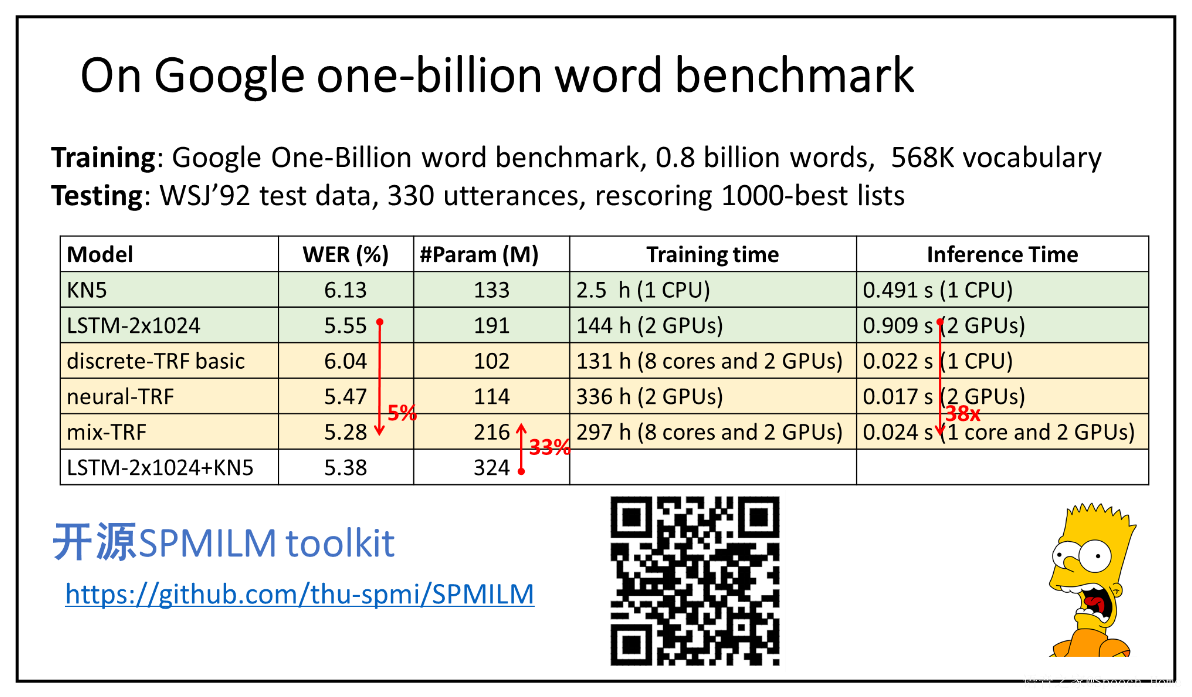
我们可以非常灵活地定义随机场语言模型的势函数,可以使用离散特征(如n-gram特征,甚至更灵活的语言学特征),也可以使用不同神经网络架构的连续特征。我们最近提出的混合特征随机场语言模型(mix-TRF),为语言模型中融合符号逻辑和神经计算的做了有益探索。近年来,我们探索和设计了随机场语言模型训练的多种不同训练算法,使得我们可以成功训练随机场语言模型,并且在多个数据集上展示了随机场语言模型的优越性。TRF的实现和实验代码已经全部开源,欢迎大家测试和提出建议。
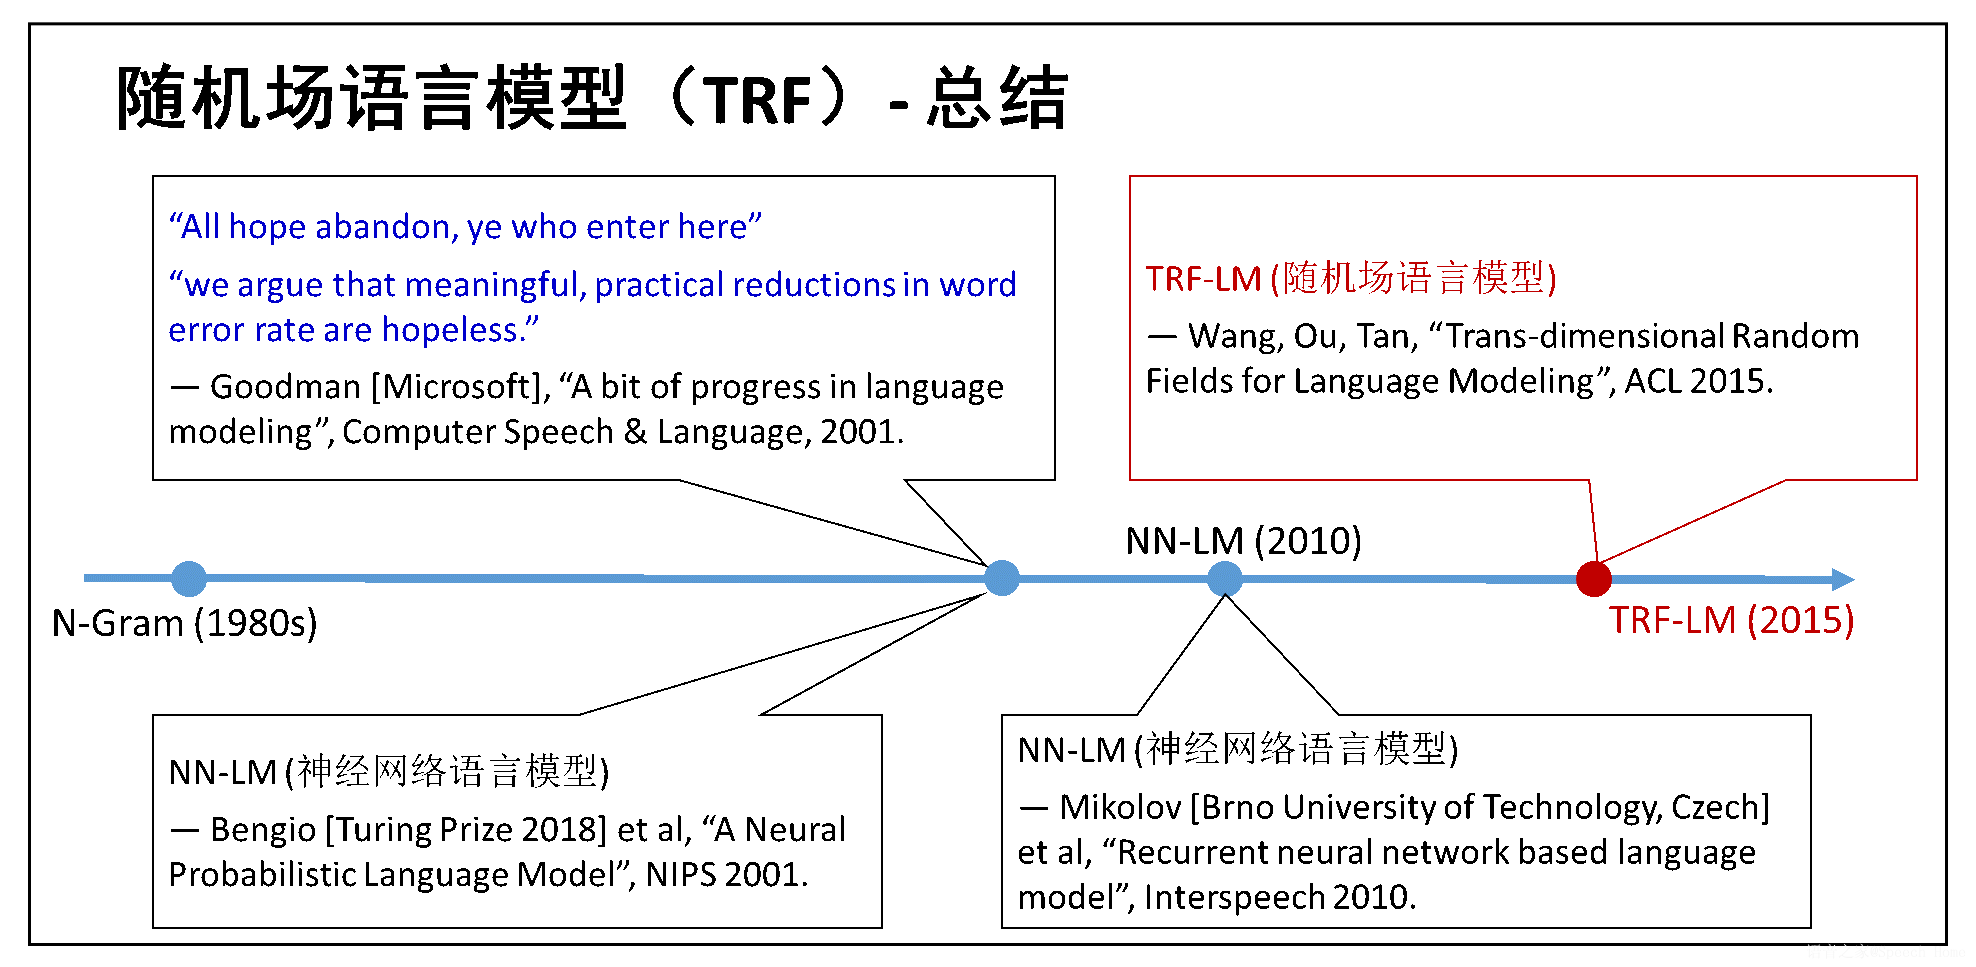
在一段很长的时间里面,长达30年,研究者发现很难超越朴素的n-gram,有些沮丧,微软研究员Goodman在2001年发文感慨,“All hope abandon, ye who enter here”(所有的希望都放弃了,谁还会进入这里),“we argue that meaningful, practical reductions in word error rate are hopeless.”(我们认为有意义的,实际地(比n-gram)更能降低词错误率是没有希望的)。n-gram语言模型具有统治地位,直到2011年神经语言模型实践成功。其实Bengio在2001年提出了神经网络语言模型,但较少被关注,直到Mikolov(捷克大学的博士生)实践成功。我们的随机场语言模型,在某些方面进一步超过了神经网络语言模型,并且两者都真正意义上超越了n-gram。
六、ST-NAS
下面介绍“基于直通梯度的神经网络架构搜索”,简称TRF,包括介绍该工作的研究动机,相关工作(即该工作在学术上当前研究图景中的位置),工作本身,实验结果以及小结。
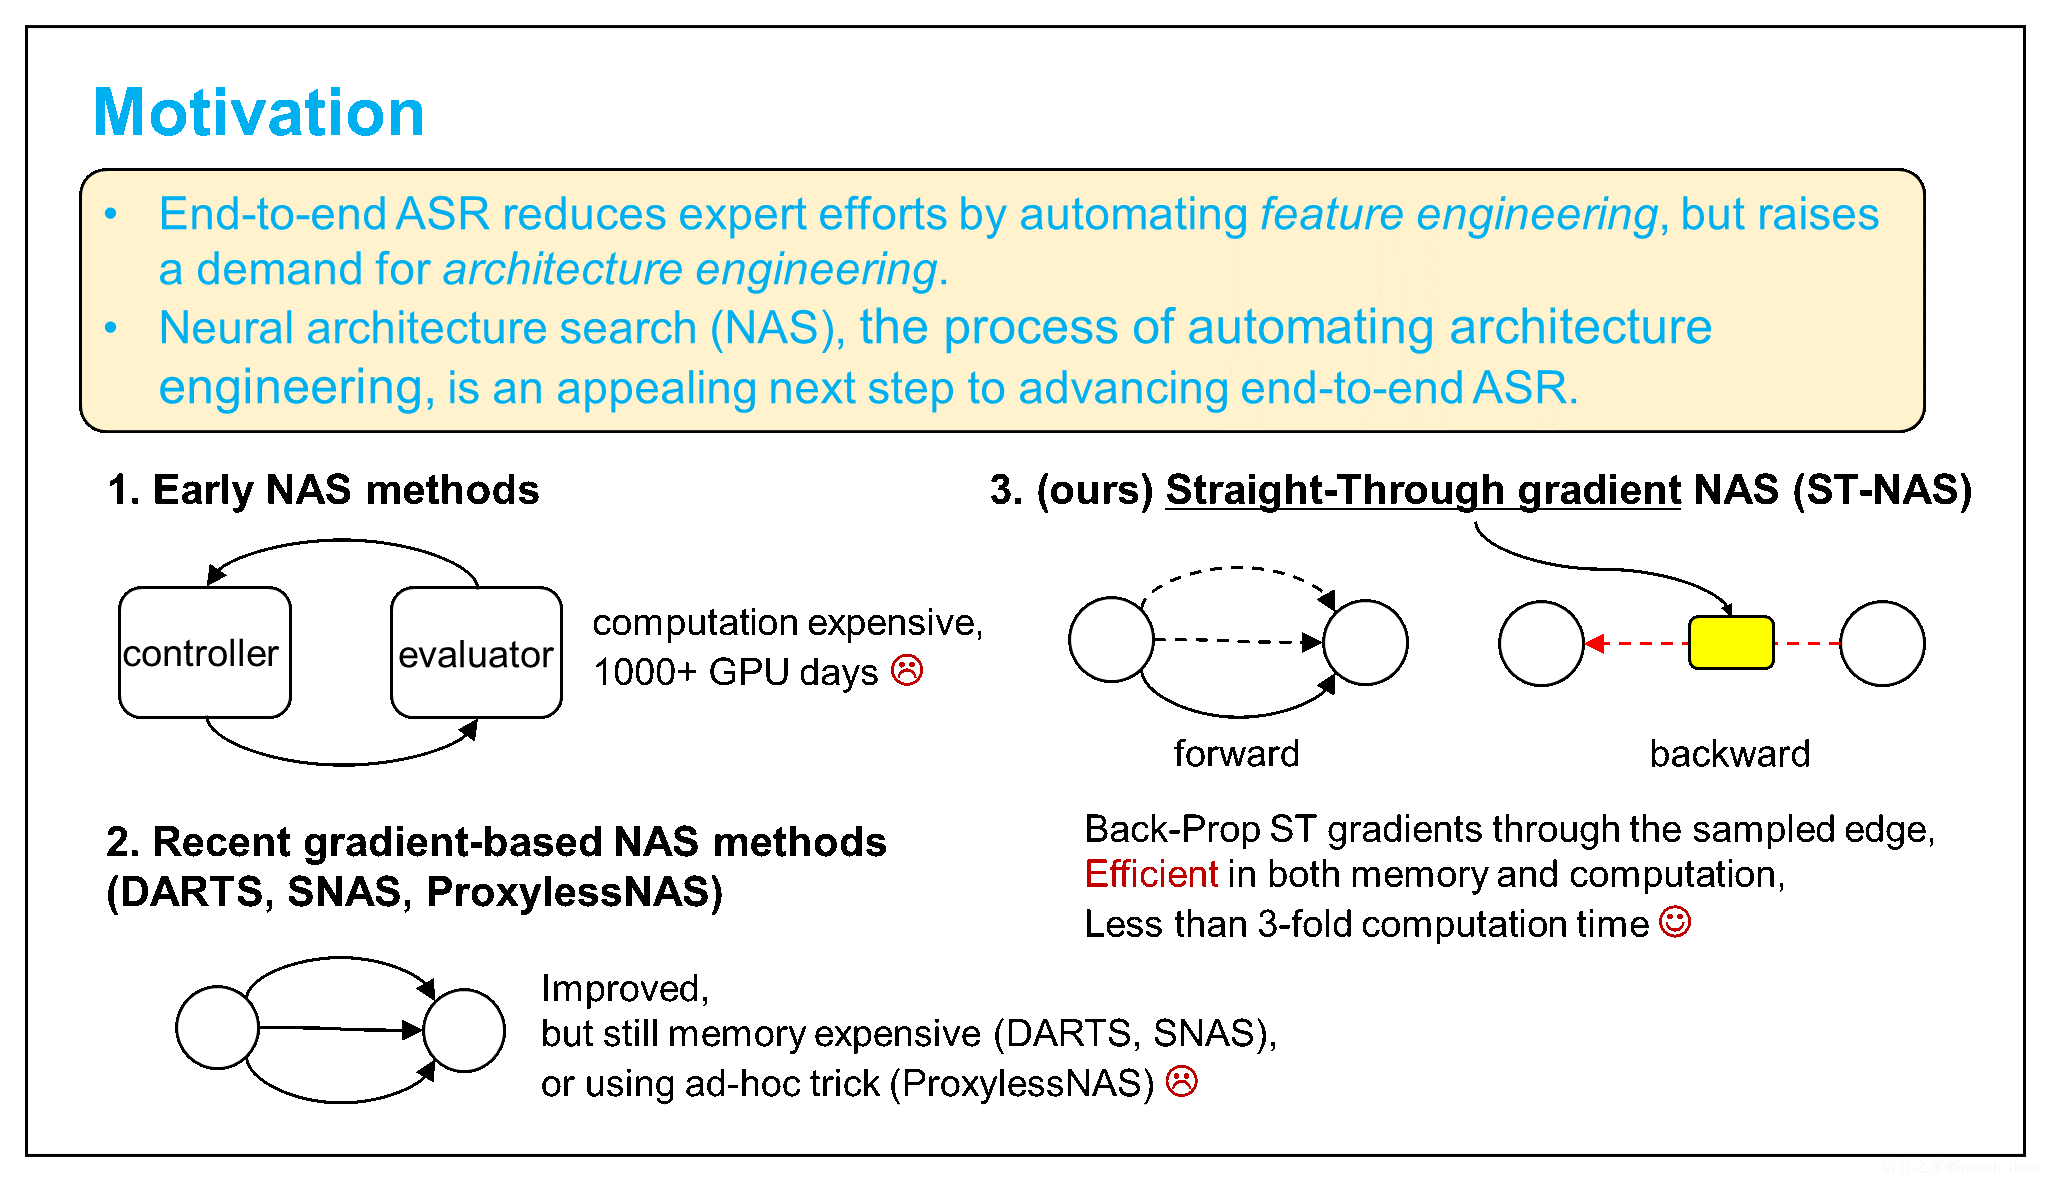
有人说,第二代语音识别技术的成功是将特征工程(feature engineering)自动化了,不是人拍脑袋设计特征。这时,神经网络架构成为制约模型性能的关键因素。我们刚从“特征工程”跳出来,又陷入了要做“架构工程”(architecture engineering)。新神经网络架构应接不暇,实验起来非常费时费力。作为AutoML的一个重要内容,神经网络架构搜索(NAS)就是希望将架构工程自动化,这是推动语音识别发展的非常诱人的下一步。早期的NAS方法计算非常昂贵,需要1000 GPU days。最近一些基于梯度的NAS方法,显著改善了NAS的计算复杂度,但仍然内存开销很大,方法缺乏理论。我们提出基于直通梯度的神经架构搜索(ST-NAS),计算和内存开销都得到改善,总的来说,ST-NAS可以用低于标准训练3倍复杂度的代价,完成神经架构搜索。
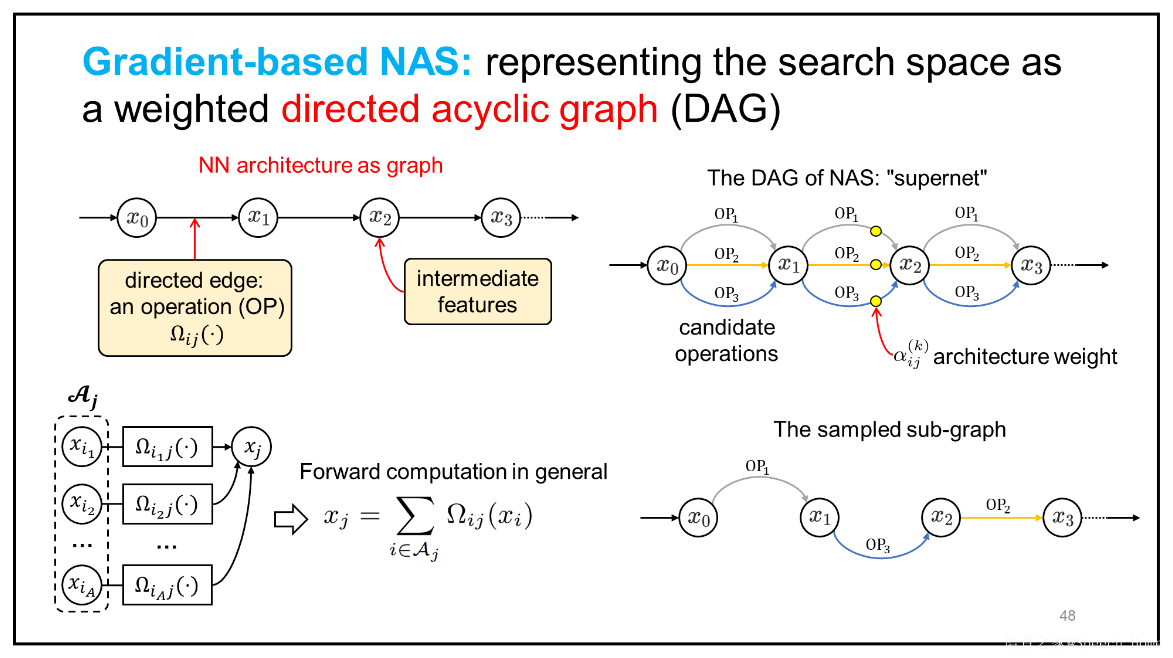
大家知道,神经网络的计算可以表示成一个“计算图”(computation graph)。假设我们把不同的候选算子作为有向边加到两个相邻节点间,边上带权重,这样得到的图称为超图(supernet)。对超图依照边上权重进行一个采样,就得到一个候选架构。这样,NAS就转化为:从数据中学习边的权重。 表示相邻的节点i,j之间第k个候选算子的权重。训练结束后,对相邻节点,只留住最大权重的候选运算,作为架构搜索的结果。为了简单起见,左上图画的是一个串行架构,左下图显示了一般的前向计算,一个节点可以有多个父节点。
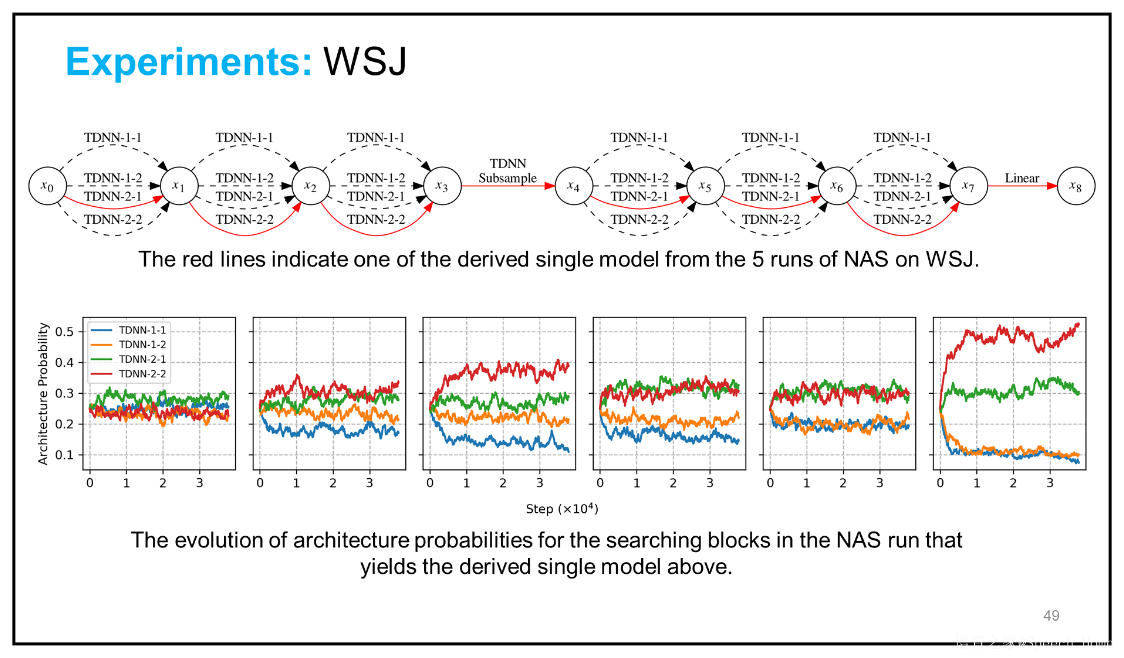
这里给大家展示了我们的一个实际实验的例子。考虑一个6层的TDNN神经网络,每层可以用具有不同卷积宽度和空隙的TDNN算子,这里假设每层有4个候选算子。下图展示了在NAS训练过程中,6层的4个候选算子的权重演化的过程。最后,每层具有最大权重的算子将被挑选出来,作为架构搜索的结果。
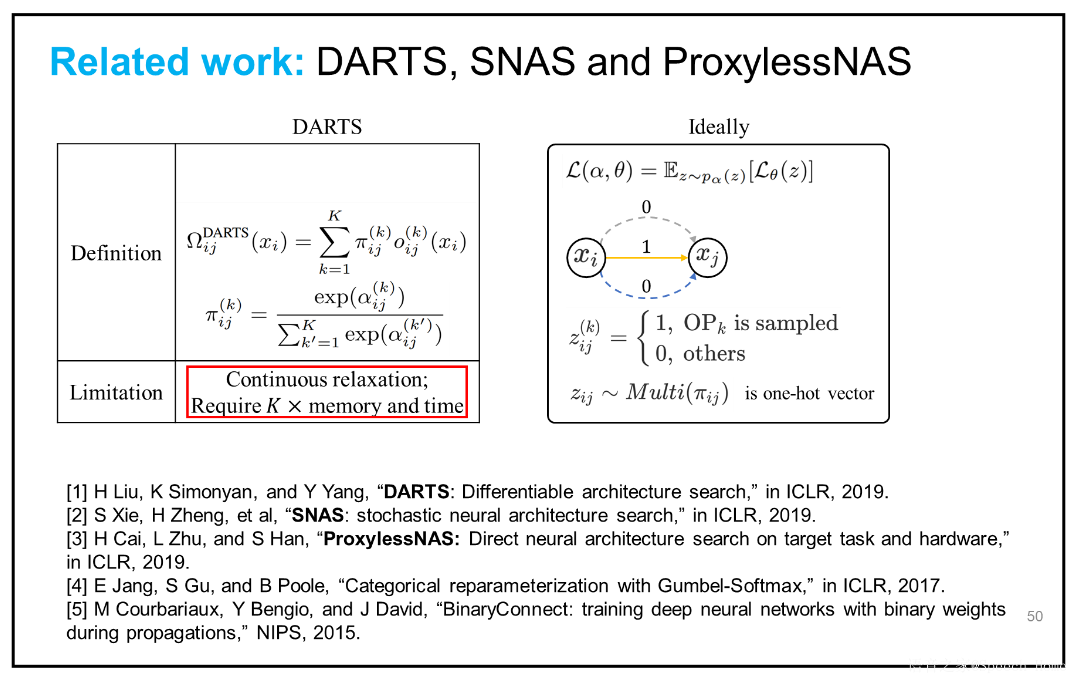
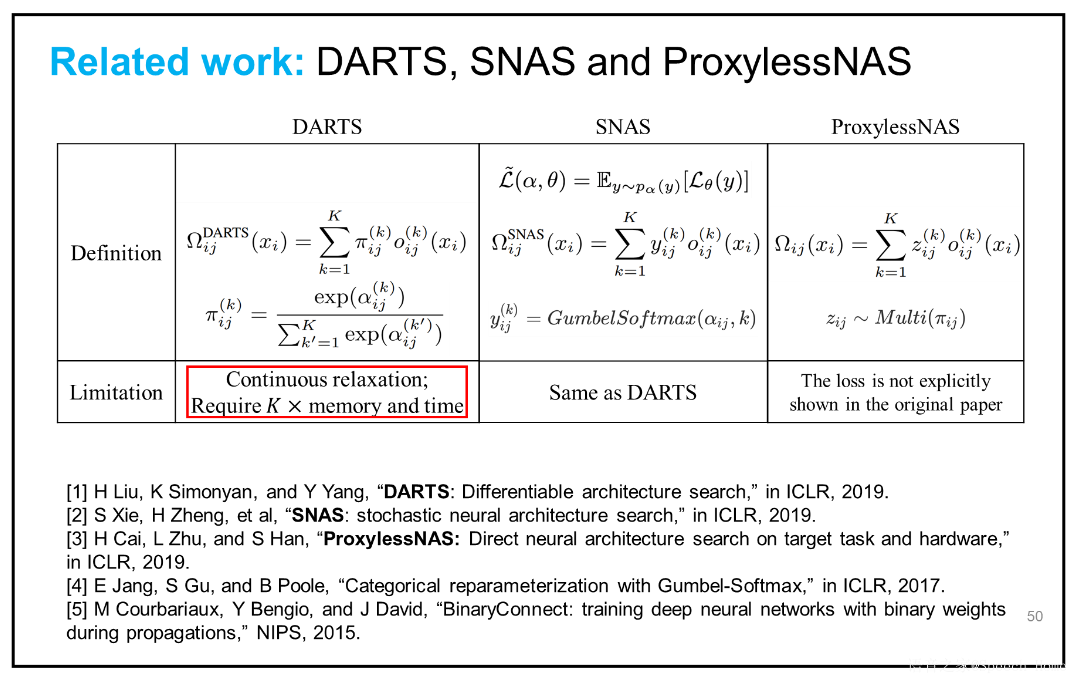
我们对超图依照边上权重α进行一个采样,得到一个候选架构。对依据α采样出来的候选架构的评价(即损失函数,loss)的期望,可作为权重α的评价(loss)。考虑我们最终只是挑选一个候选架构用于推理测试,使用这样的期望作为评价比较合理。假设z表示采样的各边的编号,z是一个矢量,z_ij表示相邻的节点i,j之间采样的边的编号,表示为one-hot(独热)矢量。我们希望寻找具有最优评价的α。这样的评价函数涉及对离散变量采样下的期望。对这样形式的评价函数进行优化,不是一个容易的问题。DARTS采用连续松弛,把对依据权重进行相邻节点间K个候选算子的离散采样,表示为一个混合算子,从而将NAS训练转化为一个完全的连续函数的优化,用标准的BP(反向传播)方法就可训练,但计算和内存开销增大K倍。而且,算子权重训练时的评价与训练结束后挑选架构用于推理测试时的评价,两者不十分一致。近期一些方法,如SNAS, ProxylessNAS致力于改善这些问题。
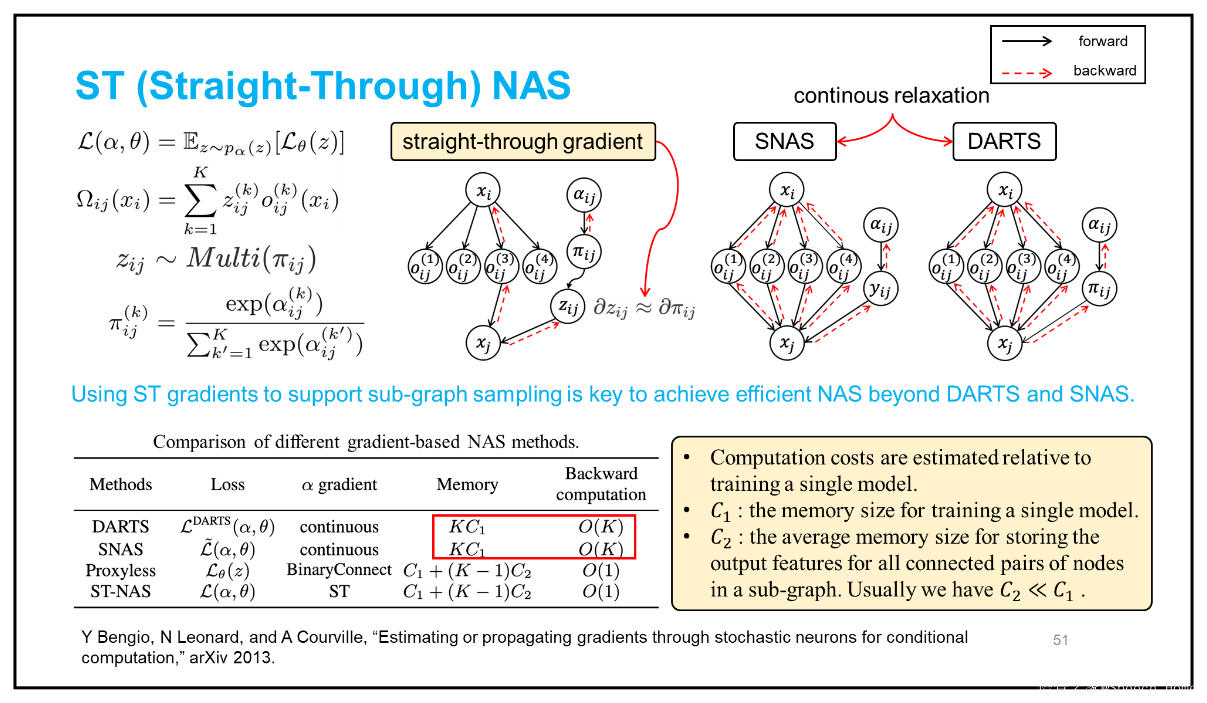
前面提到,对NAS评价函数优化的困难在于,其涉及对离散变量z的采样下的期望。损失函数L是通过z来依赖于权重α。一个问题是,梯度如何能有效透过z到达α。直通梯度的做法就是,使用采样的z进行前向计算,在梯度反向传播时,假设∂z_ij≈∂π_ij,π_ij为依据候选算子权重α计算出来的候选算子选中概率。这样的做法以较低的计算和内存开销,较好地完成了NAS训练。
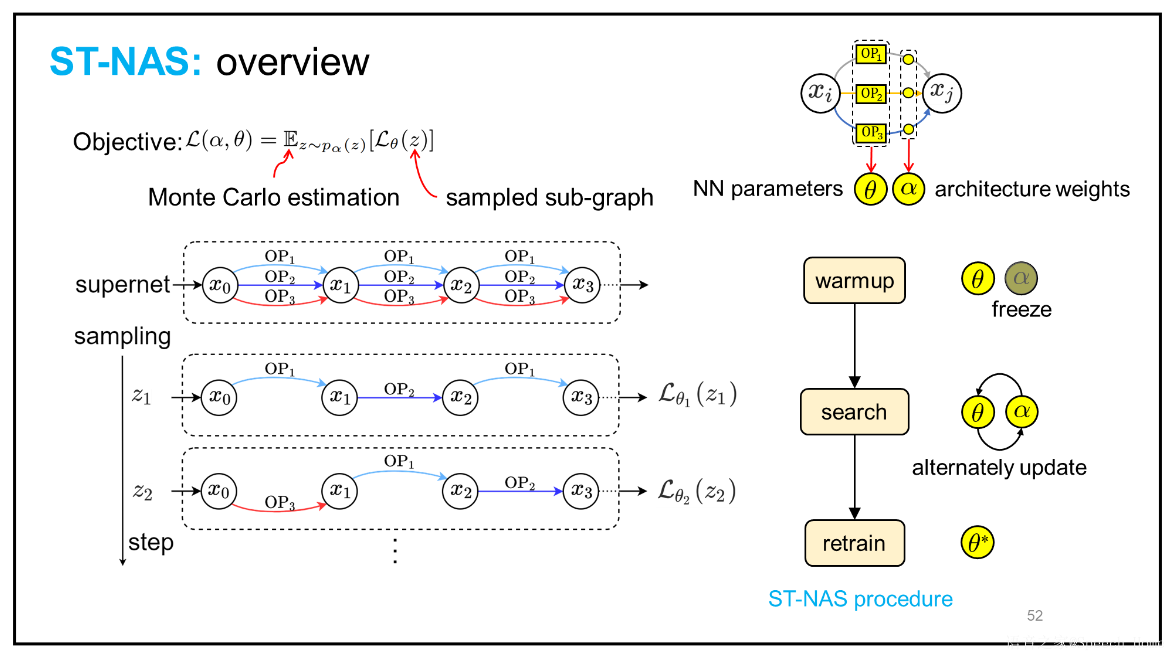
NAS训练的不仅有算子权重参数α,还有算子本身的参数θ。实际中,NAS训练包括三阶段:热身(warmup),架构搜索,再训练(retrain)。首先,固定使用均匀的α,只训练θ。然后,交替训练α和θ,直至收敛。最后,依据训练得到的最大权重进行算子挑选,对挑选出的架构再训练,这样希望尽可能达到给定架构的最佳性能。
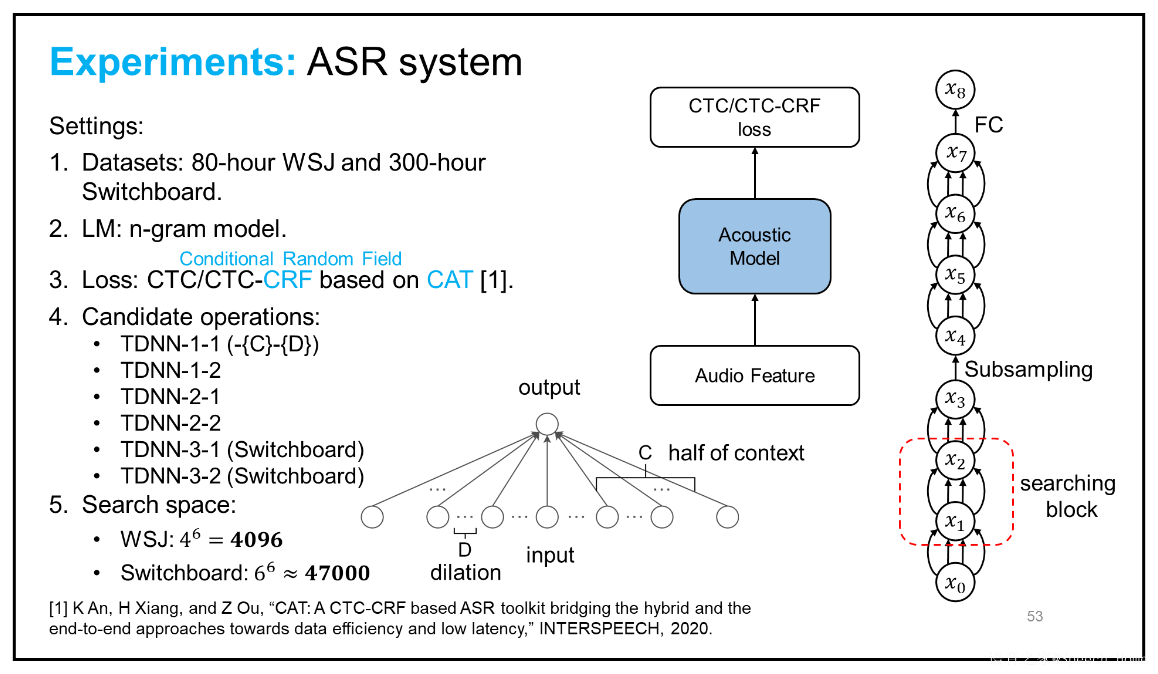
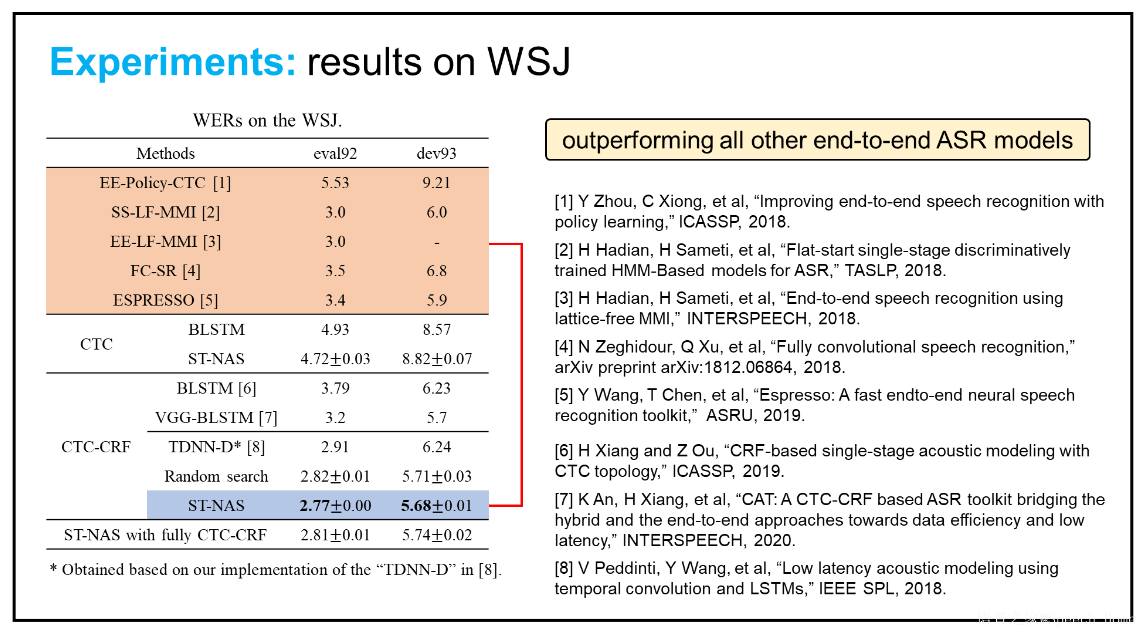
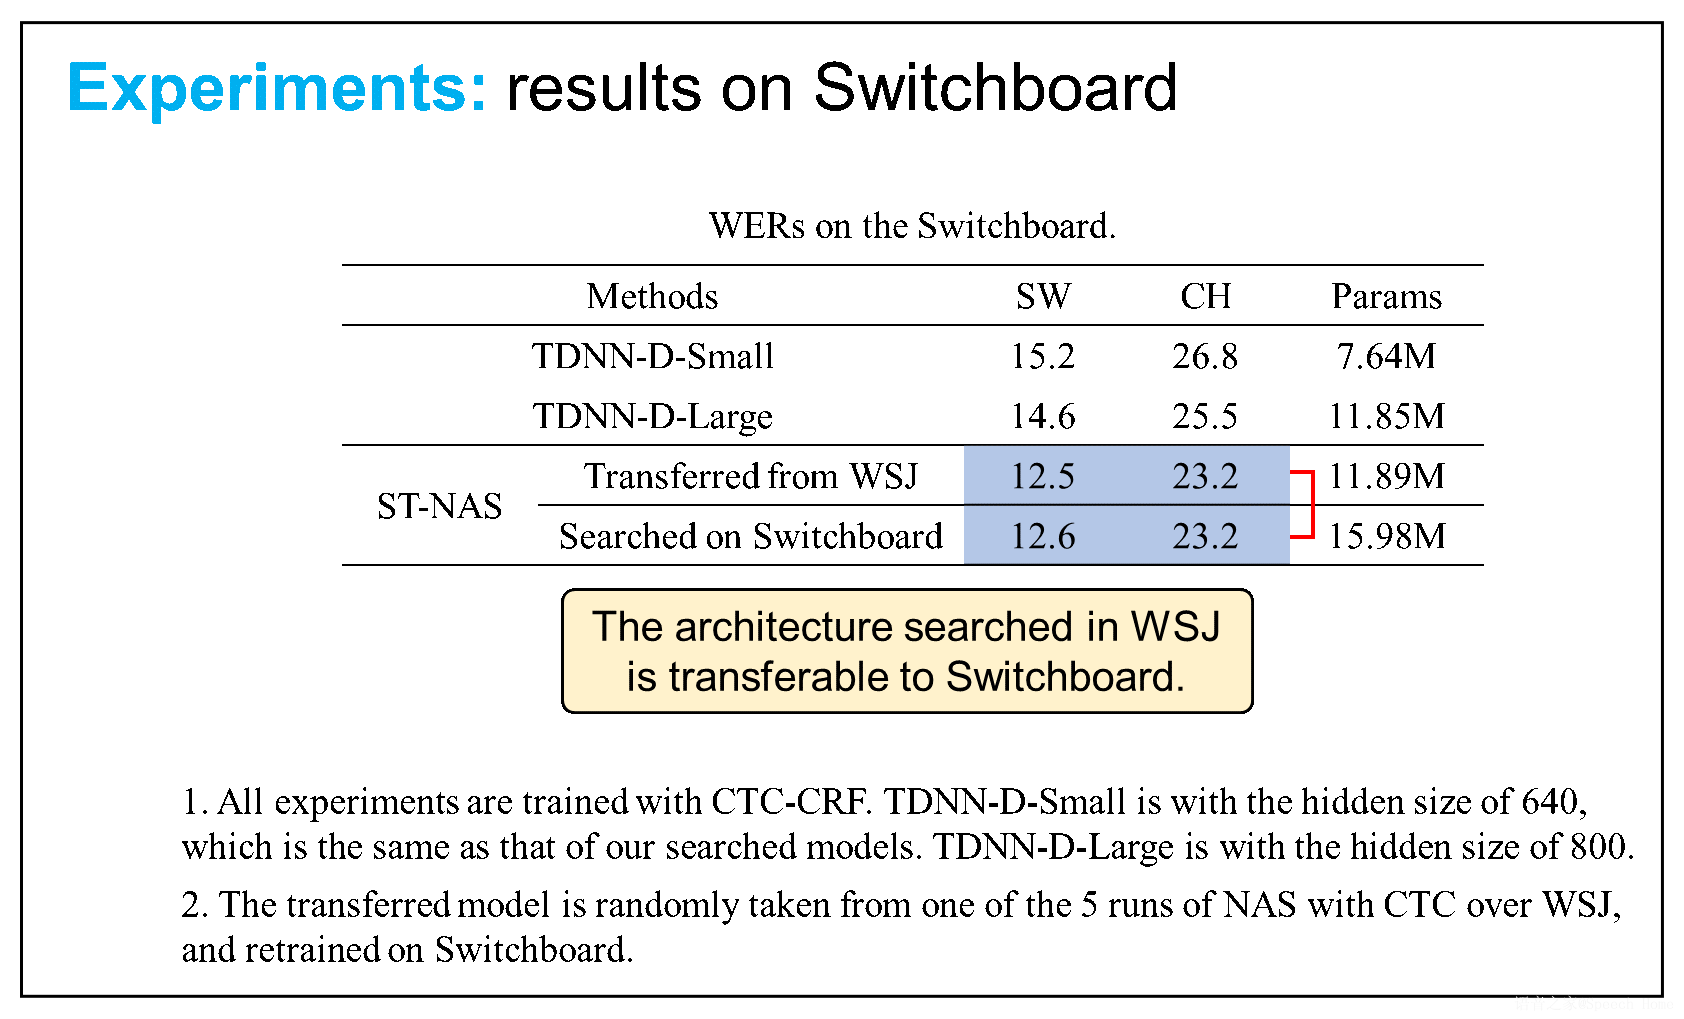
我们在不同规模的训练数据(80小时WSJ、300小时Switchboard)上,展示了ST-NAS的优越性。我们使用ST-NAS,为多层的TDNN神经网络的各层自动搜索最佳卷积宽度和空隙的TDNN算子,其性能超过了当前广泛使用的人工设计的TDNN网络。在WSJ eval92英文语音识别错误率达到了据我们所知最低的2.77%,超过了文献中公开报道的其它端到端模型。我们还考察了使用CTC准则的NAS搜索出来的架构,具有迁移性(transferable),可以在CTC-CRF准则下再训练,从而减少NAS训练复杂度。ST-NAS的实现和实验代码已经全部开源,欢迎大家测试和提出建议。
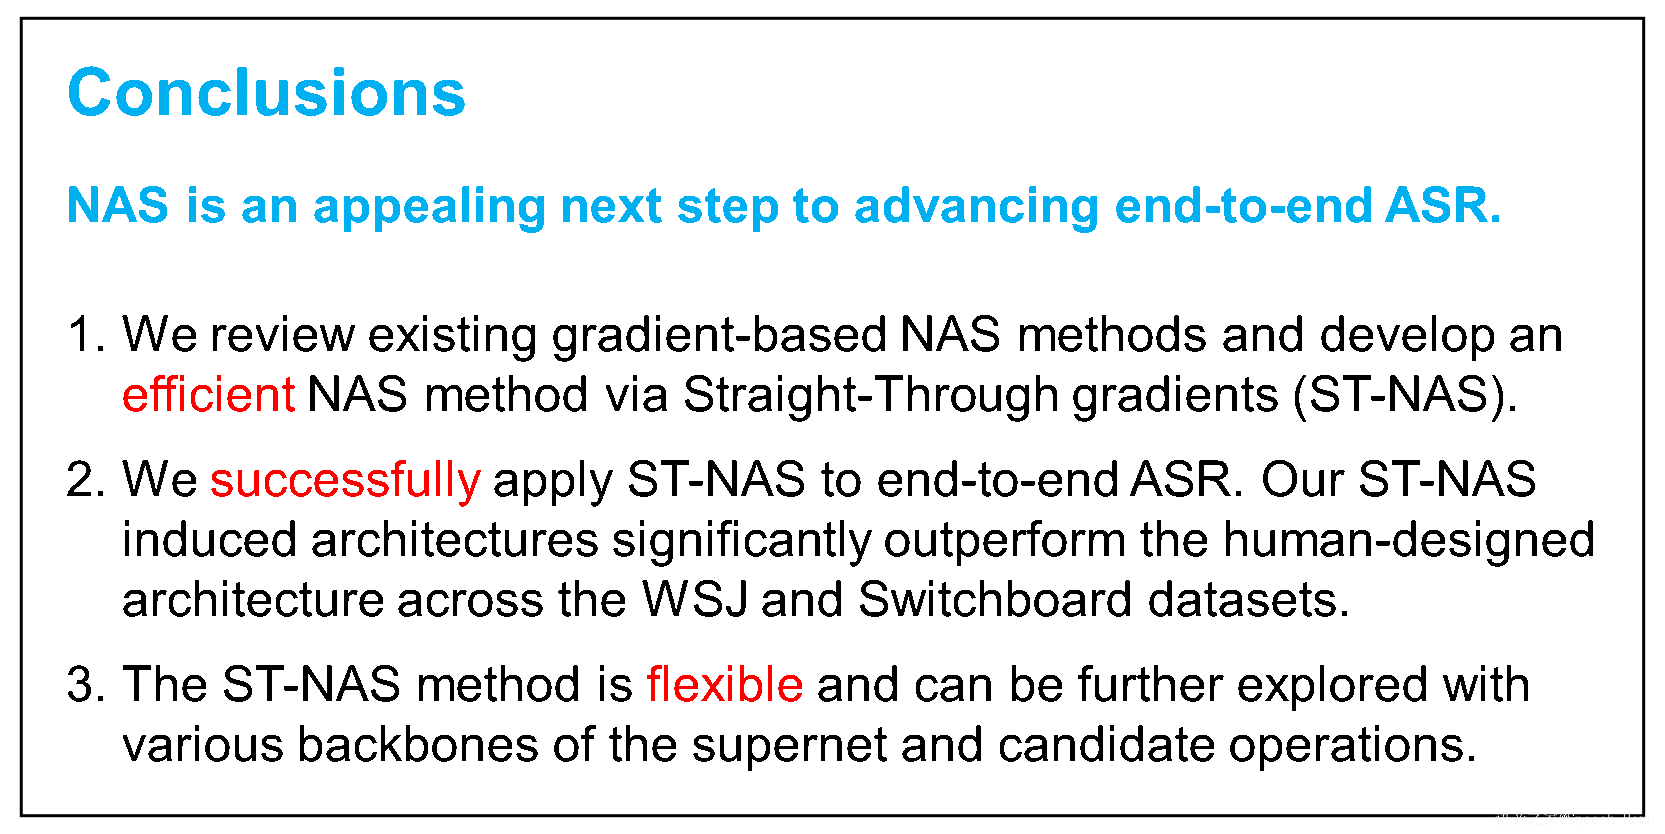
总的来说,第二代语音识别把“特征工程”自动化了,NAS面向“架构工程”自动化,是推动语音识别发展的非常诱人的下一步。我们的初步研究表明了这个方向工作的可行性。ST-NAS方法本身很灵活,可以支持使用更多样的超图及候选算子,理论上也支持微观结构搜索。我们的研究目前还是比较宏观的结构搜索,如何进行更微观结构搜索非常值得进一步探索。
七、总结
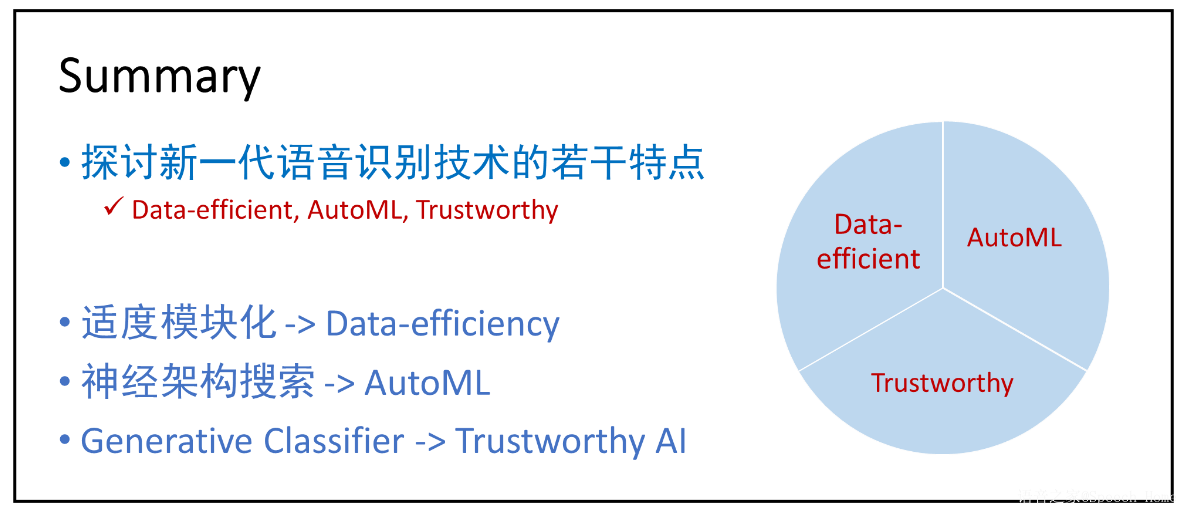
从2011年语音识别全面进入第二代,已过去10年,从当前第二代语音识别面临的挑战出发,我们探讨了新一代语音识别技术的若干特点——数据高效、自动机器学习以及可信赖,并分享我们的若干进展。通过适度模块化,我们设计并发展了分立的声学模型CTC-CRF、语言模型TRF,实现了数据高效端到端语音识别。我们开展了ST-NAS研究,朝AutoML努力。我们也正在探索使用“生成式分类器”实现可信赖语音识别。大胆创新,突破第二代语音识别技术的局限,推动语音识别发展到一个新的高度未来可期,欢迎大家多探讨指正,谢谢!
