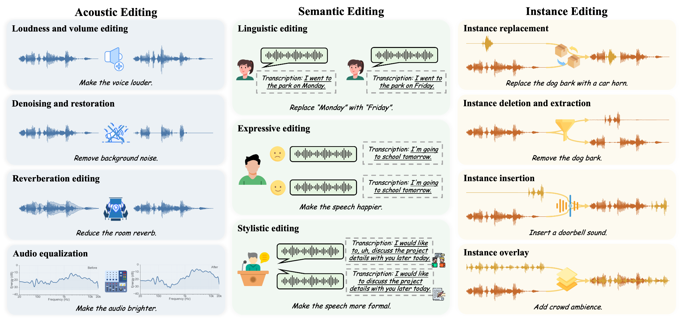
AudioEdit:深入探索基础模型时代的音频编辑

把录音里说错的一个词改过来,让一句话的语气更轻松,或者去掉背景中的狗叫声,同时保留原本的人声和环境声——这些看似简单的要求,正是音频编辑需要解决的问题。 随着音频生成模型的发展,用文字描述一段声音并让模型生成出来,已经有了不少可行方案。但面…
资讯算法
13 0 0

把录音里说错的一个词改过来,让一句话的语气更轻松,或者去掉背景中的狗叫声,同时保留原本的人声和环境声——这些看似简单的要求,正是音频编辑需要解决的问题。 随着音频生成模型的发展,用文字描述一段声音并让模型生成出来,已经有了不少可行方案。但面…
语音助手正在从“一问一答”走向跨越多次会话的长期交互。用户上周提过的计划、某位家庭成员说过的话、某次对话时的语气,都可能在之后被问起。但语音里的信息远不止文字:谁说的、怎么说的、背景里有什么声音,都只存在于音频信号里,一旦转成文字就丢失了。…
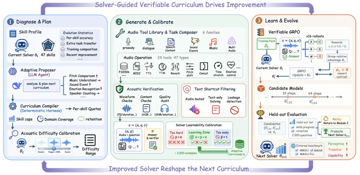
同一句话播放两遍,内容一模一样,只是第二遍音调更高,让它挑出音调更高的那一遍。能把语音转写准确的模型,未必答得好这样的题。类似的问题还有:一段对话里有几位说话人?一段音乐的节奏有没有加快?这些任务都在提醒我们:知道“说了什么”,不等于听懂声…
Edge0 发布 Audio8-ASR-Infinite 预览版,面向中英文实时语音识别,提供 80、120 和 160ms 三档流式音频时钟,并可将转写延迟配置在 240–560ms。 模型原生上下文为 30 秒,但通过滚动 KV 缓存持…
过去一年,OpenAI、Thinking Machines Lab 等多模态团队开始把注意力从「生成更拟人的语音回答」,迈向一个更难的问题:AI 如何真正参与一场实时发生的互动。 全双工模型让智能体边听边说,全模态让语音、视觉等信息协同判断…
ESPnet 团队发布开放语音数据集 YODAS v3,收录超过 110 万小时、147 种语言的真实世界音频,全部以 48kHz 发布,其中超过 70% 包含两个及以上真正不同的音频通道。 相比此前主要面向语音识别的 YODAS,v3 加…
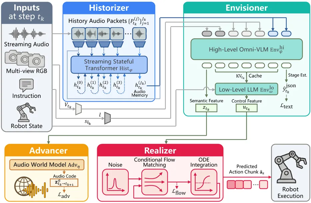
本文来源丨21db声学人 视觉—语言—动作模型已经让机器人越来越会“看着做事”,但现实操作中的很多关键状态并不写在画面里:微波炉“叮”的一声、电话铃响、咖啡壶沸腾时的喷溅声,往往只出现几百毫秒。上海交通大学与剑桥大学团队提出 HEAR 框架…
过去两年,TTS(文本转语音)赛道的竞争焦点发生了一次微妙的转移。 早期大家比的是“像不像真人”——音色克隆、自然度、音质MOS分。但当ElevenLabs把Voice Design的概念带火之后,一个新的问题浮出水面:一个声音“好听”,不…
以下文章来源于SIGCHI XI AN 当一个人说“我很好”时,文本传递着积极含义,语调却逐渐低沉,面部表情又在某个瞬间短暂僵住——模型究竟应该相信哪一种信号? 核心观点 情绪并非静态峰值的集合;可靠的多模态理解,需要先读懂变化的过程,再决…
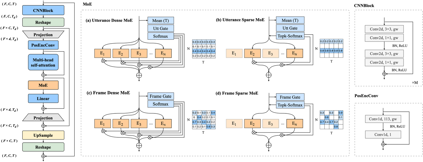
近日,蚂蚁集团-大安全机器智能-AI身份智能团队,推出基于混合专家机制(MoE)的声纹识别模型 MECT(Mixture of Experts CNN-Transformer),首次将 MoE 机制引入全监督训练说话人识别领域。在权威基准