 追声少年王富贵
任务1:低复杂度声学场景分类
此外,通过限制模型大小为128kB以及对一秒钟音频片段进行乘法累加运算的数量为3000万次,保持了对低复杂度模型的关注。这确保了模型不仅准确,而且在资源受限的设备上运行效率高。
技术方案
当模型部署在端侧时,对模型的参数量及计算量本身就有严格限制,再叠加有限数据样本的考验,如何设计出更轻量的基础模型,使模型利用少量训练数据即可更准确地判断声音场景,是本次团队的技术创新点。
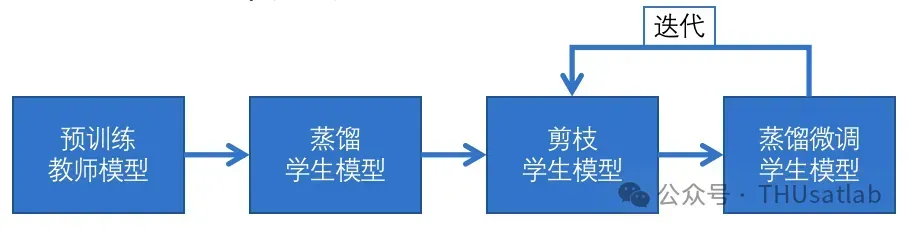
首先,团队基于MobileNet及CP-Mobile的模型,引入了空间可分离卷积操作,有效提升了低复杂度模型的识别性能。此外,团队选取并融合了多个Transformer架构作为教师模型,用于模型蒸馏。最后,团队提出了“迭代蒸馏剪枝”的模型压缩方案,不同于常见方法直接一步将模型压缩到需要的复杂度,而是逐渐多步迭代压缩,有效降低了模型在压缩中的性能损失。
任务2:工业设备异常声音检测
异常声音检测技术旨在仅有正常样本训练的情况下进行异常检测,2023年的任务关注零样本学习和域泛化问题,这是通过为开发和评估数据集提供完全不同的机器类型,并附加额外的属性信息来实现的。2024年的任务采用开发和评估数据集包含不同机器类型的方式进行,对于评估数据集,机器类型是在以前的任务中未曾见过的新类型。此外,主办方还将开发数据集中的机器类型的部分额外属性信息隐藏,用以模拟一些现实世界的情况。挑战赛期待参与者开发出有助于解决零样本学习问题的技术,并训练出能够具备域泛化能力的稳健模型。
技术方案
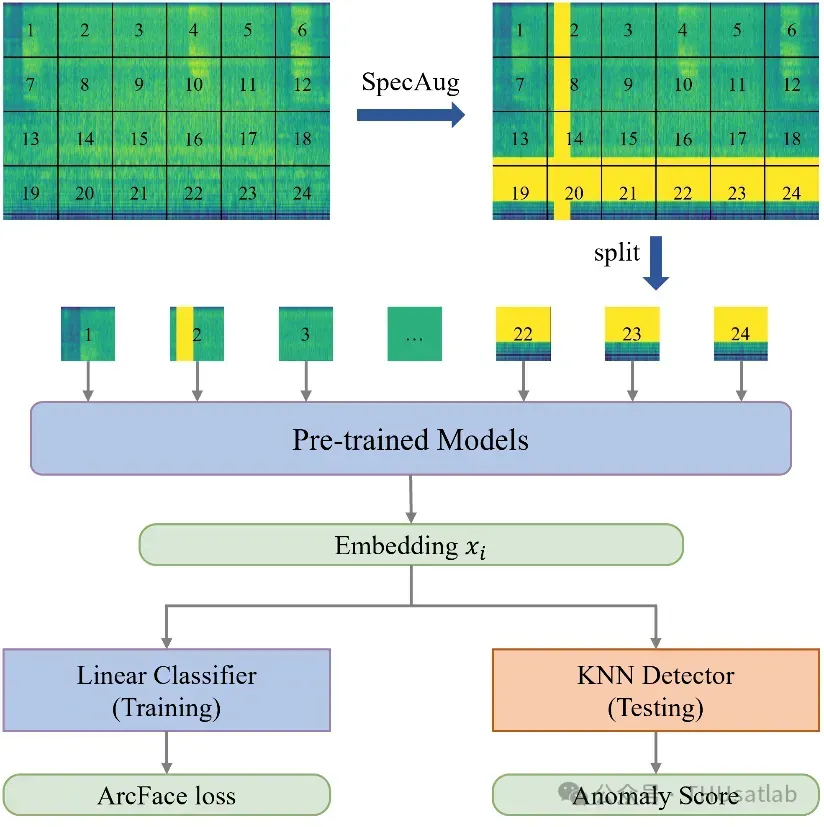
微调基于BEATs和EAT的三种预训练模型,将通用音频知识注入异常检测系统。
使用层次聚类获得缺失的工况,采用部分缺失的工况和预测补全后的工况,从粗细两种粒度对模型进行训练。
引入低秩微调 (LoRA) 技术,提升迁移学习时的鲁棒性。
使用SMOTE算法对目标域样本进行过采样,再对源域和目标域分域检测,提升跨域的鲁棒性。
使用权重平均、模型融合两种方法,组合多个模型,进一步提升异常检测性能。