西工大音频语音与语言处理研究组
此次挑战赛共吸引了来自国内外的 51 支队伍注册参赛,并在两个赛道上收到了 97 份有效提交结果。竞赛总结论文“Findings of the 2024 Mandarin Stuttering Event Detection and Automatic Speech Recognition Challenge”已被语音领域的顶级会议 SLT2024 接收。本文将分享竞赛总结,包括背景、数据集、赛道设置、比赛结果以及各参赛队伍采用的关键技术等。
赛事网址:https://stutteringspeech.org/
论文题目:Findings of the 2024 Mandarin Stuttering Event Detection and Automatic Speech Recognition Challenge
合作单位:StammerTalk,希尔贝壳,南开大学,中国科学技术大学,武汉大学,WeNet开源社区
作者列表:薛鸿飞,龚嵘,邵明辰,徐昕,王乐之,谢磊,卜辉,周家名,秦勇,杜俊,李明,张彬彬,宾佳
论文网址:https://arxiv.org/pdf/2409.05430
基线系统:https://github.com/hongfeixue/StutteringSpeechChallenge
口吃是一种语言障碍,影响全球约 1% 的人口[1],其主要特征是语言中的重复、延长和阻塞等不流畅现象[2]。这些问题严重影响了患者的社交能力和心理健康,常常使口吃患者(PWS)感到压力、羞愧和自卑,导致他们回避交流并逐渐与社会隔离。早期干预对于治疗至关重要,尤其是在儿童中表现出显著效果。然而,像中国大陆这样的地区,由于认证言语治疗师短缺,患者往往难以获得及时的帮助。
随着语音用户界面在智能家居设备和聊天机器人(如 ChatGPT)中的广泛应用,包容性语音技术的需求变得更加迫切。然而,现有的自动语音识别(ASR)系统在处理口吃语音时面临巨大挑战,这主要源于缺乏相关语音数据的支持。上述问题表明,研发有效的口吃事件检测(SED)系统以及包容友好语音技术至关重要。
为了解决这些问题,我们组织了普通话口吃事件检测与自动语音识别(StutteringSpeech)挑战赛,这也是全球首个聚焦普通话口吃语音的竞赛。挑战赛旨在动员研究者开发高效的口吃语音检测和识别系统,推动语音技术中的包容性发展。
StutteringSpeech 挑战赛设立了三个赛道:
Track I:口吃事件检测(SED):该赛道聚焦开发能够准确识别不同类型口吃事件的系统。及早发现对及时干预和治疗至关重要,因此本赛道的研究对于改善口吃患者的生活具有深远影响。
Track II:口吃语音识别(ASR):本赛道旨在构建能有效识别和转录口吃语音的专用 ASR 系统。由于现有 ASR 系统在处理口吃语音时存在明显局限,本赛道鼓励开发更具包容性的识别技术。
Track III:研究论文:该赛道接受与口吃语音相关的开放性研究论文提交。
本次挑战赛吸引了国内外 51 支队伍参赛,并在两个赛道上收到了 97 份有效提交结果。其中,T029 团队提出的 Conformer-BiLSTM 模型在 SED 赛道上取得了 66.93 的 F1 分数,相较于基线系统性能提升了 19.9%;T006 队伍通过完善的数据增强技术,在 ASR 赛道上实现了 12.20% 的字符错误率(CER),相比基线系统提升了 35.9%。
INTERSPEECH2024 | AS-70: 用于语音识别和口吃事件检测的中文口吃语音数据集
数据组成
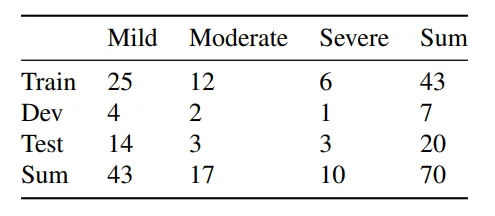
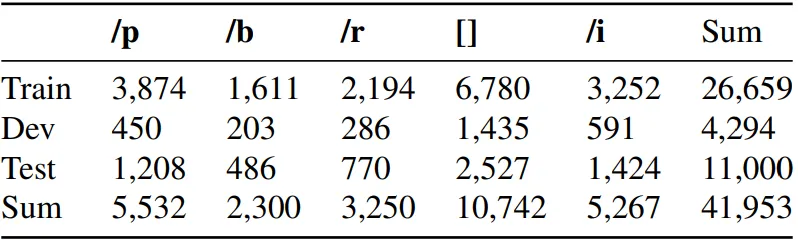
我们使用了在 INTERSPEECH 2024 中开源的 AS-70 普通话口吃语音数据集[3]来支持本次挑战赛。该数据集总时长为 48.8 小时,包含 70 名母语为普通话的口吃者,其中男性 46 名,女性 24 名。标注文本包含了五种类型的口吃现象,具体如下:
[]:词/短语重复。用于标注重复的完整的字、多字或词(如果只是单音重复,请用/r)。
/b: 阻塞。标注明显的长时间卡壳或短时间卡断(b指block)。
/p: 延长。标注拉长的音素(p指prolongation)。
/r:标注声音重复。比如单个辅音或元音,不足以构成一个字(r指repetition)。
/i: 插入词。由于口吃引起的填充字符,比如不自然的嗯、啊、呃(i指interjection)。如果是听感自然的插入语不用标。
标注以逐字记录的方式进行,口吃标签嵌入为标记。例如,“嗯/i/p,我[我我]的名/b字是小/r明。”。字符“嗯”是插入词并且延长。字符“我”重复两次。此外,字符“名”上有一个阻塞标注。字符“小”的一个音素被标记为声音重复。一个字符可能携带多个标签。
数据划分
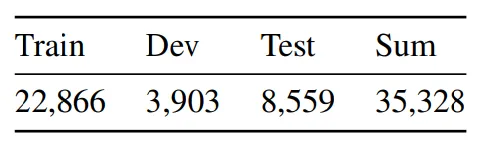
赛道设置
Track I — 口吃事件检测 (Stuttering Event Detection, SED):这是一个多标签分类任务,要求参赛者开发模型来识别短语音片段中的口吃事件。音频片段中可能包含五种口吃类型:声音延长、声音重复、字符重复、阻塞和插入。比赛初期,参赛者被提供了带有标注的音频训练集和开发集。系统的表现将根据测试集中口吃事件的检测准确度、召回率、精确度和 F1 分数进行评估,F1 分数是评估模型整体性能的关键指标。
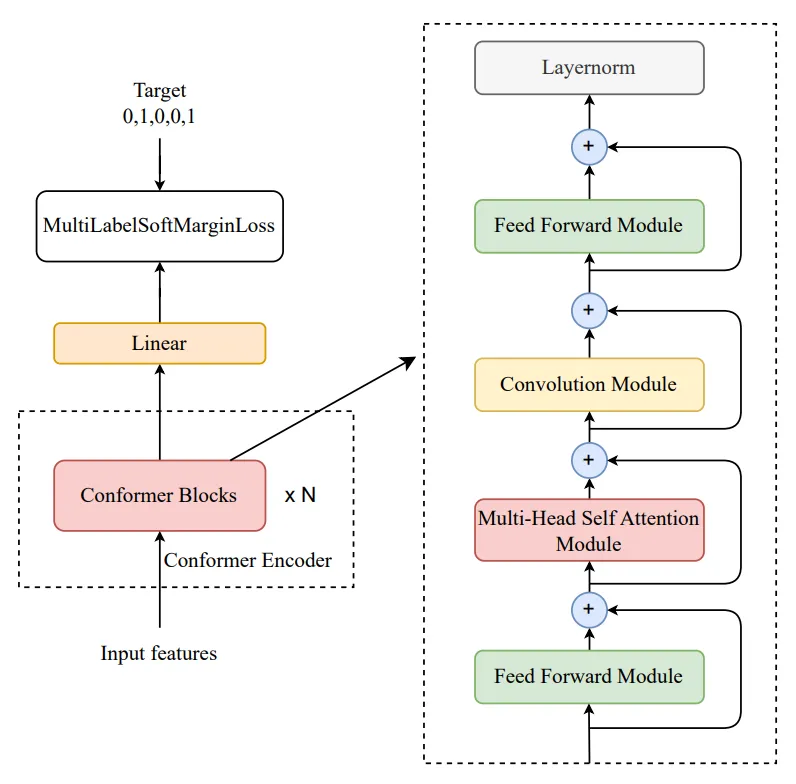
图1 Track I的基线模型结构。Target 0,1,0,0,1 表示是否存在五个口吃事件
Track II — 自动语音识别 (Automatic Speech Recognition, ASR):这一赛道的目标是开发能有效处理口吃语音的 ASR 系统。参赛者需设计出可以准确转录包含口吃事件语音的语音识别系统,并将口吃标签去除,生成纯文本。为参赛者提供了包含口吃语音和相应文本转录的训练集与开发集。ASR 系统的性能通过字符错误率 (CER) 来评估。
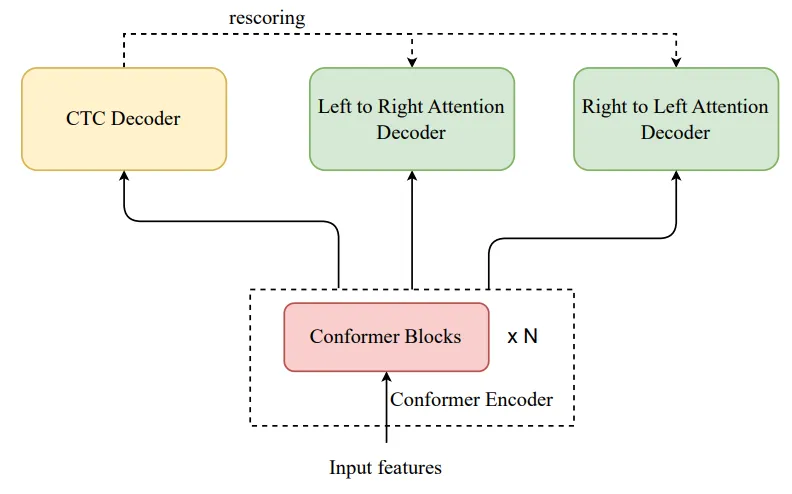
图2 Track II 的基线 U2++ 模型结构
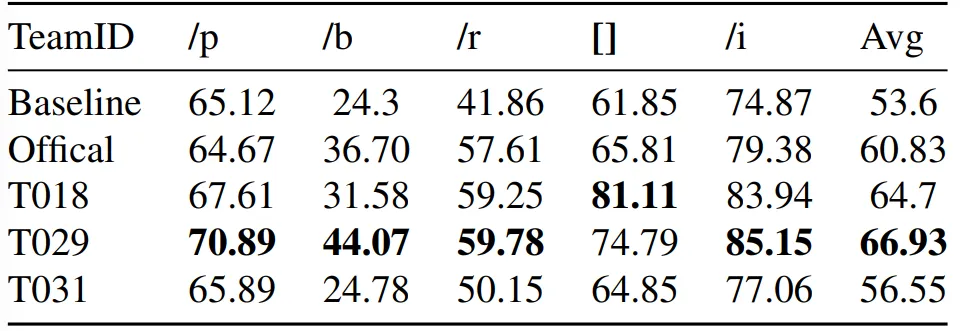
Track I 的排行榜结果如表 4 所示。T029 团队在五种口吃事件中取得了最高的平均 F1 分数,并在四个单独事件中表现突出。他们的成功归功于其Conformer-BILSTM 模型,该模型在提取局部口吃声学特征的同时,能够有效捕捉上下文信息。此外,T029 采用了五个独立的分类头,分别检测每种口吃事件,从而简化了检测过程并提高了准确性。T018 团队获得了第二高的平均 F1 分数,与基线相比提升了 20.7%。他们在词/短语重复([])事件中表现尤为优异,远超其他模型。T018 使用了 Zipformer 结构[6] 和数据增强技术,特别是 Zipformer 模型以其强大的上下文信息捕捉能力,在检测语音中重复部分时表现出色。T031 团队获得了第三名,他们的 FGCL 模型相比基线系统提升了 5.5% 的 F1 平均得分。值得一提的是,T031 没有使用任何数据增强技术,而是专注于模型结构的改进,这为口吃事件检测(SED)的发展做出了重大贡献。如果将他们的模型与数据增强技术相结合,性能有望进一步提高。
我们的官方系统Offical虽然没有参与排名,但相比原始基线,平均 F1 分数提升了 13.5%。该系统仅使用了速度扰动[7] 和数据平衡技术,显示出显著改进。特别是速度扰动在 SED 中表现尤为有效,因为口吃现象与语速密切相关,改变语速会生成多样化的口吃数据,从而提高模型的泛化能力。
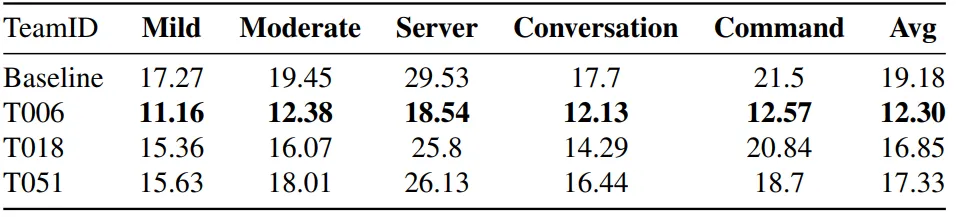
Track II 的排行榜结果如表 5 所示。T006 团队在所有测试集中均获得了第一名,其平均 CER比第二名团队低 27%,比基线模型低 35.87%。T006 团队的成功主要归功于其全面的数据增强技术,包括基于信号和基于对抗的增强方法。此外,他们在 ASR 任务中使用的 E-branchformer 架构[8] 也显著优于 Conformer 模型,进一步提升了系统性能。T018 团队获得第二名,与基线相比,其平均 CER 降低了 12.1%。他们的成功部分源于强大的数据扩增技术和 Zipformer 模型[6] 结构的应用,尽管其数据增强效果不及 T006 团队,但 Zipformer 结构在口吃 ASR 任务中的潜力值得进一步探索。T051 团队排名第三,与基线相比,平均 CER 降低了 9.6%,这表明 Branchformer 架构[9] 在处理口吃语音识别任务中具有较好的性能。
在所有的比赛结果中,CER 随着口吃严重程度的增加而升高。值得注意的是,没有任何团队的模型专门针对口吃的严重程度进行优化。未来的研究应更加注重开发能够有效应对不同程度口吃严重性的 ASR 系统。此外,从结果可以看出,除 T006 团队外,Command场景和Conversation场景的 CER 存在显著差异。而 T006 显著缩小了这一差距,表明他们的增强策略有效提高了命令语音的识别率,这在公共设施系统中的语音唤醒应用中具有很大的潜力。