近年来,深度学习的迅猛发展推动了语音识别、语音增强和说话人识别等技术的显著进步,极大改善了人机交互体验。随着声控智能设备的不断演变,对更自然、便捷的交互方式的需求日益增加。在众多应用场景中,人车语音交互作为人机交互的一种形式,尤其受到关注。在这一场景中,语音分离作为智能座舱中音频处理链路的第一步,成为人车智能交互的关键技术。然而,车载环境也带来了独特的挑战:分布式麦克风阵列在捕捉不同音区乘客的声音时,增加了音频通道的数量。同时,驾驶过程中,车内环境会遇到各种噪声干扰,使语音分离任务更加挑战。此外,车载系统面临计算资源有限和低延迟处理的双重限制。因此,如何高效实现车载多通道实时语音分离,成为亟待解决的研究课题。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)的论文“DualSep: A Light-weight dual-encoder convolutional recurrent network for real-time in-car speech separation”被语音旗舰会议IEEE SLT 2024接收。该论文提出了一种轻量级框架,结合数字信号处理和神经网络,使用固定波束形成和独立矢量分析来降低计算成本和提供空间先验。通过双编码器模型有效捕捉空间和频谱信息,同时支持流式和非流式模式。实验表明,仅需0.83M参数,即可在Intel Core i7(2.6GHz)CPU上实现高效语音分离。现对该论文进行简要的解读。
论文题目:DualSep: A Light-weight dual-encoder convolutional recurrent network for real-time in-car speech separation
作者列表:王子谦,孙佳耀,张子晗,李星辰,刘杰,谢磊
论文原文:https://arxiv.org/abs/2409.08610
样例展示:https://honee-w.github.io/DualSep/
近年来,深度学习的迅猛发展推动了语音识别、语音增强和说话人识别等技术的显著进步,极大改善了人机交互体验。随着声控智能设备的不断演变,对更自然、便捷的交互方式的需求日益增加。在众多应用场景中,人车语音交互作为人机交互的一种形式,尤其受到关注 [1]。在这一场景中,语音分离作为音频处理链的第一步,成为人车智能交互的关键技术。然而,车载环境也带来了独特的挑战:分布式麦克风阵列在捕捉不同音区乘客的声音时,增加了音频通道的数量。同时,驾驶过程中,车内环境会遇到各种噪声干扰,使语音分离任务更加挑战。此外,车载系统面临计算资源有限和低延迟处理的双重限制。因此,如何高效实现车载多通道实时语音分离,成为亟待解决的研究课题。
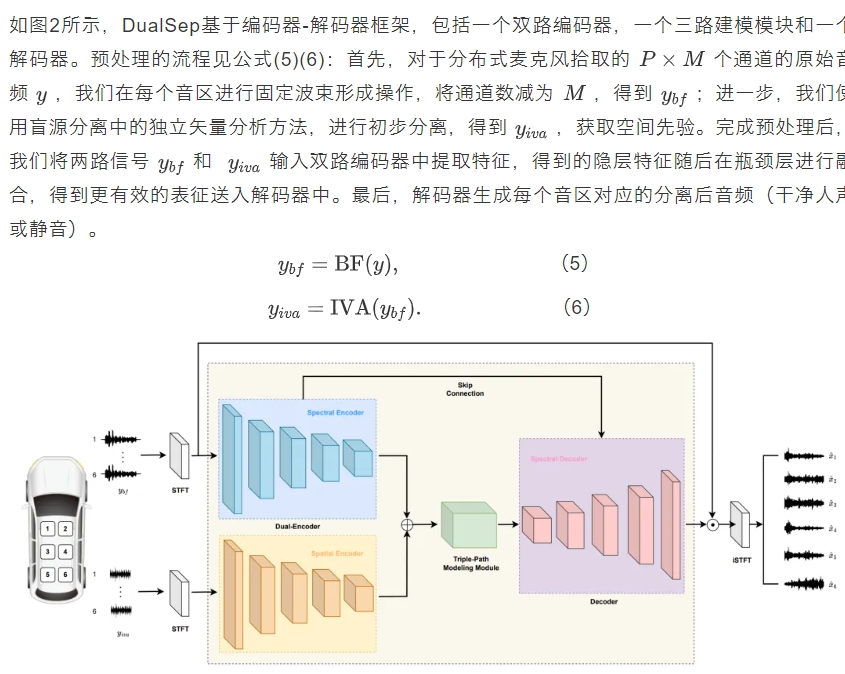
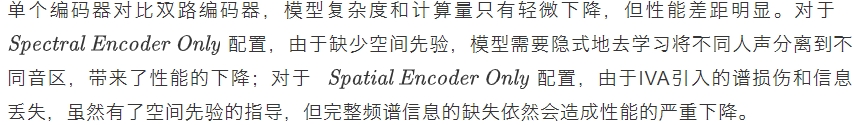
针对以上问题,我们提出了一种轻量级框架,将数字信号处理与神经网络有效结合。我们的系统采用固定波束形成技术[2]减少音频通道数,以降低计算成本,并利用独立矢量分析[3]提供空间先验信息。通过双编码器[4]的双路建模,空间编码器能够捕捉空间线索,而频谱编码器则专注于保留频谱信息,这样能够有效实现空间信息与时频信息的融合。此外,我们的系统支持流式和非流式两种模式,适应不同的应用需求。实验结果表明,该系统在各项性能指标上均表现优越,且仅需0.83M参数和0.39的实时因子(RTF),在Intel Core i7(2.6GHz)CPU上便能实现高效的语音分离。
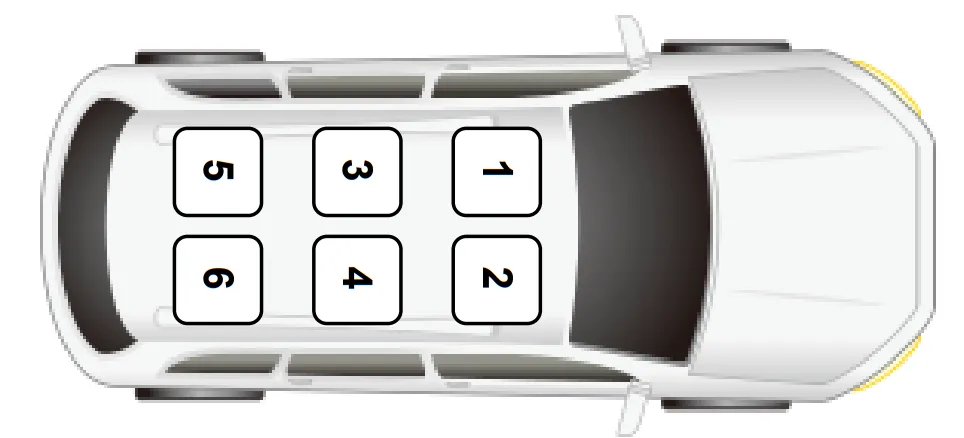
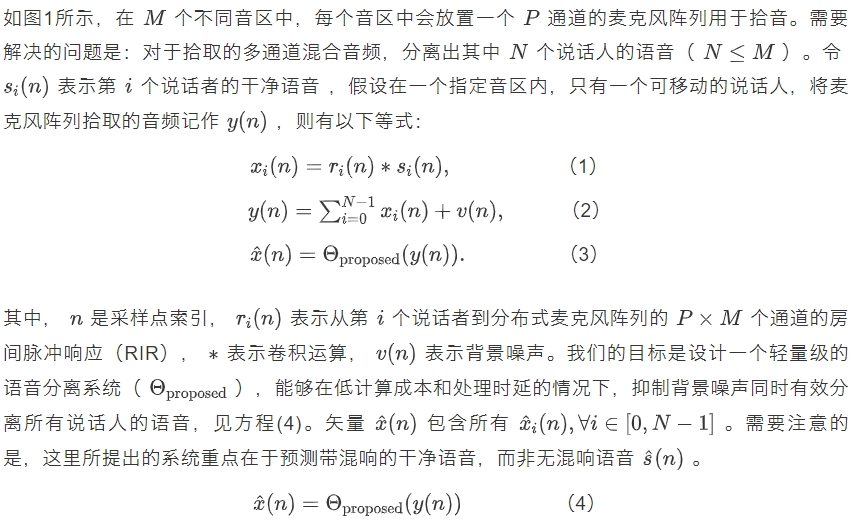
图1 车内音区示意图
图2 DualSep 模型结构
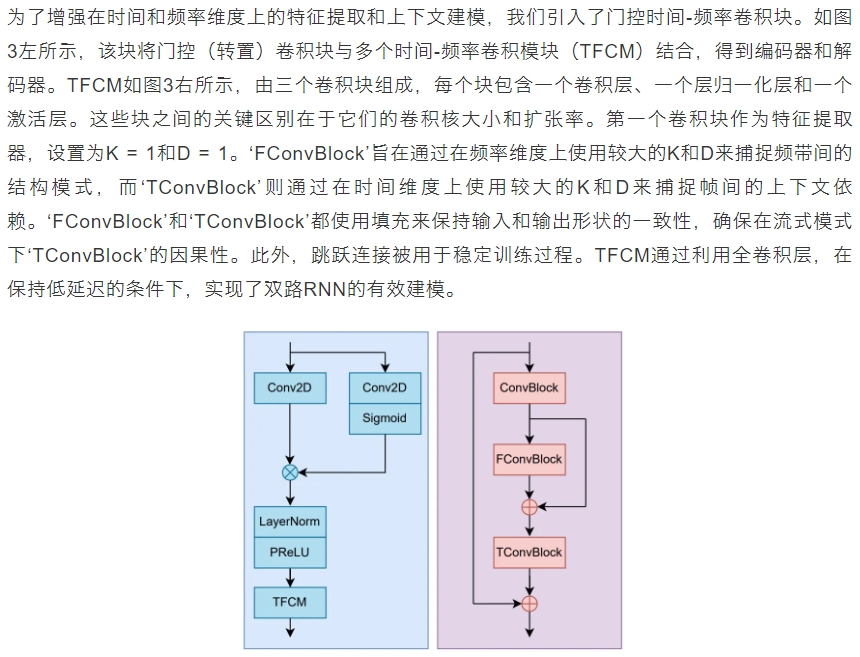
图3 门控时频卷积(左) 与时频卷积块(右)
空间-频域双路编码
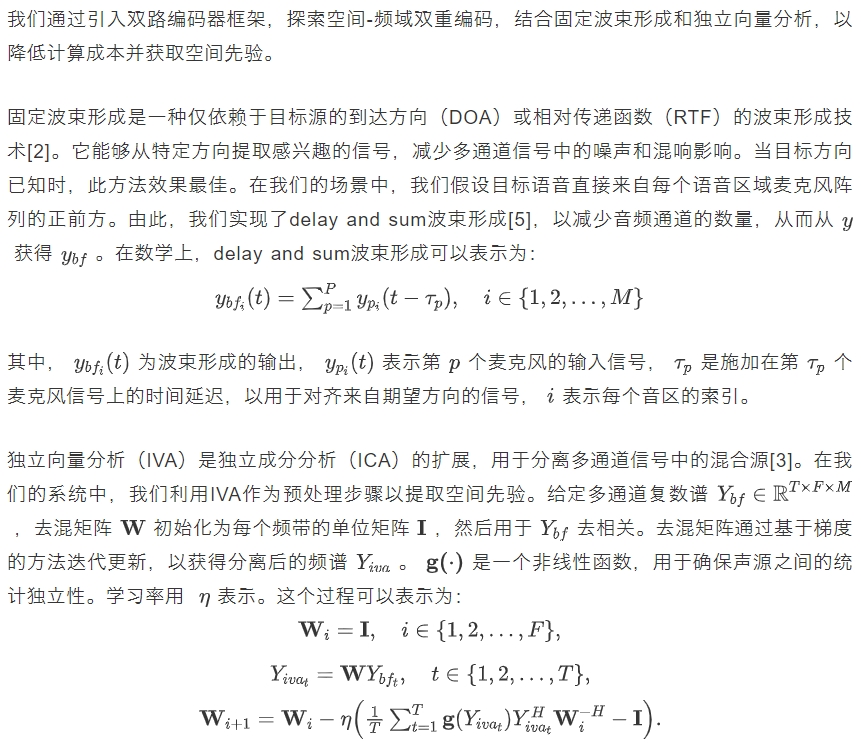
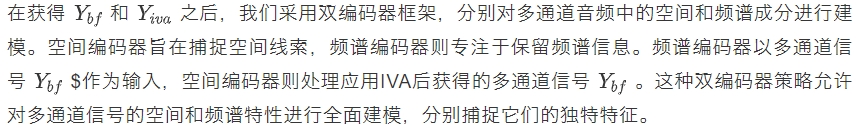
三路建模回溯网络
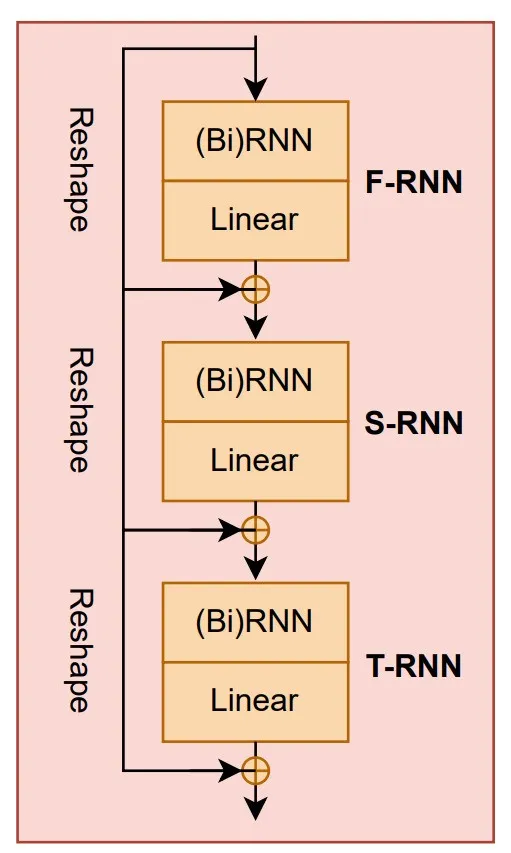
三路径建模模块由三个RNN块组成,如图4所示,结合了以频域为重点、以空间为重点和以时域为重点的RNN块,并通过跳跃连接实现全面建模。每个块结合了一个(双向)递归神经网络和一个线性层,以捕捉不同类型的信息。跳跃连接被引入以减轻潜在的信息损失。其中,第一个块被称为“F-RNN”,专注于沿频率轴建模单通道频谱信息。使用双向RNN使该块能够关注到每帧中的频带依赖,有效捕捉对于区分语音和噪声至关重要的频谱模式。第二个块为“S-RNN”,旨在利用多通道空间信息,学习空间线索的相关性,由于每个语音区域信号的显著差异,它可以起到空间聚类的作用,隐式地将不同音区的说话者分离开来。第三个块命名为“T-RNN”,利用全频带信息及其时域上下文。它收集并整合从前面的块中获得的信息,提供对频谱和空间特性的全面理解。线性层用于对齐特征维度,同时减少参数数量和计算复杂度。图4 三路建模回溯网络
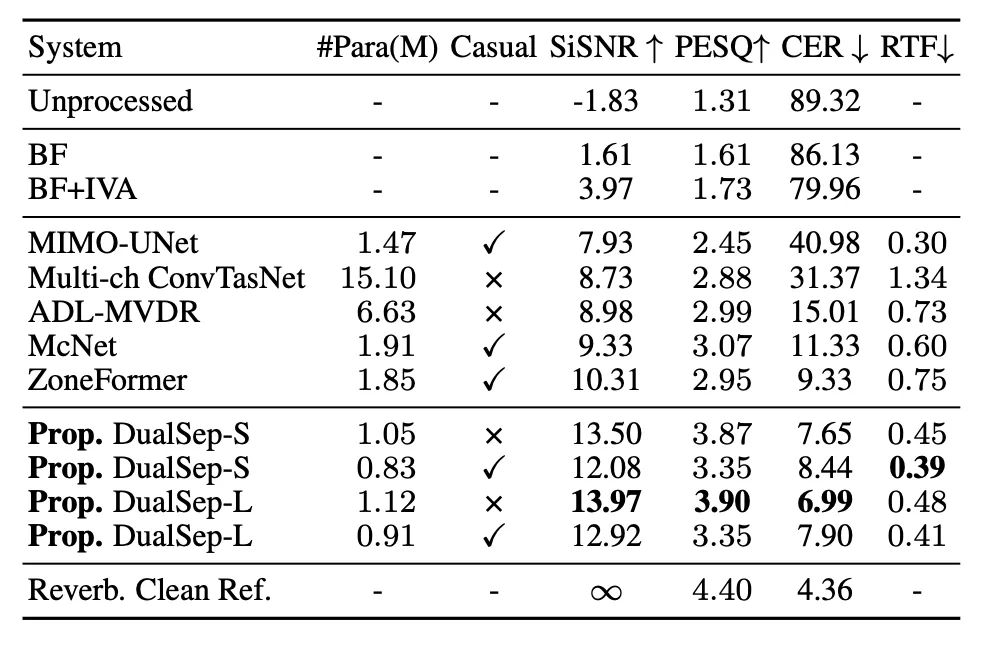
在复杂且具有挑战性的测试集上,基线系统都带来了显著的提升,信噪比提高8分贝以上,词错误率下降了40%以上。提出系统在听感相关指标和下游识别率相关指标都超过了基线系统,证明了双路编码器的有效性。- DualSep-S和DualSep-L的区别在于空间特征与频域特征的融合方式,在DualSep-S中,来自空间编码器和频域编码器输出的隐层特征采用相加方式;而在DualSep-L中采用拼接方式。
- 从结果上看,DualSep-L稍高,这是由于拼接方式会保留更多的信息,但同时也带来了计算量和RTF的提升。
- 提出系统在流式和非流式情况下性能可比,展现出了实时应用的潜力。
- 只使用波束形成(BF)带来的提升非常有限,这也符合我们的预期,它的主要作用是为了减少通道数,进而减少计算量。
- 波束形成和独立矢量分析结合的方法(BF+IVA),在词错误率上得到10%的下降,这也与我们的期望保持一致。IVA作为一种经典盲源分离算法,可以为后续的神经网络提供有效的空间先验。
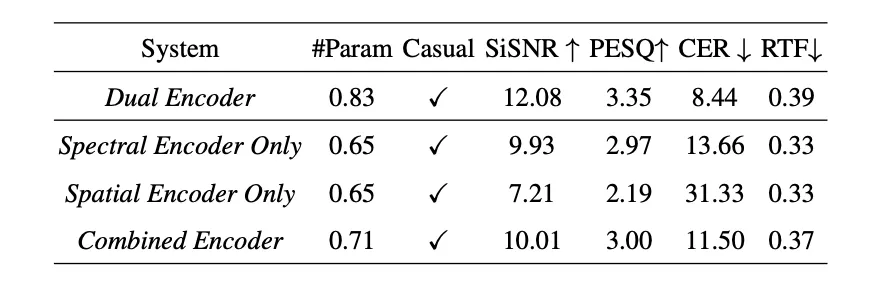
的输入为与的拼接,虽然兼顾了频谱信息与空间先验,但两者处于耦合状态,在与输入相同的情况下,依然存在性能差距,证明了双路编码器的有效性
[1] Prajval Kumar Murali, Mohsen Kaboli, and Ravinder Dahiya, “Intelligent in-vehicle interaction technologies,” Advanced Intelligent Systems, vol. 4, no. 2, pp. 2100122, 2022.[2] Sharon Gannot, Emmanuel Vincent, Shmulik Markovich-Golan, and Alexey Ozerov, “A consolidated perspective on multimicrophone speech enhancement and source separation,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 25, no. 4, pp. 692–730, 2017.[3] Taesu Kim, Intae Lee, and Te-Won Lee, “Independent vector analysis: Definition and algorithms,” in 2006 Fortieth Asilomar Conference on Signals, Systems and Computers. IEEE, 2006, pp. 1393–1396.[4] Muthu Chidambaram, Yinfei Yang, Daniel Cer, Steve Yuan, Yunhsuan Sung, Brian Strope, and Ray Kurzweil, “Learning cross-lingual sentence representations via a multi-task dual-encoder model,” in Proceedings of the 4th Workshop on Representation Learning for NLP (RepL4NLP-2019), 2019, pp. 250–259.[5] Barry D Van Veen and Kevin M Buckley, “Beamforming: A versatile approach to spatial filtering,” IEEE assp magazine, vol. 5, no. 2, pp. 4–24, 1988.[6] Hui Bu, Jiayu Du, Xingyu Na, Bengu Wu, and Hao Zheng, “Aishell-1: An open-source mandarin speech corpus and a speech recognition baseline,” in 2017 20th conference of the oriental chapter of the international coordinating committee on speech databases and speech I/O systems and assessment (O-COCOSDA). IEEE, 2017, pp. 1–5.[7] Harishchandra Dubey, Ashkan Aazami, Vishak Gopal, Babak Naderi, Sebastian Braun, Ross Cutler, Alex Ju, Mehdi Zohourian, Min Tang, Hannes Gamper, et al., “Icassp 2023 deep speech enhancement challenge,” arXiv preprint arXiv:2303.11510, 2023.[8] Zhuohuang Zhang, Yong Xu, Meng Yu, Shi-Xiong Zhang, Lianwu Chen, and Dong Yu, “Adl-mvdr: All deep learning mvdr beamformer for target speech separation,” in ICASSP 2021-2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2021, pp. 6089–6093.[9] Yujie Yang, Changsheng Quan, and Xiaofei Li, “Mcnet: Fuse multiple cues for multichannel speech enhancement,” in ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP). IEEE, 2023, pp. 1–5.[10] Yong Xu, Vinay Kothapally, Meng Yu, Shi-Xiong Zhang, and Dong Yu, “Zoneformer: On-device neural beamformer for in-car multi-zone speech separation, enhancement and echo cancellation,” Interspeech, 2023.
 西工大音频语音与语言处理研究组