
 语音小管家
内蒙古大学S2LAB 刘瑞研究员联合字节跳动、香港中文大学(深圳)等单位推出了涵盖中英双语、超过236小时的超自然对话语音合成数据集——NCSSD,并在GitHub平台开源了搜集子集的数据构建Pipeline,在Hugging Face平台开放了数据下载页面。🚀🚀🚀
您可以通过以下链接免费下载并立即开始使用:
Hugging Face数据集页面:https://huggingface.co/datasets/walkerhyf/NCSSD
GitHub数据仓库:https://github.com/walker-hyf/NCSSD
GitHub源码仓库:https://github.com/walker-hyf/GPT-Talker
GPT-Talker样例页面:https://walker-hyf.github.io/GPT-Talker/
arXiv预印本论文:https://arxiv.org/pdf/2407.21491
🔎 超236小时自然对话语音数据,包括搜集自互联网的电视剧集片段(搜集子集),以及人工录制的对话内容(录制子集)。 🌏 支持两种语言:中文(Zh)和英语(En) 📣 丰富的对话场景,涵盖多种对话主题和内容,丰富的说话人(776人以上)。 🏆 基于NCSSD训练的GPT-Talker性能优秀,可以为agent合成自然且具有表现力的对话语音。
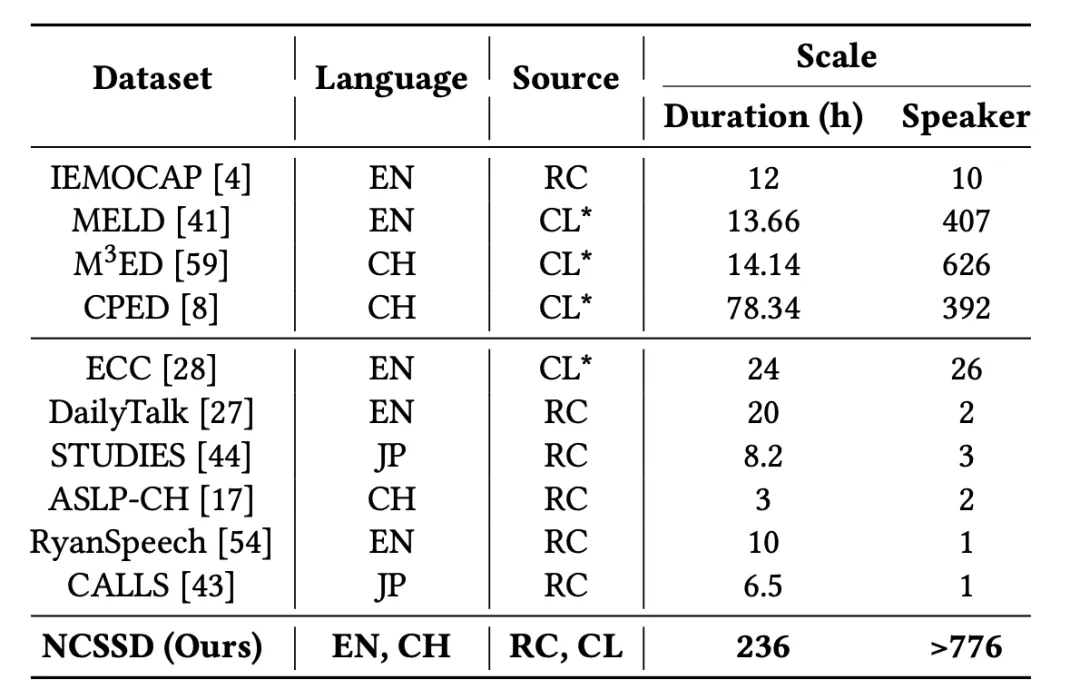
NCSSD 数据集统计
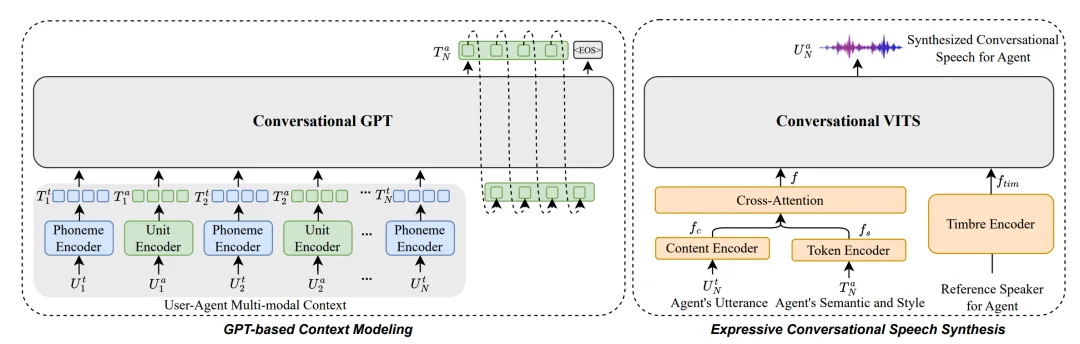
GPT-Talker模型结构图
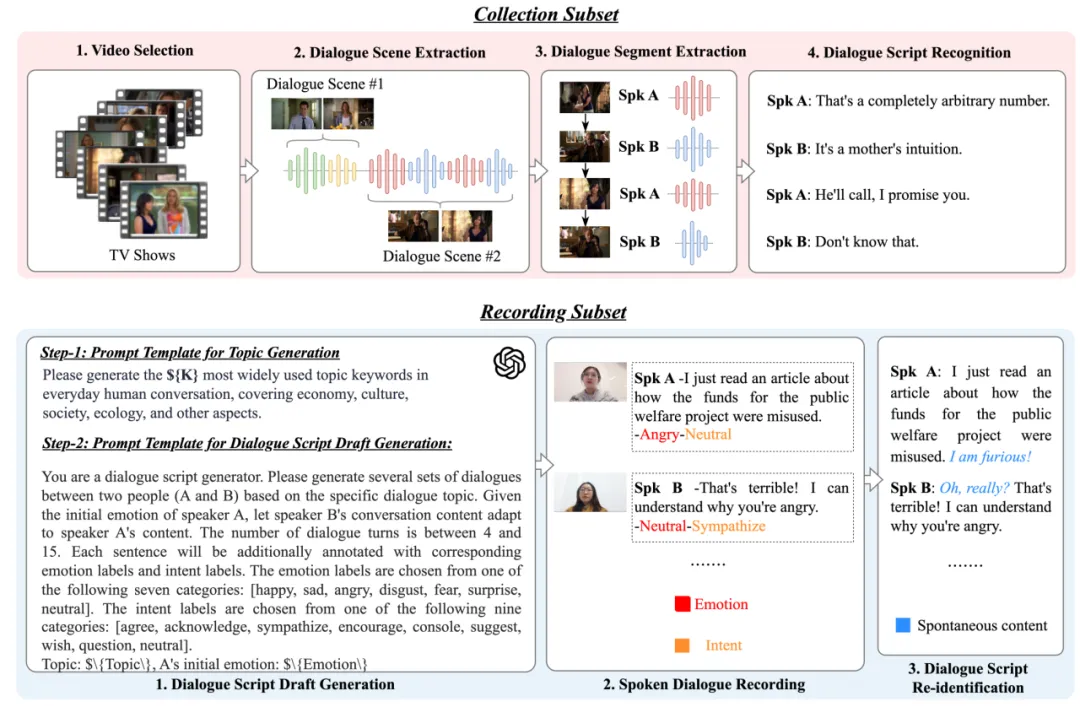
NCSSD数据集构建过程
