
 语音小管家
NVIDIA最近推出了一款革命性的生成式AI模型——Fugatto(Foundational Generative Audio Transformer Opus 1),它能够通过文本和音频输入创造任何组合的音乐、人声和声音。
这款由一群生成式AI研究人员打造的“声音的瑞士军刀”,让用户仅通过文本就能控制音频输出,能够根据提示生成或转换音乐、人声和声音,无论是基于文本提示创作音乐片段,还是在现有歌曲中添加或移除乐器,改变声音的口音或情感,甚至创造出前所未有的声音。
多白金唱片制作人兼词曲作者、One Take Audio联合创始人伊多·兹米什拉尼(Ido Zmishlany)表示:“Fugatto的问世令人惊叹,它让我在工作室中能够即时创造出全新的音效,这简直是不可思议的。”
NVIDIA应用音频研究经理、Fugatto背后的主要人物之一、同时也是管弦乐队指挥家和作曲家的拉斐尔·瓦耶(Rafael Valle)说:“我们的目标是创造一个像人类一样理解和生成声音的模型。”Fugatto是首个展示出从各种训练能力中涌现的特性,并能结合自由形式指令的基础生成式AI模型。
Fugatto的应用案例多样,音乐制作人可以快速原型化或编辑歌曲想法,尝试不同的风格、声音和乐器,并添加效果以提升现有音轨的整体音质。
广告公司可以利用Fugatto为不同地区或情境的现有广告活动快速调整旁白的口音和情感。语言学习工具可以个性化使用任何说话者选择的声音,比如让在线课程以任何家庭成员或朋友的声音进行讲述。
视频游戏开发者可以利用Fugatto根据游戏中不断变化的动作修改预录资产,或者根据文本指令和可选音频输入实时创造新的资产。
Fugatto的一个特别出众的能力是,它能够根据用户的描述创造出任何声音,比如让小号发出狗吠声或萨克斯发出喵喵声。用户可以描述出什么,模型就能创造出来。
通过微调和少量的歌唱数据,研究人员发现Fugatto能够处理它未经预训练的任务,比如从文本提示生成高质量的歌唱声音。Fugatto在推理时使用的技术称为ComposableART,能够结合训练期间仅单独看到的指令。这种能力让用户能够对文本指令进行细粒度控制,比如口音的轻重或悲伤的程度。
Fugatto的另一个创新之处在于它能够生成随时间变化的声音,这一功能被称为时间插值。例如,它可以创造一场暴风雨的声音,其中雷声逐渐增强然后慢慢消失在远方。
此外,Fugatto还允许用户对声音景观的演变进行细粒度控制。与大多数只能重现它们接触过的训练数据的模型不同,Fugatto允许用户创造它从未见过的声音景观,比如暴风雨逐渐过渡到带有鸟鸣声的黎明。
Fugatto是一个基础的生成式变换器模型,它基于团队在语音建模、音频编码和音频理解等领域的先前工作。完整版使用了25亿个参数,并在配备32个NVIDIA H100 Tensor Core GPU的NVIDIA DGX系统上进行了训练。Fugatto由来自世界各地的多元化团队打造,包括印度、巴西、中国、约旦和韩国,他们的合作使Fugatto的多口音和多语言能力更加强大。
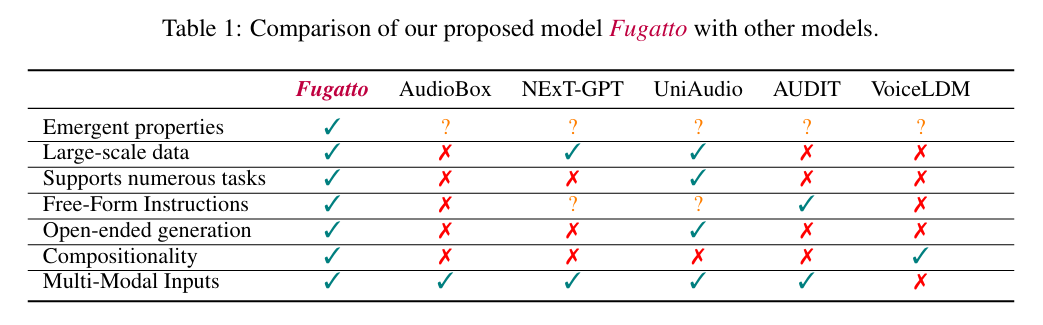
Fugatto的开发过程中最具挑战性的部分之一是生成包含数百万音频样本的混合数据集,这些样本用于训练。团队采用了多方面的策略来生成数据和指令,显著扩展了模型能够执行的任务范围,同时实现了更准确的性能,并在不需要额外数据的情况下启用了新任务。他们还仔细研究了现有的数据集,以揭示数据之间的新关系。整个工作历时一年多。
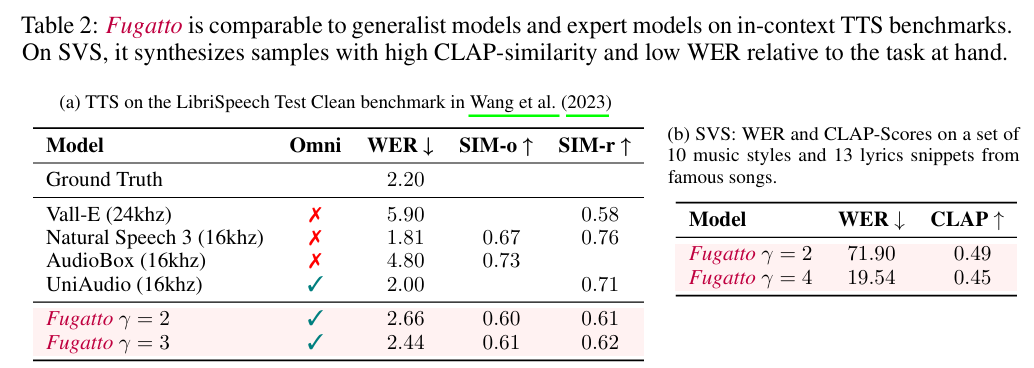
更多信息:https://d1qx31qr3h6wln.cloudfront.net/publications/FUGATTO.pdf
