
 语音小管家
clone-voice是一款免费开源的声音克隆工具,它凭借先进的人工智能技术,能够分析和模拟人类声音的特征,从而实现高质量的声音克隆. 只需提供一段简短的音频样本,它就可以根据该样本生成与原始声音极其相似的克隆声音,并且支持多种语言,目前包括中文、英文、日语、韩语等,甚至还扩展到了法语、德语、意大利语等16种语言,为用户提供了更广泛的应用可能性.
技术原理剖析
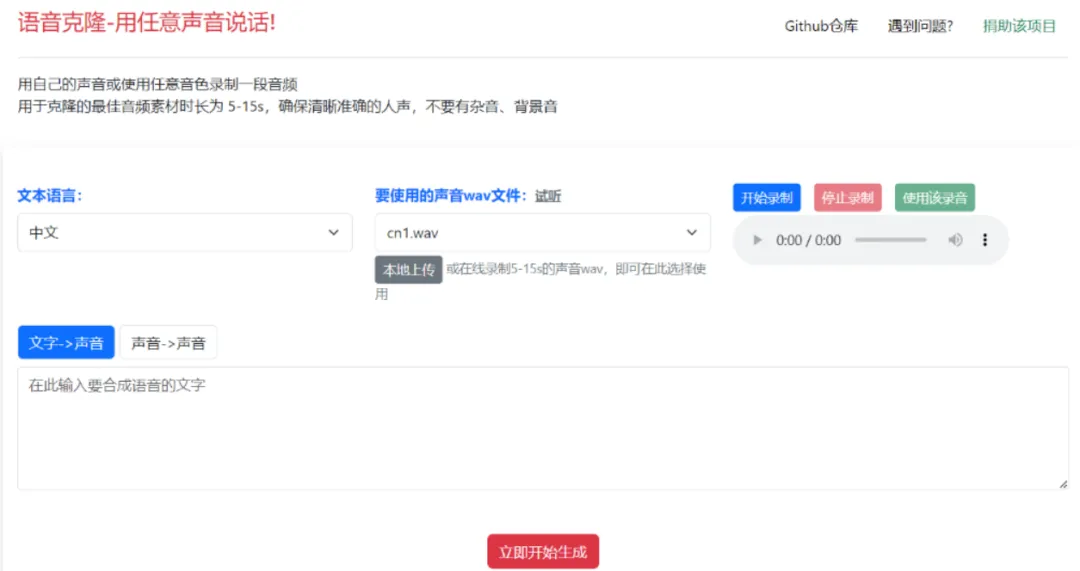
使用方法介绍
1、window预编译版使用方法
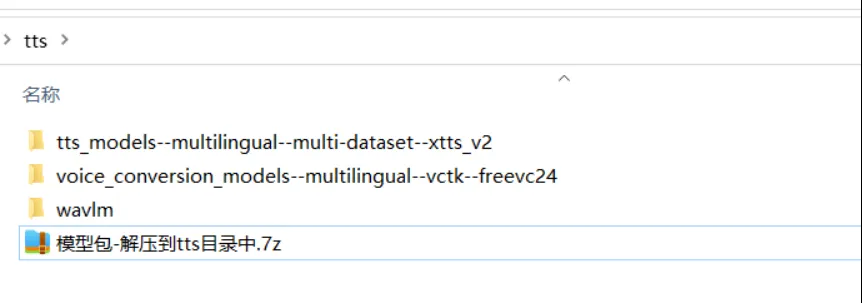
选择【文字->声音】按钮,在文本框中输入文字、或点击导入srt字幕文件,然后点击“立即开始”。 选择【声音->声音】按钮,点击或拖拽要转换的音频文件(mp3/wav/flac),然后从“要使用的声音文件”下拉框中选择要克隆的音色,如果没有满意的,也可以点击“本地上传”按钮,选择已录制好的5-20s的wav/mp3/flac声音文件。或者点击“开始录制”按钮,在线录制你自己的声音5-20s,录制完成点击使用。然后点击“立即开始”按钮。
2、源码部署(linux mac window)
要求 python 3.9->3.11, 并且提前安装好 git-cmd 工具,下载地址
创建空目录,比如 E:/clone-voice, 在这个目录下打开 cmd 窗口,方法是地址栏中输入 cmd, 然后回车。使用git拉取源码到当前目录 git clone git@github.com:jianchang512/clone-voice.git .
创建虚拟环境 python -m venv venv
激活环境,win下 E:/clone-voice/venv/scripts/activate,
安装依赖: pip install -r requirements.txt --no-deps, windows 和 linux 如果要启用cuda加速,继续执行 pip uninstall -y torch 卸载,然后执行pip install torch torchaudio --index-url https://download.pytorch.org/whl/cu121。(必须有N卡并且配置好CUDA环境)
win下解压 ffmpeg.7z,将其中的ffmpeg.exe和app.py在同一目录下, linux和mac 到 ffmpeg官网下载对应版本ffmpeg,解压其中的ffmpeg程序到根目录下,必须将可执行二进制文件 ffmpeg 和app.py放在同一目录下。
首先运行 python code_dev.py ,在提示同意协议时,输入 y,然后等待模型下载完毕。
下载模型需要挂全局代理,模型非常大,如果代理不够稳定可靠,可能会遇到很多错误,大部分的错误均是代理问题导致。
如果显示下载多个模型均成功了,但最后还是提示“Downloading WavLM model”错误,则需要修改库包文件 \venv\Lib\site-packages\aiohttp\client.py, 在大约535行附近,if proxy is not None: 上面一行添加你的代理地址,比如 proxy="http://127.0.0.1:10809".
下载完毕后,再启动 python app.py
应用场景展望
语音交互应用:对于语音助手、智能客服等语音交互产品的开发者来说,clone-voice可以帮助他们为产品赋予更加个性化、独特的声音特征,使其在众多同类产品中脱颖而出,提高用户的使用体验和产品的辨识度,增强用户与产品之间的情感连接。
技术的意义与挑战
clone-voice所代表的声音克隆技术的发展具有重要的意义。它为我们提供了一种全新的创作和娱乐方式,让每个人都能够轻松地拥有个性化的语音资源,丰富了数字内容的创作形式和表达手段.然而,与此同时,这项技术也带来了一些挑战和问题,例如可能会涉及到声音版权、隐私保护以及虚假信息传播等方面的风险. 因此,在享受声音克隆技术带来的便利和乐趣的同时,我们也需要关注和思考如何在技术发展与伦理道德、法律法规之间找到平衡,确保其合理、合法、安全地应用和发展。
