十万级热词也能稳住:面向工业落地的 LLM-ASR 上下文偏置方案

基于热词检索与强化学习的 LLM-ASR 上下文偏置新框架。 论文:Contextual Biasing for LLM-based ASR with Hotword Retrieval and Reinforcement Learning…
42 0 0

基于热词检索与强化学习的 LLM-ASR 上下文偏置新框架。 论文:Contextual Biasing for LLM-based ASR with Hotword Retrieval and Reinforcement Learning…
来源丨魔塔modelscope社区 近期,阶跃星辰发布了全球首个开源 LLM 级音频编辑大模型 —— Step-Audio-EditX。 该模型能够通过语言指令或迭代方式,精准控制音频的情感、说话风格和副语言特征,并实现零样本文本转语音(Z…
前言:今天arxiv发消息,CS板块不再接收未经同行评审的综述类文章,不好评论,只记得十年前,综述都是顶刊邀请,IEEE Fellow坐镇,再加上几个Senior,几年才有一篇,当宝贝一样来回读,近几年综述是挺多的。。。以后既然不再接收新的…
ICML(International Conference on Machine Learning)是机器学习领域的顶级学术会议之一,由国际机器学习学会(IMLS)主办,被中国计算机学会认定为A类会议。会议涵盖了机器学习的各个前沿方向,包括…
来源丨PaperWeekly 清华大学和智谱的研究团队推出了 LongBench 的第二代——LongBench v2,一个专为评估大模型在真实世界长文本多任务中的深度理解和推理能力而设计的基准测试。
近期,Meta开源了最新的Llama3.3-70B模型,这是Llama3.3系列目前唯一开源的模型。尽管该模型的参数规模仅仅700亿,但是在多项评测基准上已经超过了4050亿参数规模的Llama3.1-405B,后者是Llama系列模型中参…
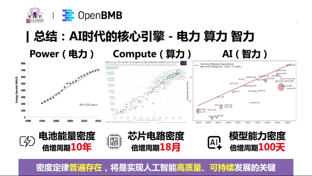
来源丨机器之心 支持大模型一路狂飙的 Scaling Law 到头了? 近期,AI 圈针对 Scaling Law 是否到头产生了分歧。一派观点认为 Scaling Law 已经「撞墙」了,另一派观点(如 OpenAI CEO Sam Al…
clone-voice是一款免费开源的声音克隆工具,它凭借先进的人工智能技术,能够分析和模拟人类声音的特征,从而实现高质量的声音克隆. 只需提供一段简短的音频样本,它就可以根据该样本生成与原始声音极其相似的克隆声音,并且支持多种语言,目前包…
Neural audio codecs (NACs) 已成为音频压缩和语音语言模型(SLM)表示的关键技术,近年来得到了极大的发展。 微软提出TS3-Codec,为codec模型设计提供了崭新的思路。它是首个完全基于 Transformer…
来源丨 Z Potentials 语音人工智能初创公司 ElevenLabs 近期推出了一项功能,允许用户上传不同类型的内容,创建一个多语音播客,类似于Google 的 NotebookLM。 该功能称为 GenFM,可以在公司的 Elev…