
 语音小管家
论文标题:Multi-modal and Multi-scale Spatial Environment Understanding for Immersive Visual Text-to-Speech
论文作者:刘瑞,何树伟,胡一帆,李海洲
单位:内蒙古大学,香港中文大学(深圳),新加坡国立大学
论文链接:https://arxiv.org/abs/2412.11409
0、Abstract
视觉文本到语音合成(Visual Text-to-Speech,VTTS)旨在利用环境图像作为提示,为说话内容合成与空间特性相匹配的混响语音。这一任务的主要难点在于如何准确理解图像中的空间环境信息。虽然目前已有不少研究尝试从图像的 RGB 空间中提取全局空间信息,但它们往往忽略了局部细节和深度信息这两个对空间环境理解至关重要的线索。为了解决这一问题,我们提出了一种名为 M2SE-VTTS 的全新多模态与多尺度空间环境理解框架,以实现沉浸式视觉文本到语音合成。多模态旨在融合空间图像的 RGB 和深度空间以学习更全面的空间信息,多尺度模块则致力于同时建模局部与全局的空间知识。具体而言,我们首先将 RGB 图像和深度图像划分为若干块,并利用 Gemini 生成的环境描述来引导局部空间的理解。随后,我们通过局部感知的全局空间理解方式,将多模态与多尺度特征有机结合。这使得 M2SE-VTTS 能够在多模态空间环境中有效地处理局部和全局空间信息之间的关联。实验结果表明,无论是在客观指标还是主观评估中,我们的模型在环境语音生成任务上都显著优于当前主流的基线方法。
代码和音频样例可以通过以下链接获取:https://github.com/AI-S2-Lab/M2SE-VTTS
1、Introduction
视觉文本到语音合成(Visual Text-to-Speech,VTTS)旨在通过环境图像作为提示,生成与说话内容相匹配的具有空间混响效果的语音。随着人机交互技术的进步,VTTS 已经成为智能系统中不可或缺的组成部分,尤其在增强现实 (AR) 和虚拟现实 (VR) 等领域发挥着重要作用 (Liu et al. 2023)。
与将输入语音转换为匹配参考声源环境条件的声学匹配任务不同 (Chen et al. 2022; Liu et al. 2023a; Somayazulu, Chen, and Grauman 2024; Im and Nam 2024),VTTS 旨在基于给定的文本内容合成具有参考环境特征的语音 (He, Liu, and Li 2024)。例如,Lee et al. (2024) 利用预训练的 CLAP 模型将文本或音频描述映射到环境特征向量,该向量控制生成音频的混响效果。Tan, Zhang, and Lee (2022) 设计了一个环境嵌入提取器,从参考语音中学习环境特征。在最近的研究中,Liu et al. (2023b) 提出了一种基于 Transformer 的视觉文本编码器,从 RGB 图像中学习全局空间视觉信息。在这些研究进展的基础上,本文着重探讨如何利用视觉信息作为线索,为特定场景生成混响音频。
然而,由于忽略了局部和深度图像信息,以往的 VTTS 方法未能充分理解空间环境。例如,空间环境中的局部元素会直接影响混响效果。具体来说,诸如桌子之类的硬表面会反射声波,而诸如地毯之类的较软材料会吸收声波,从而直接影响音频的真实感和自然度 (Chen et al. 2023, 2022; Liu et al. 2023b)。此外,图像的深度信息包含了空间环境内的位置关系 (Majumder et al. 2022; Chen et al. 2023),例如物体的排列、说话者的位置以及房间的几何结构。因此,对于 VTTS 系统而言,同时准确捕获局部和深度空间环境信息至关重要。
为了解决上述问题,我们提出了一种新颖的多模态、多尺度空间环境理解方案,以实现沉浸式 VTTS,命名为 M2SE-VTTS。多模态是指同时利用空间图像的 RGB 和深度信息,以学习更全面的空间信息,例如说话者的位置以及影响声音吸收和反射的关键物体的位置。多尺度是指建模局部和全局空间知识对混响的影响。具体而言,我们首先按照视觉 Transformer 的策略 [Dosovitskiy et al. 2021] 将 RGB 和深度图像分割成图像块。此外,我们采用 Gemini 生成的 [Team et al. 2024] 环境描述,基于识别机制来引导局部空间理解。之后,局部感知全局空间理解模块将多模态和多尺度特征作为输入,并逐步整合空间环境知识。通过这种方式,M2SE-VTTS 有效地建模了多模态空间环境中局部和全局空间上下文之间的相互关系。
本文的主要贡献包括:
我们提出了一种新颖的多模态、多尺度空间环境理解框架,称为 M2SE-VTTS,它利用 RGB 和深度信息来增强沉浸式混响语音的合成。
我们的方法全面整合了局部和全局空间元素,从而更全面地理解空间环境,这对于准确建模环境混响至关重要。
客观和主观实验评估表明,我们的模型在生成环境语音方面明显优于所有现有的最先进基准模型。
2、Related Works
2.1、Spatial Environment Understanding
空间环境理解在空间认知中扮演着至关重要的角色,尤其是在复杂的三维场景中,准确理解空间信息对于机器人导航、增强现实和自动驾驶等应用至关重要。在视觉领域,研究人员通常采用多模态和多尺度的方法来更全面地捕获和分析空间信息 (Chen et al. 2020; Guo et al. 2022; Jain et al. 2023; Jiang et al. 2024; Xu et al. 2024; Wang et al. 2024)。例如,SpatialRGPT (Cheng et al. 2024a) 通过引入数据管理流程和一个插件模块来增强视觉语言模型 (VLM),该模块通过整合深度信息并从 3D 场景图中学习局部特征来提高对 3D 空间关系的理解。Scene-LLM (Fu et al. 2024) 通过整合 3D 视觉数据进一步扩展了语言模型的功能,提升了具身智能体在交互式 3D 环境中的推理和决策能力。这种方法在密集标注和交互式规划等任务中表现出特别的优势。类似地,AFNet (Cheng et al. 2024b) 提出了一种融合单视图和多视图深度估计的方法,解决了自动驾驶中深度估计的难题,并在纹理稀疏和存在动态物体的场景中表现出强大的鲁棒性。这些研究表明,多模态和多尺度方法对于提升对空间环境的全面理解至关重要,因为它们有效地整合了来自不同来源的信息,从而增强了在复杂环境中的空间推理能力。
尽管这些研究在提升 VLM 的空间理解能力方面取得了显著进展,但它们主要侧重于提取全局空间信息,往往忽略了局部和深度信息的重要性。我们的工作与这些方法在几个关键方面有所不同:(1) 我们专注于视觉 VTTS 任务,而不仅仅是视觉空间推理;(2) 与以往的研究不同,我们强调整合局部和深度图像信息,以及来自 RGB 图像的全局空间数据,以实现对空间环境更全面的理解。这些差异使得我们的方法能够更好地应对 VTTS 任务的独特挑战,并在复杂的空间环境中表现出色。
2.2、LLM-based Image Understanding
近年来,利用大语言模型 (LLM) 进行图像理解已成为计算机视觉和自然语言处理领域一个重要的研究方向。通过将 LLM 强大的自然语言处理能力与视觉信息相结合,研究人员开发了多模态大语言模型 (MLLM) 来解决视觉问答、图像描述和图像理解等复杂任务 (Zhang et al. 2024; Zhu, Wei, and Lu 2024)。例如,Flamingo (Karthik et al. 2024) 开创性地将预训练的视觉编码器与语言模型结合,利用 Perceiver Resampler 模块从图像中提取特征以生成文本描述,从而实现跨模态的图像-文本对齐。在此基础上,BLIP-2 (Swetha et al. 2024) 引入了一个查询 Transformer (Q-Former),通过跨模态融合提取最相关的视觉特征,增强了模型的视觉理解能力。Shikra (Chowdhury et al. 2024) 通过整合空间坐标信息进一步推进了相关研究,从而提高了多模态模型在物体定位和视觉推理方面的能力。然而,这些方法主要侧重于捕获全局视觉特征,虽然在许多情况下有效,但在处理需要细粒度视觉理解的任务时会表现出局限性。为了应对这一挑战,X-Former 模型提出了一种新颖的方法,将对比学习 (CL) 与掩码图像建模 (MIM) 相结合,整合了来自 CLIP-ViT (Radford et al. 2021) 和 MAE-ViT 视觉编码器的特征。X-Former 使用双重交叉注意力机制来对齐视觉和语言特征,在物体计数和细粒度类别识别等细粒度视觉任务中表现出卓越的性能。相比之下,传统的多模态模型由于捕获局部细节的能力有限,通常难以处理这些任务。
虽然这些方法显著提高了多模态视觉理解的能力,但在应用于特定的空间环境感知任务时仍然存在局限性。我们的工作提出了一种新颖的多模态、多尺度空间环境理解方案,旨在克服现有模型在捕获局部和深度信息方面的不足。与以往的方法不同,我们的方法整合了 RGB 和深度信息,并利用 Gemini 生成的环境描述来指导局部空间理解。通过融合多模态和多尺度特征,我们的方法能够更全面地建模空间环境,为 VTTS 任务提供强有力的支持,尤其是在理解复杂场景的空间布局和环境特征方面。
3、Methodology
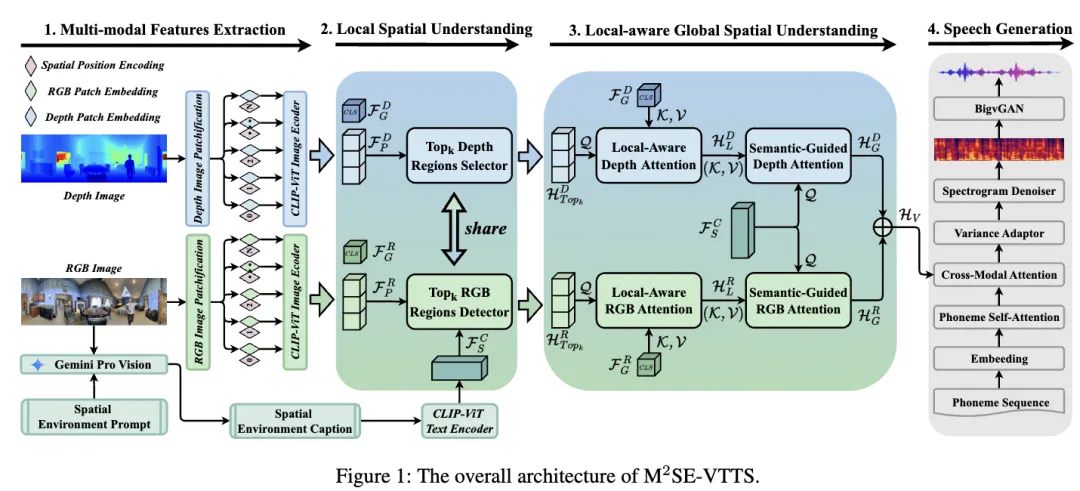
如图 1 的流程图所示,我们提出的 M2SE-VTTS 模型由四个主要部分构成:1) 多模态特征提取;2) 局部空间理解;3) 局部感知的全局空间理解;以及 4) 语音生成。正如前面提到的,多模态特征,包括图像的 RGB 和深度空间表示,能够提供关于空间环境更为全面的信息。为了理解局部和全局空间上下文之间的相互作用,局部感知全局空间理解模块通过整合了多模态和多尺度的知识理解局部和全局空间上下文之间的相互作用。接下来的小节将详细介绍这些组件的设计和训练过程。
3.1、Multi-modal Features Extraction
3.2、Local Spatial Understanding
3.2.1 LLM-based Spatial Semantic Understanding
为了捕获丰富的空间信息,包括物体的空间位置、它们的排列以及整体场景结构,我们利用 Gemini 先进的多模态理解能力,将复杂的视觉数据转换为结构化的文本描述。这种方法使我们能够准确地提取和表示图像中蕴含的空间语义信息。
3.2.2 TopkRGB Regions Detector
3.2.3 TopkDepth Regions Detector
3.3、Local-aware Global Spatial Understanding
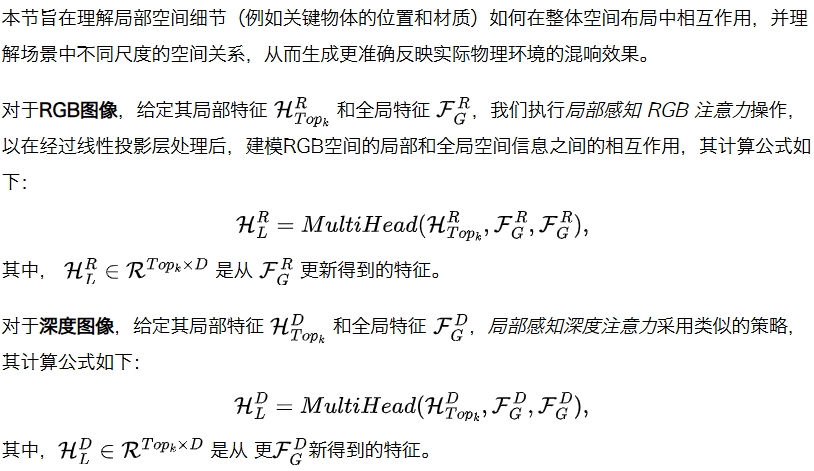
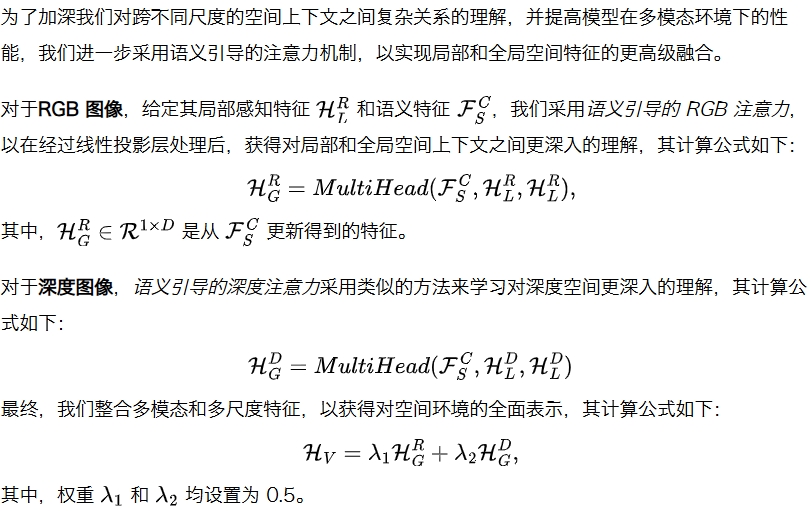
如图1的第三部分所示,局部感知全局空间理解模块旨在有效地建模局部语义信息与全局空间上下文之间的相互作用,它包含两个部分:1) 局部感知 RGB/深度注意力,该部分侧重于学习局部细节与全局空间特征之间的相互作用;2) 语义引导的 RGB/深度注意力,该部分通过将语义信息与局部感知全局特征相融合,增强对空间上下文的理解。
3.3.1 Local-aware RGB/Depth Attention
3.3.2 Semantic-Guided RGB/Depth Attention
3.4、Speech Generation
如图1所示,我们采用 ViT-TTS 作为我们文本到语音 (TTS) 系统的骨干网络。首先,将音素嵌入和视觉特征转换为隐藏序列。此外,方差适配器预测每个隐藏序列的持续时间,以调整隐藏序列的长度,使其与语音帧的长度相匹配。然后,按照Renet al. (2021) 的方法,将不同的方差信息(如音高和说话者嵌入)融入到隐藏序列中。之后,频谱图去噪器迭代地将长度调整后的隐藏状态细化为梅尔频谱图。最后,BigVGAN (Lee et al. 2022) 将梅尔频谱图转换为波形。有关更多详细信息,请参考 ViT-TTS(Liu et al. 2023b)。
4、Experiments and Results
4.1、Dataset
我们使用了 SoundSpaces-Speech 数据集 (Chen et al.2023),该数据集基于 SoundSpaces 平台,利用真实世界的 3D 扫描数据来模拟环境音频。为了提升数据集的质量,我们参照 Chen et al. (2022); Liu et al. (2023b) 中描述的方法进行了改进。具体来说,我们排除了视野外的样本,并将剩余的数据划分为两个子集:test-unseen 和 test-seen。其中,test-unseen 子集包含来自新场景图像的房间声学数据,而 test-seen 子集则包含在训练过程中已经见过的场景。整个数据集包含 28,853 个训练样本、1,441 个验证样本以及 1,489 个测试样本。每个样本都包含干净的文本、混响音频以及全景相机拍摄的 RGB-D 图像。为了预处理文本数据,我们使用一个开源的字素到音素转换工具(https://github.com/Kyubyong/g2p)将文本序列转换为音素序列。
为了与常见的实践保持一致 (Ren et al. 2019; Huang et al. 2022; Liu et al. 2024b,a),我们分三个步骤预处理语音数据。首先,我们提取频谱图,设置 FFT 大小为 1024,跳跃大小为 256,窗口大小为 1024 个样本。然后,我们将频谱图转换为具有 80 个频率箱的梅尔频谱图。最后,我们使用 Parselmouth 工具 (https://github.com/YannickJadoul/Parselmouth)从原始波形中提取 F0(基频)。这些预处理步骤确保了与先前研究的一致性,并为后续的模型训练做好了数据准备。
4.2、Implementation Details
在视觉模态方面,我们采用预训练的 CLIP-ViT-L/14 模型作为视觉特征提取器。该模型为每个视觉片段生成全局和图像块级别的 768 维特征向量。这些视觉特征经过线性变换后,与音素嵌入的 512 维隐藏空间对齐。音素词汇表包含 74 个不同的音素。跨模态融合模块使用两个注意力头,而所有其他注意力机制均使用四个注意力头。图像块的数量 Top
整个训练过程分为两个阶段。在预训练阶段,我们采用了 ViT-TTS(Liu et al. 2023b)中的编码器预训练策略,训练编码器 12 万步直至收敛。在主训练阶段,M
4.3、Evaluation Metrics
我们使用客观指标和主观指标来评估生成波形的质量。客观指标旨在通过比较真实音频和生成的音频样本,从多个角度评估波形的质量。为了与 Liu et al. (2022); Huang et al. (2022) 中的常见做法保持一致,我们从测试集中随机选取 50 个样本进行客观评估。我们主要采用以下三个指标:
(1)感知质量:该指标通过人类听众的平均意见得分(MOS)来评估。一组听众对音频的质量、自然度以及与对应图像的匹配程度进行评估,评分范围从 1(差)到 5(优秀)。最终的 MOS 分数为所有评分的平均值。
(2)房间声学(RT60 误差):RT60 指的是音频信号衰减 60 分贝所需的混响时间,以秒为单位,这是一个用于描述房间声学特性的标准指标。为了计算 RT60 误差(RTE),我们使用 Chen et al. (2022) 提供的预训练 RT60 估计器,从输出音频的幅度频谱图中估计 RT60 值。由于目标环境的脉冲响应不可用,因此必须采用这种方法。
(3)梅尔倒谱失真(MCD):MCD 用于量化合成的梅尔频谱图特征与参考梅尔频谱图特征之间的频谱距离。它被广泛用作音频质量的客观衡量标准,尤其是在语音合成任务中。较低的 MCD 值表示生成的音频与真实音频之间具有较高的频谱相似性。
每个指标都从不同的角度反映了生成波形的质量,从而可以对系统的性能进行全面的评估。
4.4、Baselines
为了验证我们提出的 M
ProDiff (Huang et al. 2022):第一个基线系统是一个为高质量语音合成设计的渐进式快速扩散模型。该模型以文本为输入,直接预测干净的梅尔频谱图,从而显著减少了所需的采样迭代次数。 DiffSpeech (Liu et al. 2022):该方法是一个采用扩散概率方法的 TTS 模型。该模型以文本为输入,通过迭代的方式将噪声转化为以文本为条件的梅尔频谱图,从而确保训练的稳定性和输出的高质量。 VoiceLDM (Lee et al. 2024):第三个基线系统是一个以文本为主要输入的 TTS 模型。该模型能够有效地从描述性提示中捕获全局环境上下文,从而生成与内容和整体情境描述相符的音频。考虑到训练数据集中环境文本描述的差异——原始数据集主要描述环境的类型,而我们的数据集则强调具体的组成部分及其空间关系——我们选择重点关注该模型在代码复现过程中,如何利用文本描述来指导混响语音合成的创新方法。 ViT-TTS-ResNet18 (Liu et al. 2023b):第四个基线系统是一个 VTTS 模型,它同时将文本和环境图像作为输入。该模型利用 ResNet18 [He et al. 2016] 从图像中提取全局视觉特征,并通过捕获房间的声学特性来增强音频的生成。 ViT-TTS-CLIP (Liu et al. 2023b):最后一个基线系统也是一个 ViT-TTS 模型,它使用 CLIP-ViT 作为全局 RGB 特征提取器。
4.5、Main Results
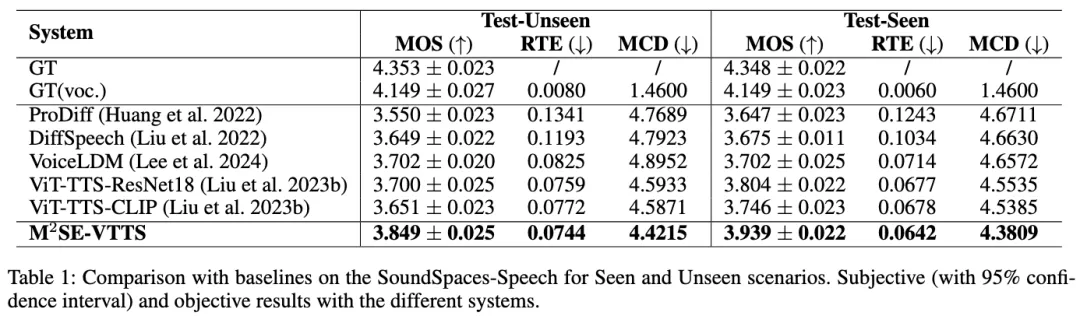
如表 1 所示,M
总而言之,我们的综合评估结果证明了我们提出的方案在生成与目标环境相匹配的混响语音方面的有效性。
4.6、Ablation Results
为了评估模型中几个关键技术在 Test-Unseen 数据集上的独立效果,包括 RGB 空间 (RGB)、深度空间 (Depth)、基于 Gemini 的空间语义理解 (LLM)、局部空间理解 (LSU)、局部感知交互 (LGSU-L) 以及全局知识交互 (LGSU-G),我们移除了这些组件并构建了不同的系统。我们进行了一系列的消融实验,其主观和客观结果如表 2 所示。
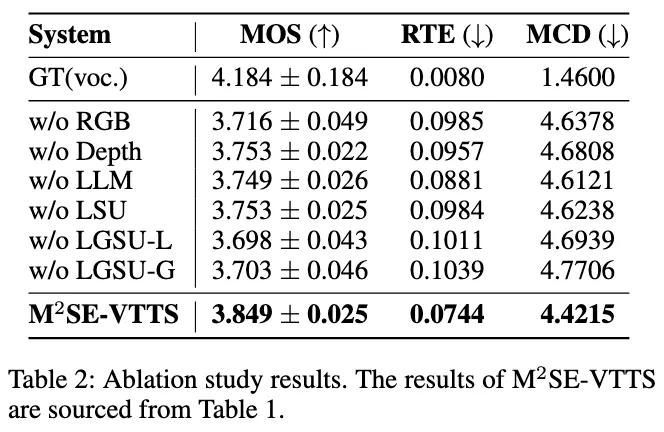
我们发现,在多模态特征提取阶段移除不同类型的模态信息(w/o RGB 和 w/o Depth)会导致大多数客观指标的性能下降,并且主观 MOS 分数也随之降低。这表明,我们的多模态策略能够学习到更全面的空间信息,并增强混响效果的表现力。
此外,为了验证基于 Gemini 的空间语义理解 (LLM) 的有效性,我们移除了该组件 (w/o LLM)。如表 2 所示,移除语义理解组件会导致所有主观和客观指标的下降。这表明,通过 Gemini 对空间图像进行语义分析,我们的模型能够更准确地表示混响效果。
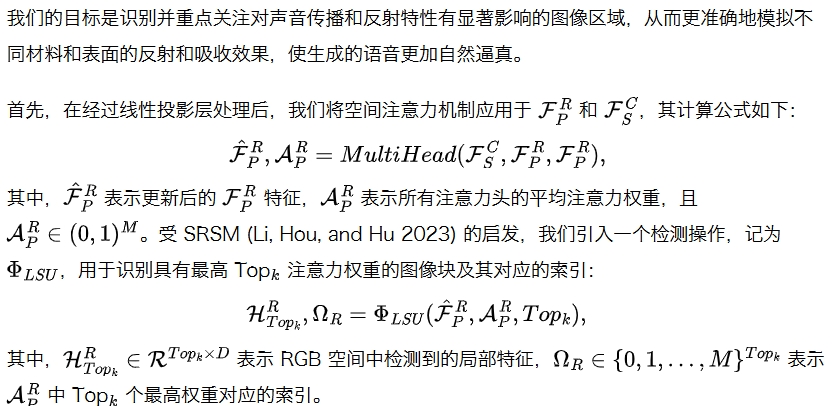
然后,我们还进一步研究了 RGB/深度图像的 Topk 区域选择 (w/o LSU) 的影响。省略这些关键区域会导致主观和客观指标的双重下降。这表明,通过识别重要的语义信息,模型能够准确地理解空间环境,并提高混响的风格和质量。
最后,我们移除了局部感知全局空间理解模块中的局部语义信息 (w/o LGSU-L) 和全局上下文信息 (w/o LGSU-G)。这种移除操作导致主观和客观指标的性能均有所下降,这突显了我们的多模态和多尺度方法在建模局部和全局空间上下文之间的相互作用以产生混响方面的有效性。
4.7、TopkIndex Sharing Comparative Study
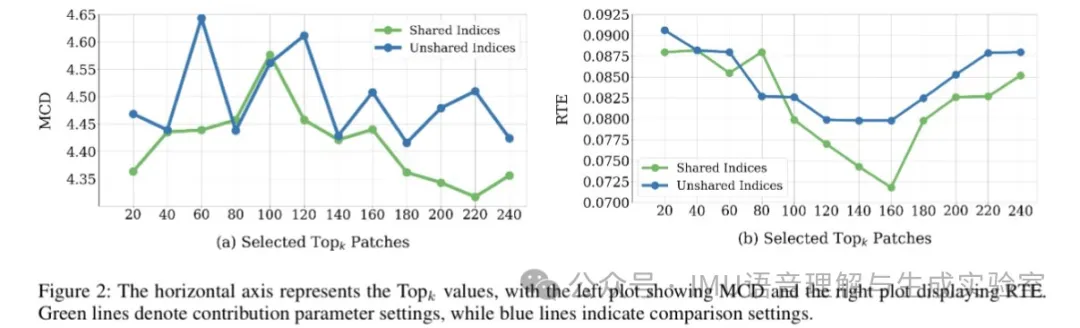
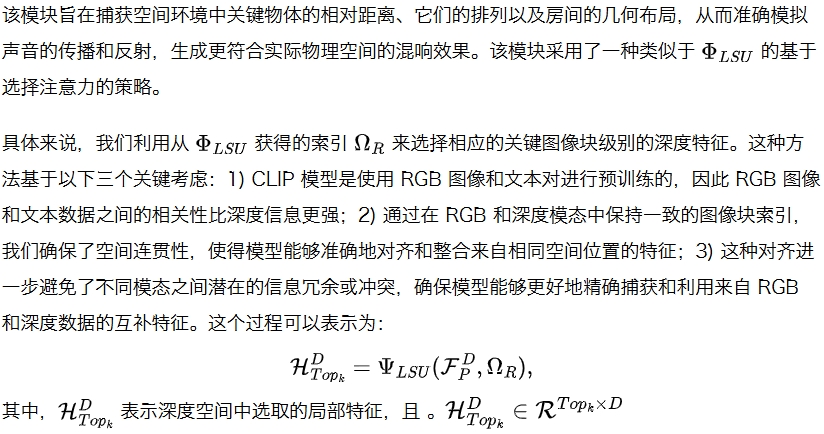
在共享索引策略中,来自 RGB 图像的 Top
实验结果表明,对于所有测试的 Top
通过对比不同的策略,我们证实了来自 RGB 图像的共享 Top
5、Conclusions
本文提出了一种名为 M2SE-VTTS 的创新方法,该方法采用多模态和多尺度的策略进行视觉文本到语音 (VTTS) 合成。我们的方法通过整合 RGB 和深度图像,实现了对空间环境的全面表示,从而克服了以往 VTTS 系统在空间理解方面的局限性。这种全面的空间表示包括对局部和全局空间上下文进行建模,这对于捕捉影响语音混响的环境细微差别至关重要。通过结合环境描述引导的局部空间理解和局部感知全局空间建模,M2SE-VTTS 有效地捕捉了不同空间尺度之间的相互作用,这对于准确的混响建模至关重要。评估结果表明,我们的模型在生成环境语音方面始终优于最先进的基准模型,为 VTTS 中的环境语音合成树立了新的标准。
尽管取得了这些进展,M2SE-VTTS 框架仍然存在一些局限性,例如多模态和多尺度特征集成导致计算复杂度增加,这可能会阻碍其在实时应用中的使用。此外,该模型在未见环境中的性能表现不稳定,这突显了提高模型泛化能力的必要性。未来的研究应侧重于优化计算效率,并增强模型对未见空间上下文的适应性。
(论文翻译:23级硕士研究生 何树伟,导师:刘瑞研究员)
