
 语音小管家
太离谱了,这两天被外网网友的一个「假格莱美」颁奖视频骗到了。
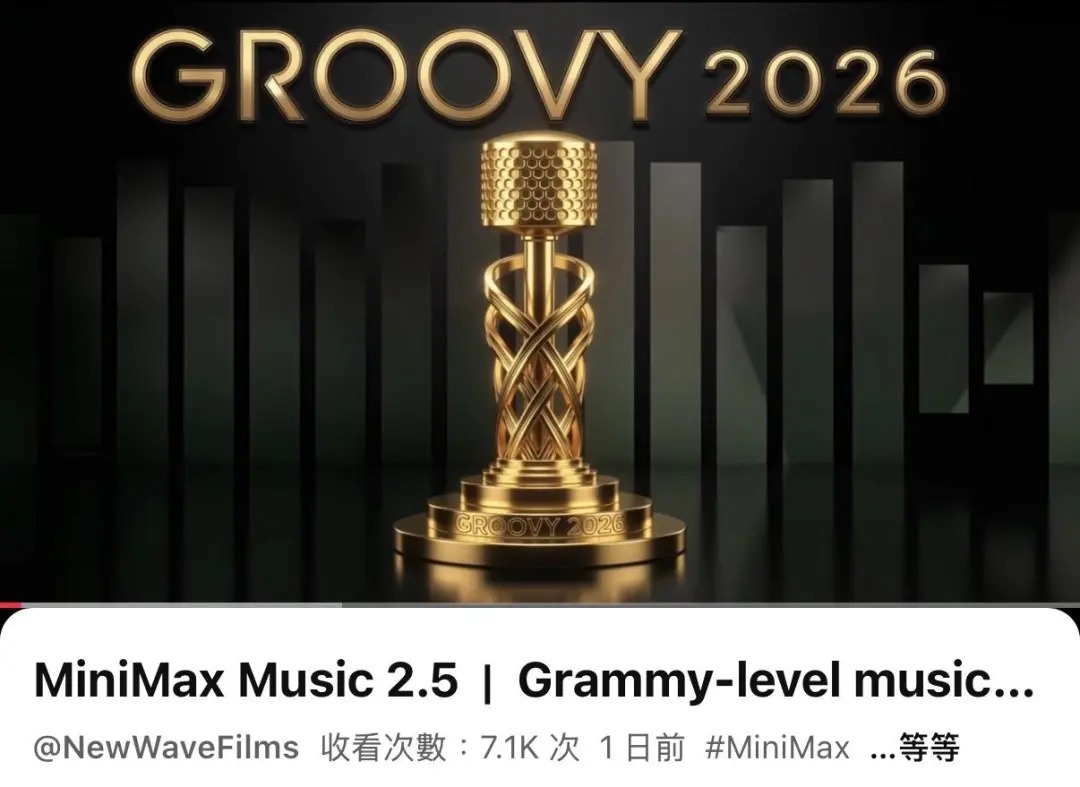 我不说你应该也没发现是「AI 界的格莱美」吧。
高度拟真的人声和对风格的精准拿捏,简直就是「以假乱真」。
你听那个叫 Aria Grane 的虚拟歌手,在演唱《Skin Remembers》时,换气瞬间声带的闭合与颤动,保留了顶级录音室才有的「人类瑕疵」;
镜头切到酷似「盆栽哥」的男声时,那股迷幻放克的假声味道,完全就是巨星未公开新单曲的水准。
最荒谬的是,如果不看屏幕下方的水印,我都不会发现这些这么懂欧美 R&B 和流行听感的 AI 音乐作品,竟然全部都来自一个中国模型:MiniMax Music 2.5。
2026开年,中国 AI 给音乐圈带来了诸多史诗级轰炸。
昨天 Mureka 刚推出 V8,今天,MiniMax Music 2.5 就直接甩出了这个「格莱美级别」的核弹,不仅是像,更是「懂」,当之无愧的 AI 音乐新王。
「格莱美时刻」所言非虚,这两个月,AI 乡村乐队「Breaking Rust」屠榜,作为唱片巨头的环球音乐、华纳音乐纷纷「打不过就加入」,躬身入局 AI。
在这个全球音乐行业都意识到,AI 音乐早已跨过了「听个响」的图灵测试的时间节点,MiniMax 用最新的杀手锏 Music 2.5 向世界宣告:
懂中文、懂音乐、更懂「人性」的 AI,还得看我们中国公司。
MiniMax Music 2.5 的这个 Demo 视频,高级感十足,让我们对它的实际性能充满期待。
API 接口:platform.minimaxi.com/docs/api-reference/music-generation
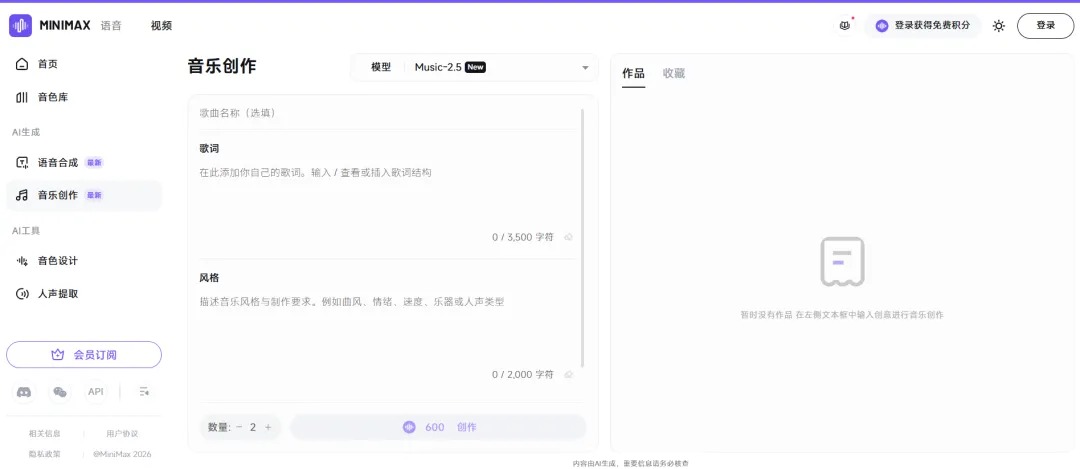
第一轮检验:「格莱美级音质」的关键
近乎呼吸的拟人质感
为了验证 Music 2.5 的全新「格莱美级音质」,我们没有选择容易讨巧的电音来测试,而是选择了一块最难啃的骨头:Soul/R&B。
这类音乐不吃编曲的华丽,全靠歌手嗓音里的颗粒感和情绪的微动态。
给 Music 2.5 输入一段压抑、痛苦的英文歌词,要求生成一首能在深夜把人听哭的金曲。
如果说之前的 AI 是在模仿「唱歌」,那 Music 2.5 这一段就是在模仿「声带的物理振动」。
最让人头皮发麻的不是高音的完美,而是那些「瑕疵」。
你能在耳机里清晰地捕捉到歌手换气时的急促,尾音处理上因为「力竭」而产生的轻微断裂,甚至在一句歌词结束后,那一声似有若无的叹息。
你能听到情绪像潮水一样,从主歌的低回叙事,推向副歌的撕裂爆发。
这种动态范围,过去需要顶级录音棚配合百万级混音师才能打磨出来,现在,它只是算力的一次瞬时释放。
它证明了一件事:AI 终于理解了,音乐的感染力往往不来自于精密的准确,而来自于那些充满了人性的「不完美」。
人人都是制作人的时代
MiniMax Music 2.5 的发布不仅补齐了其多模态生态的关键拼图,更标志着 AI 音频从「C 端娱乐」正式跨越到「B 端生产力」。
影视、游戏及工业级交付标准,直击内容创作中「有画难配声」的痛点;
对于极度依赖 BGM 的短剧、游戏和自媒体行业而言,这不再仅仅是一个好玩的生成工具,而是一座巨大的、无版权风险的「露天金矿」,让专业级的叙事配乐触手可及。
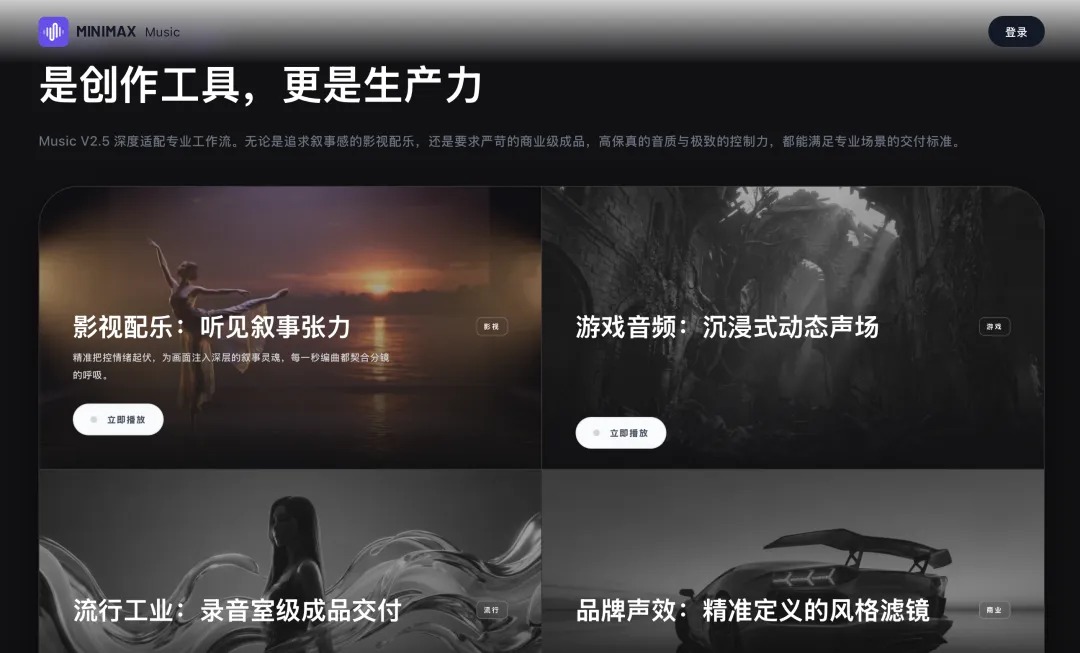
当「格莱美级」的制作能力被封装成 API,当「百万调音师」变成了一行代码,音乐制作的门槛被彻底踩平。
这或许会让传统的音乐人感到一丝寒意,但也可能激发出前所未有的创造力浪潮。
正如摄影术的发明没有杀死绘画,反而催生了印象派一样;AI 不会杀死音乐,它只是逼迫我们去寻找那些机器无法计算的、灵魂深处最隐秘的共鸣。
现在,控制台就在你手边,麦克风已经递到了你面前。
你想听什么样的歌?不用去搜了,自己做吧!
参考资料:
