
 语音小管家
在传统语音生成中,表达方式往往依赖预设标签,例如:
固定情绪选项
预定义语气类别
限定风格模板
用户只能在有限选项中选择,而难以进行更自由、细腻的表达控制。
FreeStyle 新范式的核心突破在于
不再依赖固定标签,而是支持通过自然语言指令直接描述想要的表达方式。
通义实验室语音团队正式发布两款支持 FreeStyle 指令生成的模型 Fun-CosyVoice3.5 与 Fun-AudioGen-VD。无论是精细控制声音表达,还是从零设计音色与场景,都可以通过自然语言指令直接生成。
两款模型均支持通过自然语言指令控制语音生成,但应用方向不同:
Fun-CosyVoice3.5:多语种复刻 + 精细化表达控制
Fun-AudioGen-VD:声音设计 + 场景化音频生成
01、支持 FreeStyle 指令控制
CosyVoice3.5 在 Instruct-TTS 方向实现能力升级,支持 FreeStyle 指令控制生成效果,一句话自由生成语音。
你可以直接用自然语言描述表达方式,例如:“语气坚定一点”、“稍微压低音调,语速慢一点”、“带一点情绪起伏”......模型即可理解并生成相应表达。
02、多语种扩展:新增 4 个小语种
新增支持:泰语、印尼语、葡萄牙语、越南语。同时在 13 种语言的 WER 和 SpkSim 客观指标上保持业内领先。
03、发音准确性显著提升
针对生僻字、复杂语句等容易读错的场景专项优化,生僻字读错率从 15.2% 降至 5.3%,复杂文本表现更加稳定,长文本朗读也更稳定流畅。
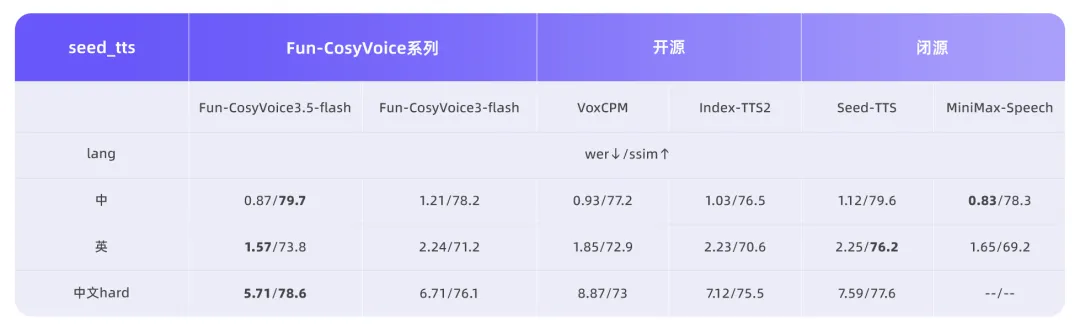
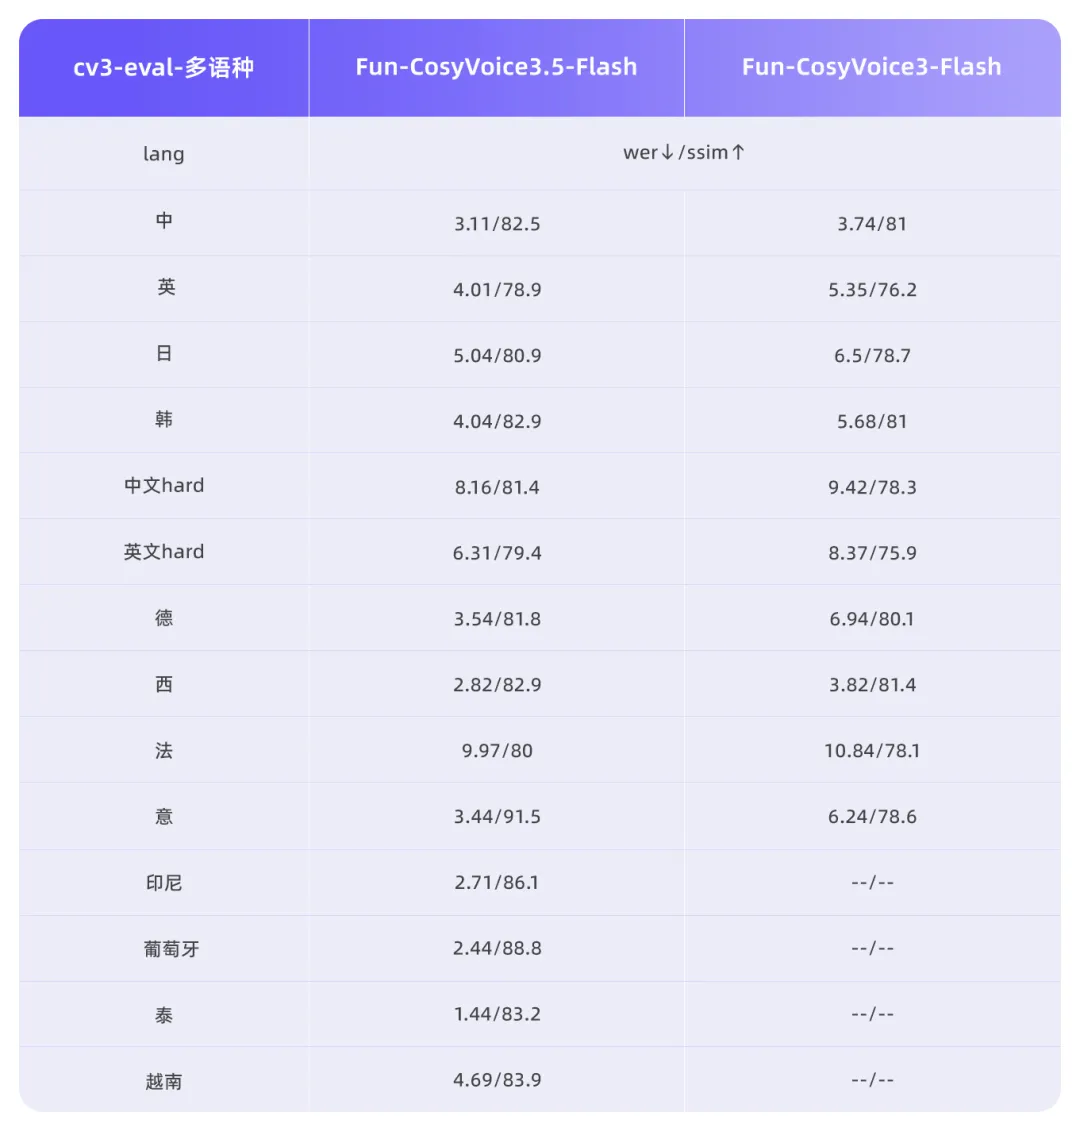
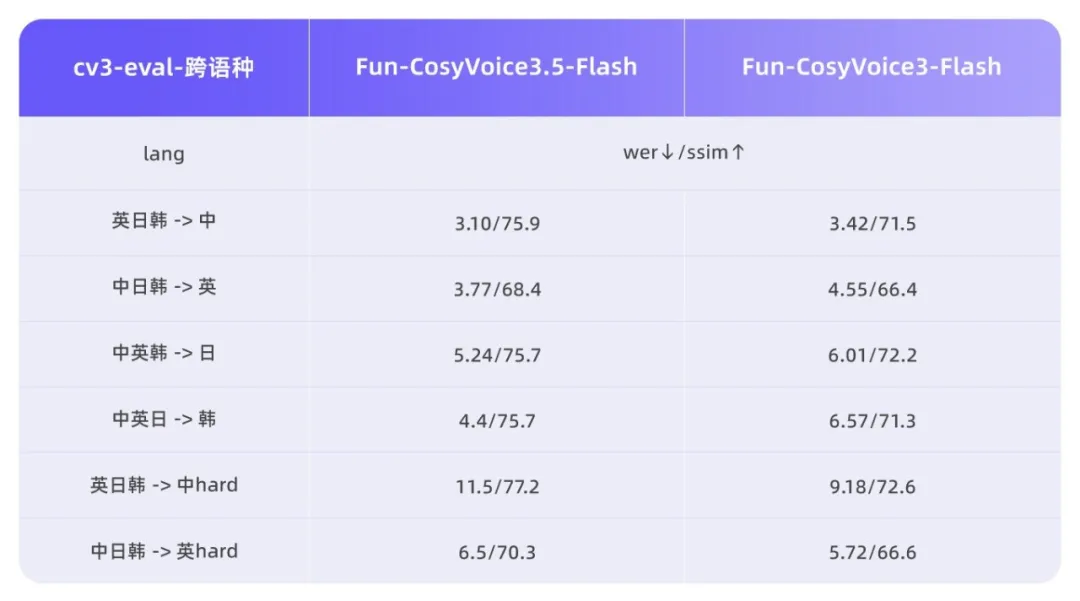
04、韵律与音质优化
通过强化学习技术专项调优,双重提升听感,使整体听感更加自然,表达更有层次。
语言模型部分使用 DiffRO + GRPO,增加时长与韵律多通道 reward,韵律表现明显提升。
Flow Matching(音频生成)使用 Flow-GRPO,复刻相似度和音质进一步提升。
05、性能优化:更低延迟
Tokenizer 帧率减半
首包延迟降低 35%
在实时交互场景下响应更快,体验更流畅。
如果说 Fun-CosyVoice3.5 解决的是“如何更好地表达”,
那么 Fun-AudioGen-VD 解决的是——声音如何被设计。
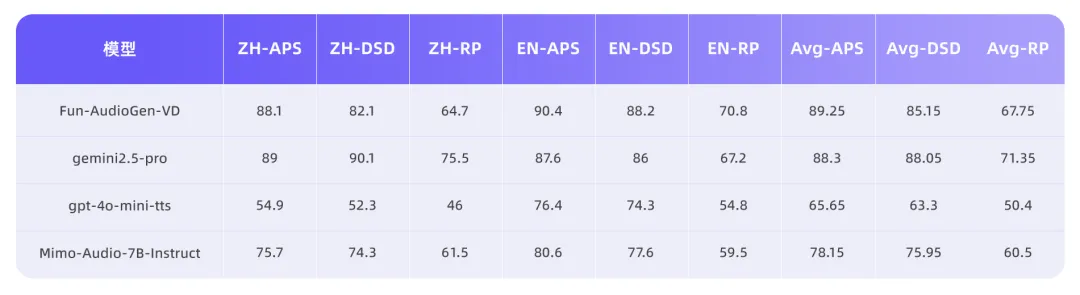
Fun-AudioGen-VD 支持根据自然语言描述,生成目标音色、情绪表达和完整听觉场景,实现“人物 + 场景”的一体化声音生成。01、可控音色与角色化生成
支持通过指令精细化控制声音特征
基础属性:性别、年龄、口音、音高、语速
音质特征:沙哑、清亮、低沉、磁性......
情绪表达:愤怒、悲伤、兴奋、坚定......
角色模拟:客服、老兵、孩童、AI、播音员......
复杂心理:支持细腻状态表达(如“表面镇定但内心颤抖”)
02、环境与空间声学模拟
背景环境音:叠加城市喧嚣、咖啡馆背景、战场轰鸣等环境音; 空间混响效果:模拟大教堂、金属牢房、水下等空间回声; 设备听感滤镜:还原老式广播、对讲机、呼吸面罩等特殊音质; 动态环境互动:支持风噪断续、回声变化、嘶哑效果等实时互动。
在影视动画、游戏、有声书及 AI 角色等场景中,创作者可通过自然语言快速定义音色、情绪与场景,大幅降低录制与调试成本,提升内容沉浸感。此外,Fun-AudioGen-VD 还能生成高质量参考音频,为声音复刻提供更丰富的素材基础。
这并非简单增加几个可选标签,而是让语音生成真正进入「自然语言控制表达」的阶段:
Fun-CosyVoice3.5:专注于复刻与表达控制,让声音更自然、更听话。
Fun-AudioGen-VD:拓展了音色与场景的一体化设计,让声音从无到有被创造。
当语音可以被描述、被理解、被精准生成,声音创作将不再受限于模板与标签,而成为一种可编排、可塑造的数字表达能力。
