
 语音小管家
Music v2 这次强化了快速 Rap 和复杂人声的生成能力。过去很多 AI 音乐模型在处理高密度歌词、快速押韵和复杂节奏时,很容易出现吃字、节奏漂移、发音混乱等问题。因为 Rap 本质上不只是旋律生成,而是语言、节奏和时间结构的联合控制。模型不仅要理解歌词,还要把每个音节准确地放进节拍里。
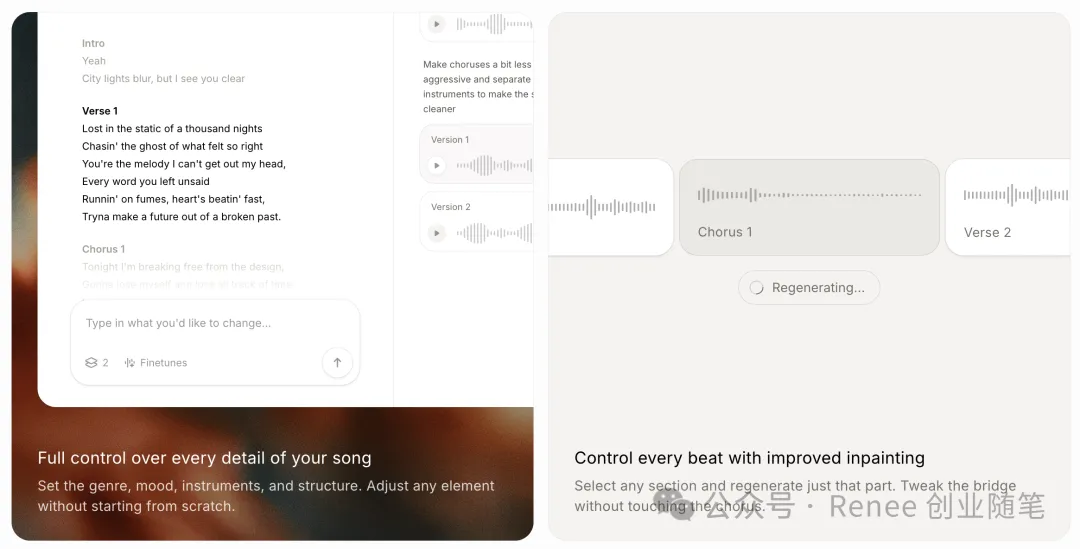
另一个很重要的更新是风格切换。Music v2 可以让一首连续的歌曲从 opera 切换到 heavy metal,再切回来,而且不需要手动拼接。这说明模型开始具备更强的长程结构控制能力。真正的音乐创作难点从来不只是生成一个好听的片段,而是让整首歌在情绪、节奏、主题和风格变化上保持连贯。
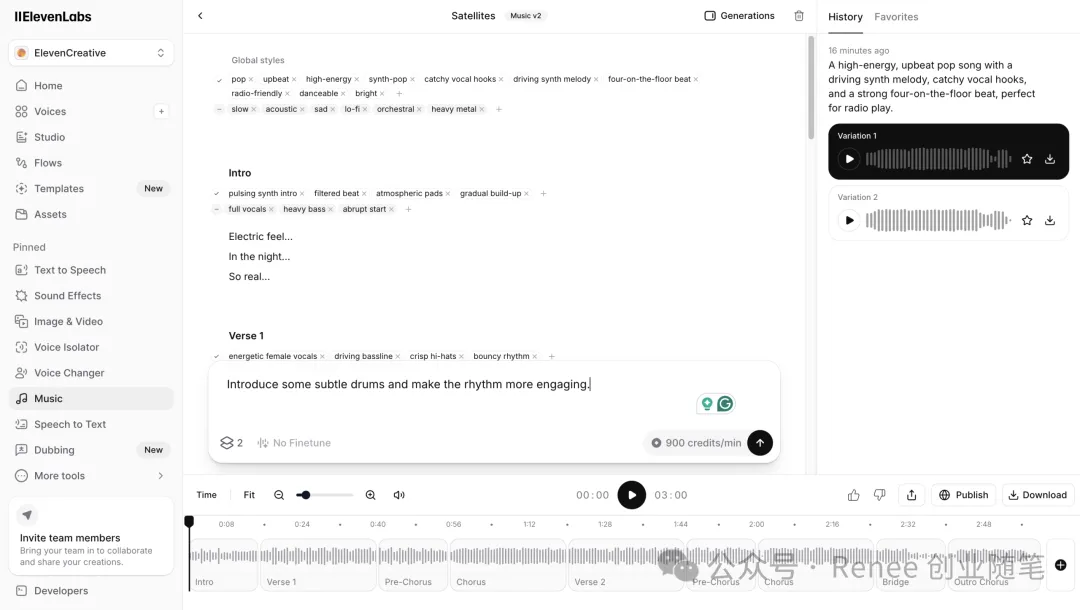
我觉得最值得关注的是 improved inpainting。现在用户可以选中一首歌里的某一段,只重新生成这一部分,而不影响其他部分。比如只修改 chorus、重做 bridge,或者微调某一段 vocal。这个能力很关键,因为真实创作很少是一次生成完美结果,更多是不断局部修改、反复试错。
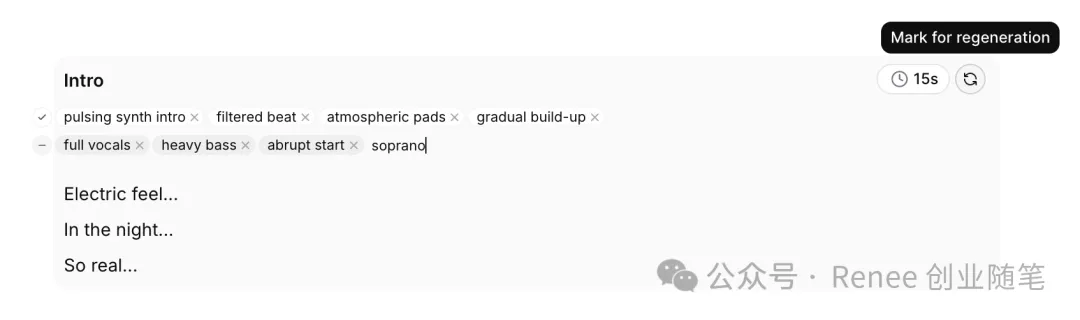
所以这次 Music v2 的意义不只是“音乐质量更好了”,而是 AI 音乐工具开始更接近真实创作流程。生成只是第一步,后面更重要的是编辑、控制和迭代。
ElevenLabs 也越来越不像一家单纯的 TTS 公司,而是在往完整的 Audio Foundation Model 平台发展。从 voice、conversational AI、real-time audio,到 sound generation 和 music generation,它正在把 AI 音频的不同能力逐渐串起来。
