
 语音小管家
模型不再把语音、音效、声音事件等音频元素拆成独立任务。它在同一条时间轴上同时生成这些元素,自动协调响度、节奏与情绪走向,一次输出即可使用的成品音轨。
但统一生成并不意味着牺牲单项质量——在语音相似度、AudioBox等多项基准评测中,Qwen-Audio-3.0-Gen-Preview 各项指标均全面领先。
语音相似度三项指标均列第一
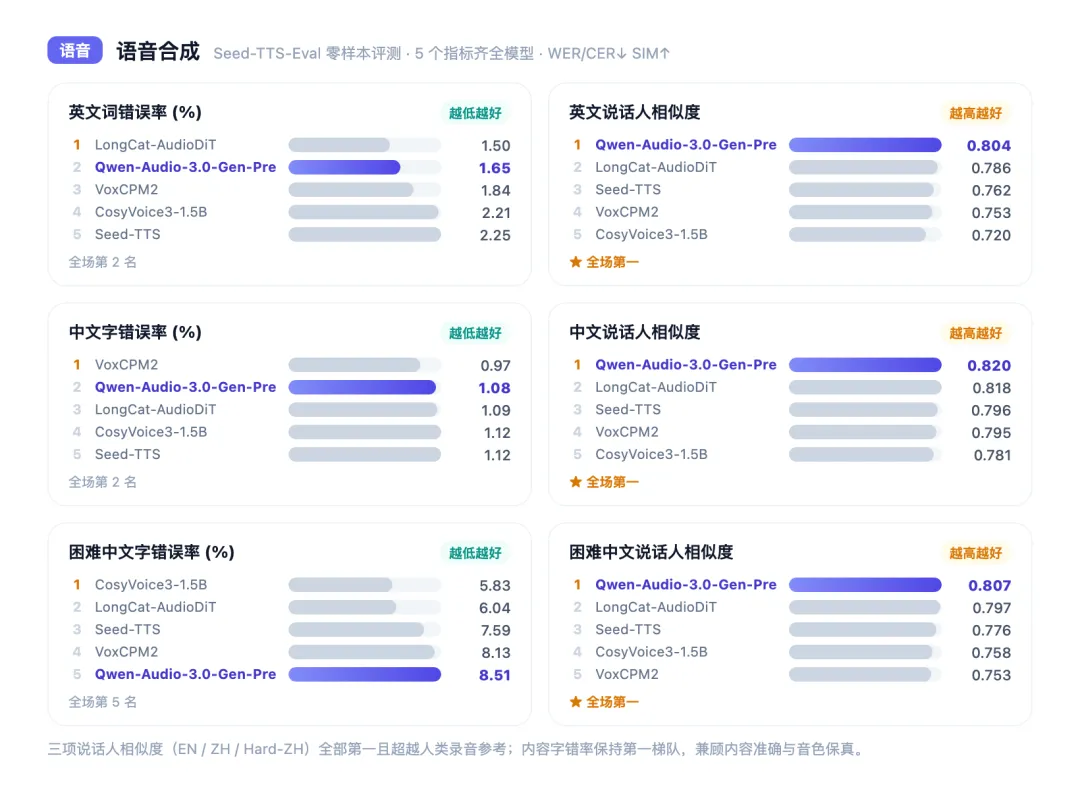
(语音合成 Seed-TTS-Eval 零样本评测结果)
音效评测多项指标第一
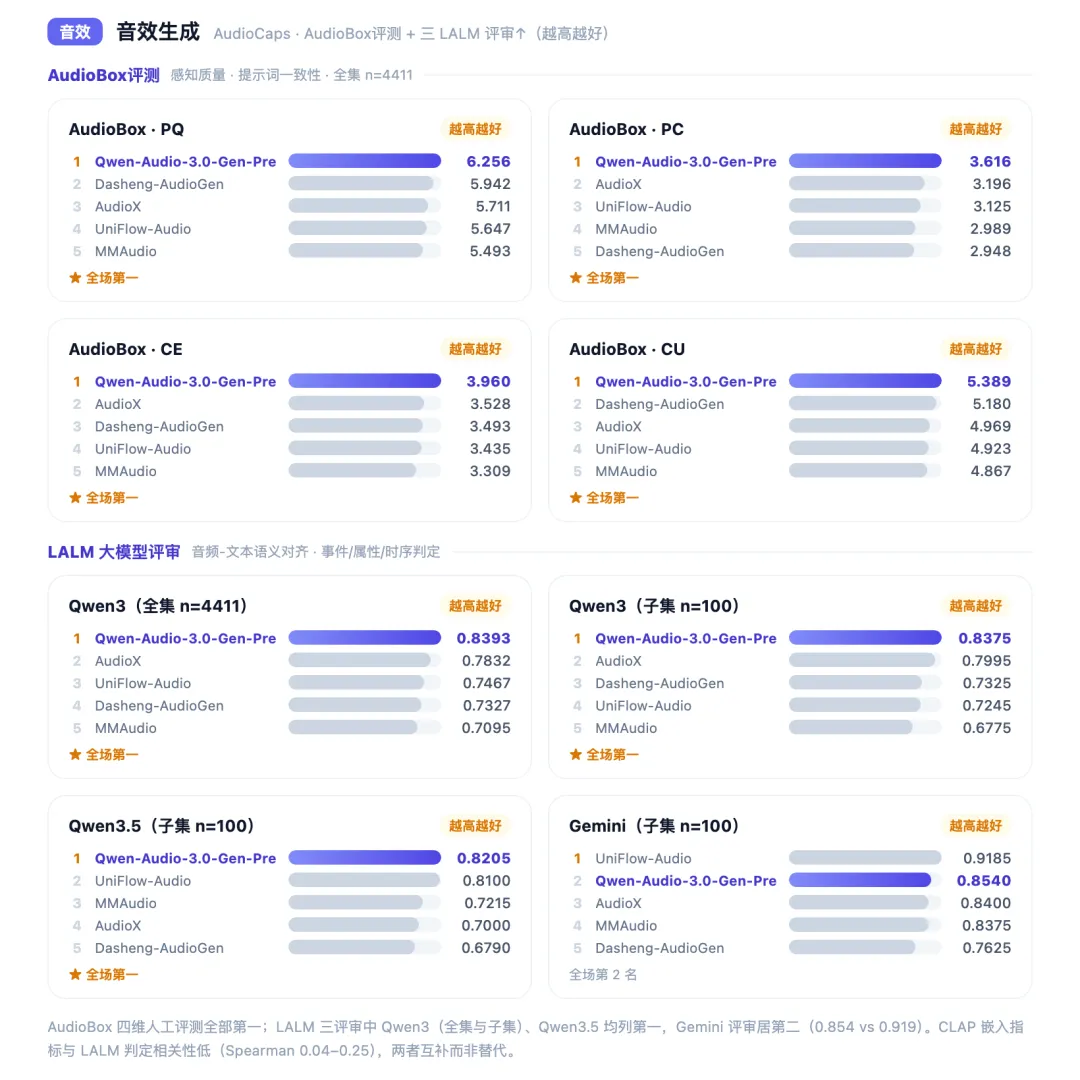
(音效生成 AudioBox 与 LALM 评测结果)
评测数据
在 Seed-TTS-Eval 上,说话人相似度三个子集全部第一(EN 0.80 / ZH 0.82 / Hard-ZH 0.80)。多说话人场景中,跨轮次音色一致性英文 CONS 70.2、中文 CONS 74.0,均为参评系统最高。
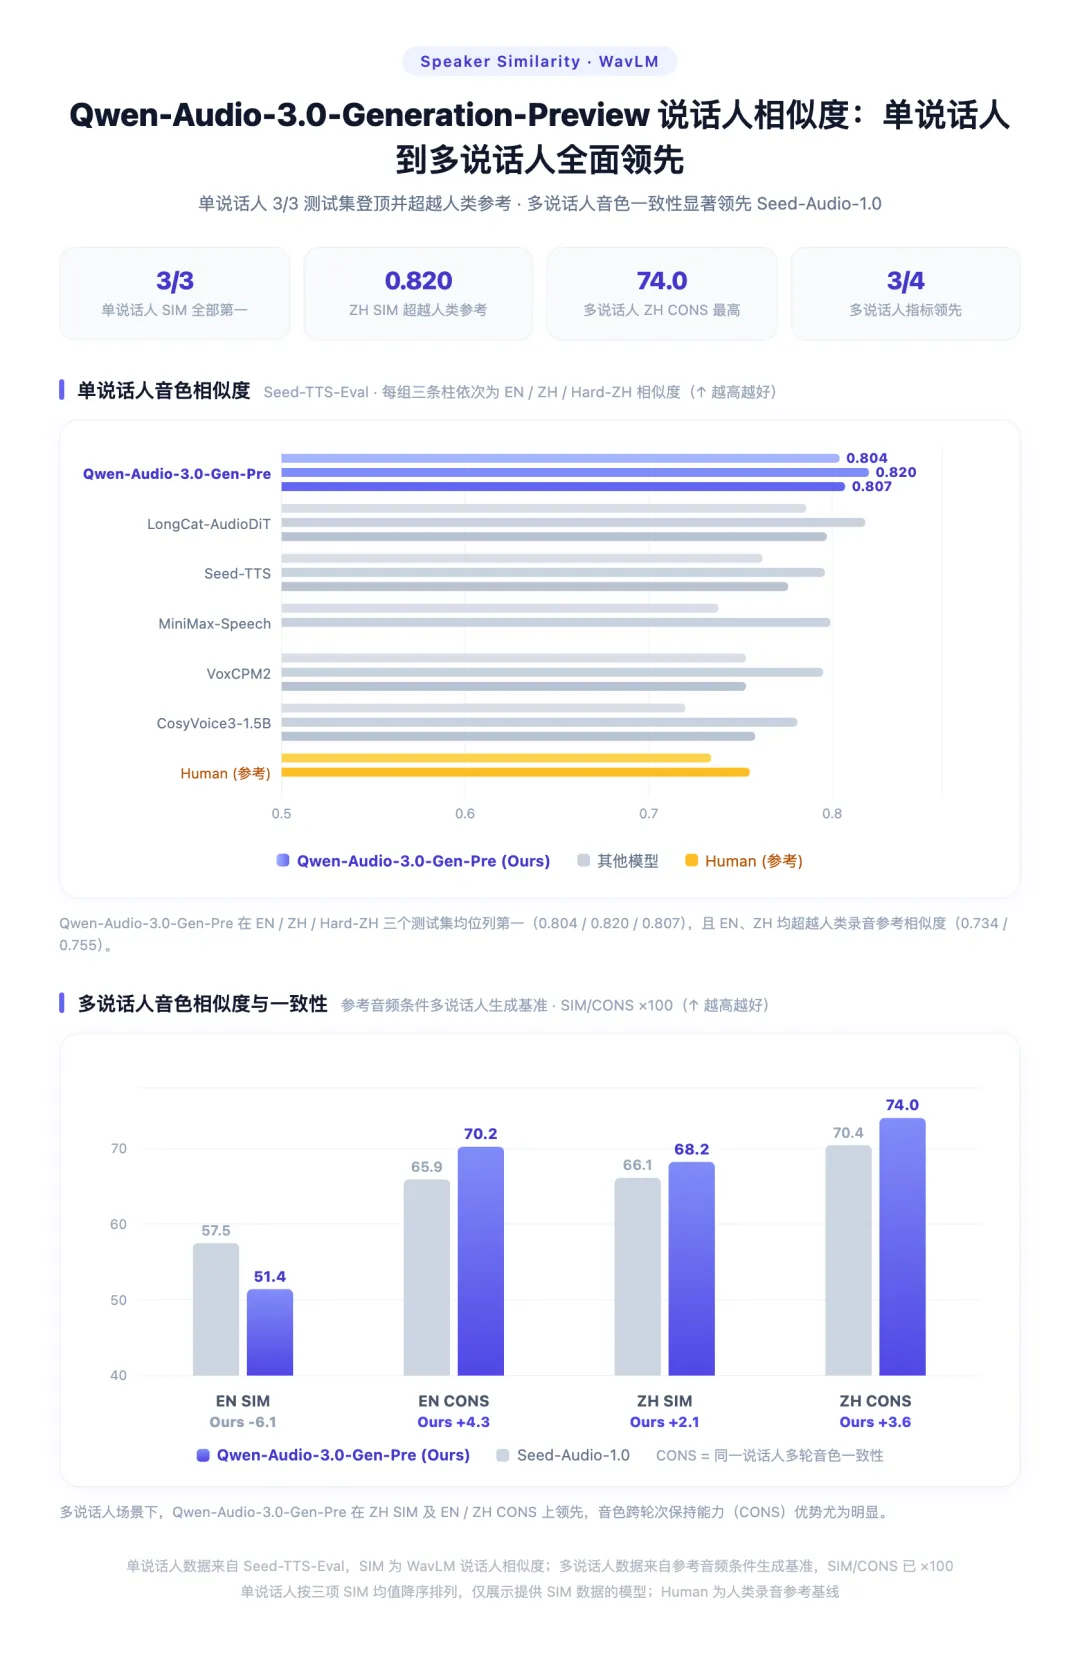
(说话人相似度与多说话人音色一致性评测)
声音什么时候出现、持续多久、谁先谁后、是否同时——这些都可以精确指定。你可以要求"第 3 秒一声敲门,第 5 秒雨声渐起,对白在雨声稳定后开始",模型会严格按时间线执行,而不是把音效随机撒进音轨。
评测数据
内部 100 条复杂场景基准上,双评测模型一致显示:时间重叠度 mIoU 43.73 / 43.12,领先 Seed-Audio-1.0(38.48 / 37.36);IoU@0.5 命中率 50.00% / 43.83%,同样全面领先。声音不只是"出现了",而是"在对的时间出现"。
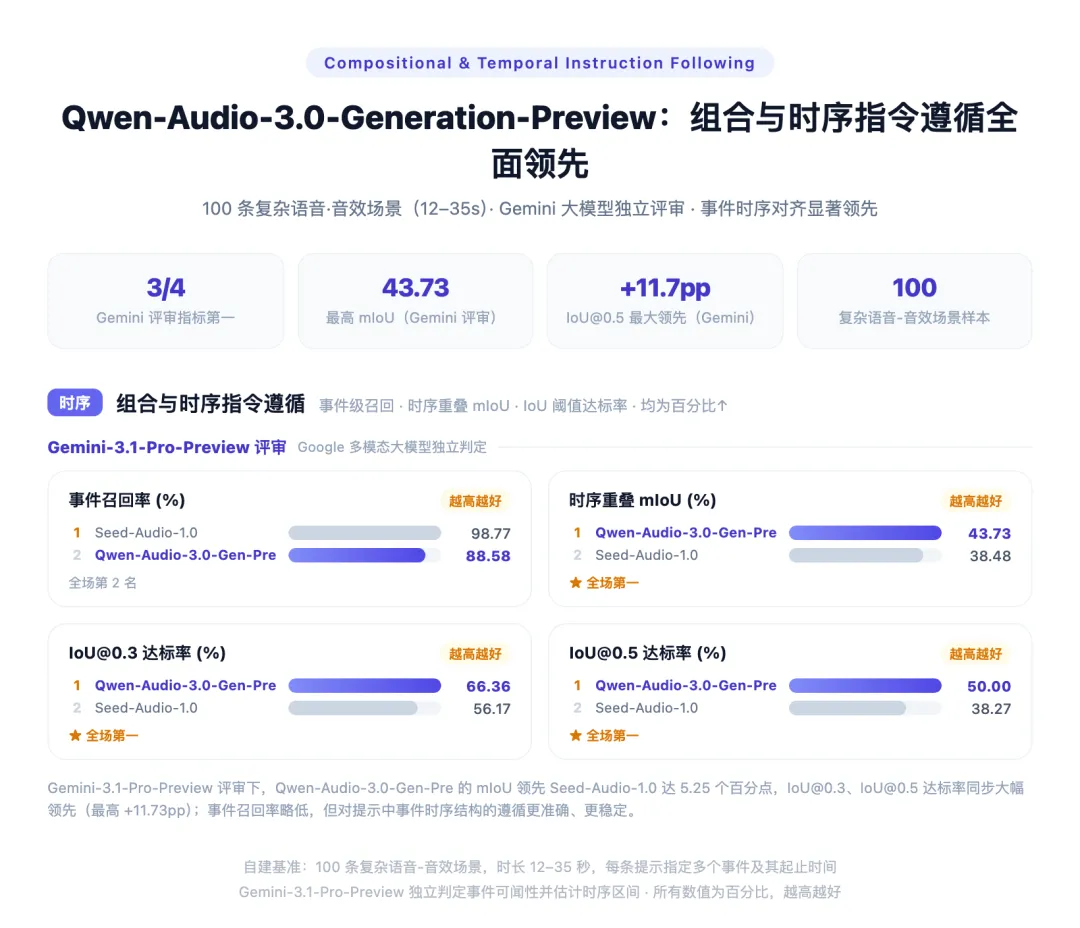
(组合与时序指令遵循评测)
