
 杨超
本文介绍了Wenet模型实现时使用的mask技巧
在Wenet的模型实现时,涉及到一些论文中没有描述细节,比如:
- 一个batch内的输入帧数不等长,进行padding的部分如何处理。
- 一个batch内标注文本不等长,进行padding的部分如何处理。
- decoder的自回归依赖关系如何表达。
- chunk-based的encoder如何实现。
这些细节会对convolution和attention网络以及loss的计算带来影响。 因此在实现时,需要引入各种mask来进行处理。本节通过系统的介绍Wenet代码中涉及的mask,帮助初学者更好的理解wenet的实现。
可以参考wenet/utils/mask.py中的注释也提供了说明和示例。
三类问题
问题1:Batch Padding
一个batch内部各个样本长度不同,但是pytorch这类框架,处理的基本数据格式形式规整tensor,比如一个矩阵,因此输入和标注都需要padding,补上一些数据变成相等长度的序列再进行处理。
Wenet中, 输入的padding叫做frame batch padding,标注的padding叫label batch padding。
处理Padding对Loss的影响
在计算Loss时,需要避免label batch padding带来的影响。
Attention Loss
标注的padding的部分,使用一个特殊整数padding_idx来进行填补。在计算Attention loss时,如果标注值为padding_idx,则不参与loss的计算。
ignore = target == self.padding_idx  # (B,)
    total = len(target) - ignore.sum().item()
    target = target.masked_fill(ignore, 0)  # avoid -1 index
    true_dist.scatter_(1, target.unsqueeze(1), self.confidence)
    kl = self.criterion(torch.log_softmax(x, dim=1), true_dist)
    denom = total if self.normalize_length else batch_size
    return kl.masked_fill(ignore.unsqueeze(1), 0).sum() / denom
CTC loss
torch.nn.CTCLoss接口支持指定Batch内各个输出序列的长度hlens和各个标注序列的长度ys_lens。
self.ctc_loss = torch.nn.CTCLoss(reduction=reduction_type)
loss = self.ctc_loss(ys_hat, ys_pad, hlens, ys_lens)
hlens是encoder输出的Batch中各序列真实长度(除去padding部分的长度)。可以通过encoder_mask得到,encoder_mask会在后面介绍。
# wenet/transformer/asr_model.py
encoder_out_lens = encoder_mask.squeeze(1).sum(1)
ys_lens是batch中各标注序列的真实长度,由dataloader返回的target_lengths得到。
## wenet/utils/executor.py
for batch_idx, batch in enumerate(data_loader):
    key, feats, target, feats_lengths, target_lengths = batch
处理模型输入Padding
模型的输入分为两个部分:
- Encoder的输入:
- 声音特征序列: frame batch padding
- Decoder的输入:
- Encoder的输出: 降采样后的frame batch padding
- 标注文本序列: label batch padding
实现时通过mask技巧对这些padding进行处理。mask是一个0,1值组成的掩码张量,wenet里mask的语义为:mask中值为1的部分是要考虑的,0的部分不考虑。
Wenet的mask大致可分为两类:
- 序列mask,(Batch, Length), 每个 (Length,) 中值为1的位置代表了本序列要考虑的部分。
- Attention mask,(Batch, L1, L2),每个(L1,L2) 用于约束L1中的哪些位置只能对于L2中的哪些位置进行attention操作。
问题2: 自回归
Attention Decoder的结构是自回归的,即每个word只能看到自己以及左侧的words。所以其中的attention操作实现时,每个位置只能和当前位置以及左侧的位置进行操作。为了实现这个操作,需要引入一个mask。
问题3: Chunk-Based Model
因为full attention每一帧都要依赖右侧所有帧,所以无法应用于流式解码中,Wenet采用chunk-based attention,将帧分为等大小的chunk,每个chunk内的帧只在chunk内部进行attention操作。 另外,也允许和左侧的一定长度的帧进行attention。这种固定chunk大小的训练模式,要求解码时必须采用同样大小的帧。Wenet引入了一种dynamic chunk training算法,在训练时可以动态为每个batch生成不同大小的 chunk,这样,在解码时,chunk大小可以任意指定,大的chunk可以获得高识别率,小的chunk可以获得低延时,从而用户仅需训练单一模型,根据具体场景在解码时选择合适的chunk大小,而无需重新训练模型。
网络各部分的实现
Encoder中的mask
wenet/transformer/encoder.py
def forward()
    ...
    masks = ~make_pad_mask(xs_lens).unsqueeze(1)  # (B, 1, L)
    xs, pos_emb, masks = self.embed(xs, masks)
    mask_pad = masks
    chunk_masks = add_optional_chunk_mask(xs, masks,
                                              self.use_dynamic_chunk,
                                              self.use_dynamic_left_chunk,
                                              decoding_chunk_size,
                                              self.static_chunk_size,
                                              num_decoding_left_chunks)
    for layer in self.encoders:
xs, chunk_masks, _ = layer(xs, chunk_masks, pos_emb, mask_pad)- self.embed会对frame padding mask进行降采样得到subsample frame padding mask。
- mask_pad在Conformer Block中的卷积网络中使用。
- add_optional_chunk_mask会在subsample frame padding mask基础上增加chunk mask,在Conformer Block中的self attention网络使用。
Subsampling中的mask
subsampling网络中的卷积运算时本身不使用frame padding mask,但是会对frame padding mask降采样得到subsample frame padding mask,后续在进行encoder相关计算时会使用这个subsample frame padding mask.
比如在4倍降采样的网络里,使用了两个stride=2的卷积,对shape=(B, 1, L) 的mask进行了mask[:, :, :-2:2][:, :, :-2:2]的操作,新的mask的shape为(B, 1, L/4)。
但是目前的实现存在小问题,最后几个解码帧(降采样帧)如果其卷积野中有padding的帧,则该降采样帧输入无效帧,不该参与后续计算,但是按照目前mask的实现仍会被使用。
举个例子,训练时,某个样本的倒数4个原始帧都是padding的,最后一个解码帧依赖于这些padding帧,因此不应该使用,其mask计算过程如下:
原始mask(单个样本)
1 1 1 1 1 1 1 0 0 0 0经过subsample后的mask
1   1   1   1   0
1       1
注意,此时根据计算出对subsample padding mask,仍然会使用最后一个解码帧。
类似的,如果倒数5个原始帧都是padding的,那么此时倒数两个解码帧信息都不全,都不应该使用,但是subsample padding mask仍然会使用两个解码帧。可以自行验证下。
不过这个‘不完美’的实现问题对训练影响不大,只会影响最后1到2帧,相当于给模型增加了一些干扰。
Conformer Block中的Conv的mask
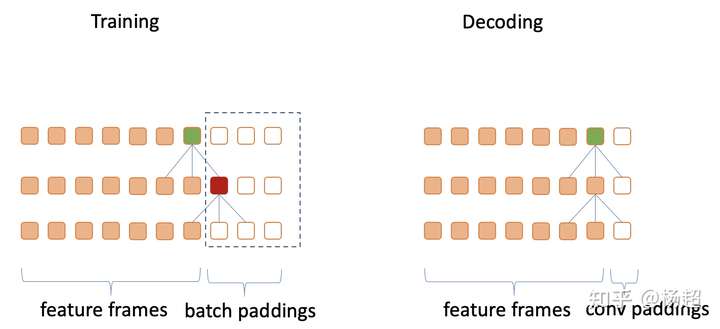
考虑图中多层卷积的情况,假设kernel大小为3。 由于batch paddings的存在,在训练时,绿色单元依赖于红色单元,而红色单元不是0值。 然而在解码时,因为没有batch padding存在,绿色单元依赖的红色单元位置的值是由conv paddings产生的,这个值是0值,所以如果不进行任何处理,存在训练和解码不一致的问题。
因此,代码里利用subsample frame padding,将每一层的batch padding部分的值变为0.
# wenet/transformer/convolution.py
# def forward():
    x.masked_fill_(~mask_pad, 0.0)
不过如果使用casual conv中,由于其结构的特点,每个点不依赖于自己右侧的点,则不需要这个mask。
MultiHeadedAttention Module的Mask实现
MultiHeadedAttention可以用于三种不同的attention。
- Encoder中的self-attention
- Decoder中的self-attention
- Decoder中的cross-attention
不同的情况下,attention的mask会有所区别。
- 用于self-attention时,每个样本的mask是一个长和高一样大小的方阵。
- 用于cross-attention时,mask的纵轴从上到下为文本序列,横轴从左到右为帧序列。
MultiHeadedAttention的forward函数注释里说明了在不同情况下传入的mask的shape不同。
# wenet/transformer/attention.py
def forward(self, query: torch.Tensor, key: torch.Tensor,
            value: torch.Tensor,
            mask: Optional[torch.Tensor]) -> torch.Tensor:
    """Compute scaled dot product attention.

    Args:
        query (torch.Tensor): Query tensor (#batch, time1, size).
        key (torch.Tensor): Key tensor (#batch, time2, size).
        value (torch.Tensor): Value tensor (#batch, time2, size).
        mask (torch.Tensor): Mask tensor (#batch, 1, time2) or
            (#batch, time1, time2).
            1.When applying cross attention between decoder and encoder,
            the batch padding mask for input is in (#batch, 1, T) shape.
            2.When applying self attention of encoder,
            the mask is in (#batch, T, T)  shape.
            3.When applying self attention of decoder,
            the mask is in (#batch, L, L)  shape.
            4.If the different position in decoder see different block
            of the encoder, such as Mocha, the passed in mash could be
            in (#batch, L, T) shape. But there is no such case in current
            Wenet.
    """
具体实现
计算attention的权重时使用mask的方式:
先将不需要计算的位置的score设为负无穷而不是0,然后计算softmax得到位置权重,再把不需要参与attention计算的位置的权重系数设为0.
# wenet/transformer/attention.py
def forward_attention ():
    ...
    mask = mask.unsqueeze(1).eq(0)  # (batch, 1, *, time2)
    scores = scores.masked_fill(mask, -float('inf'))
    attn = torch.softmax(scores, dim=-1).masked_fill(mask, 0.0)  # (batch, head, time1, time2)
mask.unsqueeze(1)是为了增加一个head维度。此时:
- 当用于decoder cross-attention时, mask的shape为(batch, 1, 1, Tmax), scores的shape为(batch, head, Lmax, Tmax),第1,第2维会进行broadcast
- 当用于decoder self-attention时, mask的shape为(batch, 1, Lmax, Lmax), scores的shape为(batch, head, Lmax, Lmax),第1维会进行broadcast
- 当用于encoder self-attention时, mask的shape为(batch, 1, Tmax, Tmax), scores的shape为(batch, head, Tmax, Tmax),第1维会进行broadcast
Chunk-based mask
为了实现流式解码,encoder中使用了基于chunk的attention,并允许各个batch使用不同的chunk大小。
基于chunk的attention,本质上是去限制attention的作用范围,可以通过attention mask来实现。
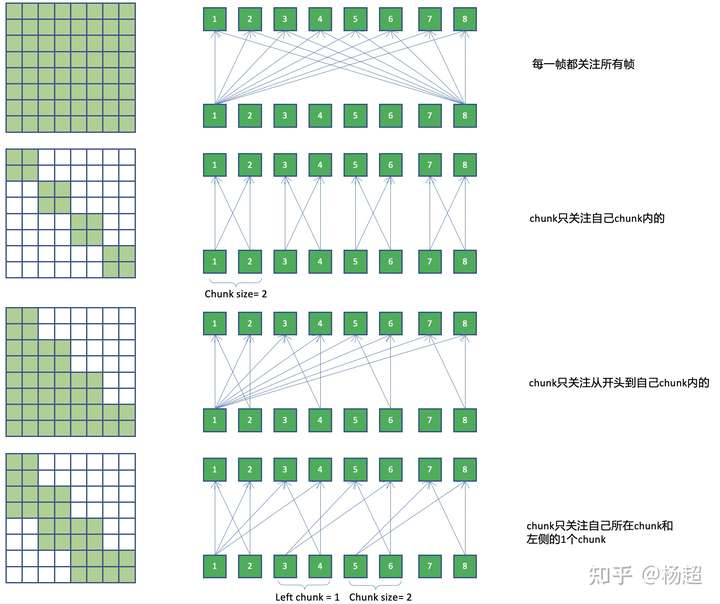
- subsequent_chunk_mask方法用于创建一个固定大小chunk的mask。
- add_optional_chunk_mask方法则用于创建动态大小的chunk的mask。
def add_optional_chunk_mask(xs: torch.Tensor, masks: torch.Tensor,
                            use_dynamic_chunk: bool,
                            use_dynamic_left_chunk: bool,
                            decoding_chunk_size: int, static_chunk_size: int,
num_decoding_left_chunks: int):- use_dynamic_chunk=Ture, 各的batch使用随机的chunk mask。
- 如果 use_dynamic_left_chunk=True, 各的batch使用随机的的left chunk长度依赖
- 如果 use_dynamic_left_chunk=False, 各的batch使用均依赖开头到当前chunk
- use_dynamic_chunk = false, static_chunk_size <= 0. 使用full-attention.
- use_dynamic_chunk = false, static_chunk_size > 0. 使用固定的chunk mask.
Decoder中的mask
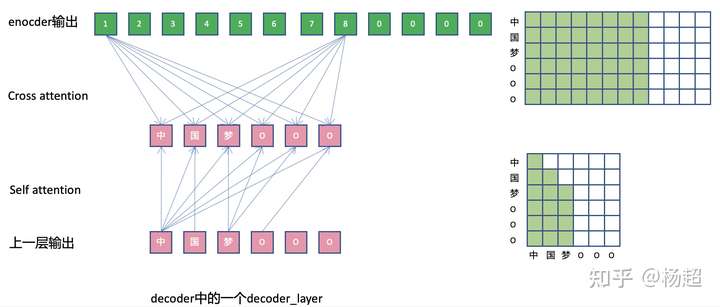
Decoder涉及到两种Attention。 self.self_attn是decoder上的self attention。 self.src_attn是decoder和encoder的cross attention。
# wenet/transformer/decoder_layer.py
def forward():
    ...
    self.self_attn(tgt_q, tgt, tgt, tgt_q_mask)
    self.src_attn(x, memory, memory, memory_mask)
    ...
Self Attention
self attention中要考虑自回归和label batch padding带来的影响。
wenet/transformer/decoder.py
        tgt = ys_in_pad
        # tgt_mask: (B, 1, L)
        tgt_mask = (~make_pad_mask(ys_in_lens).unsqueeze(1)).to(tgt.device)
        # m: (1, L, L)
        m = subsequent_mask(tgt_mask.size(-1),
                            device=tgt_mask.device).unsqueeze(0)
        # tgt_mask: (B, L, L)
tgt_mask = tgt_mask & m- ~make_pad_mask产生的tgt_mask是label padding mask,每个words不允许对padding部分进行attention操作。
- subsequent_mask产生的m是decoder的自回归mask,每个words只对自己以及左侧的words进行attention操作。
如图中所示,自回归mask和label padding mask被同时使用。
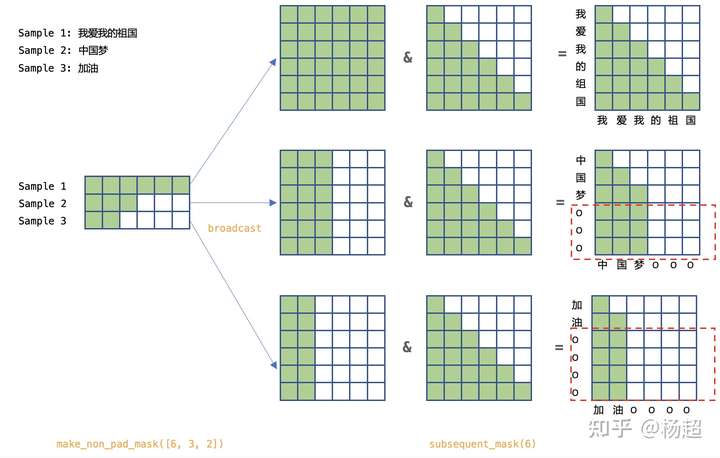
不过,由于decoder本身是自回归的,自回归掩码保证了对于非padding的位置,均不会去计算自己右侧的位置,而对于padding位置,在loss中会处理,不参与最后的loss计算。 因此,其实并不需要label padding mask(代码中的tgt_mask).
Cross Attention
进行Cross attention, 由于encoder的一些输出是padding产生的,需要利用subsample frame padding mask.
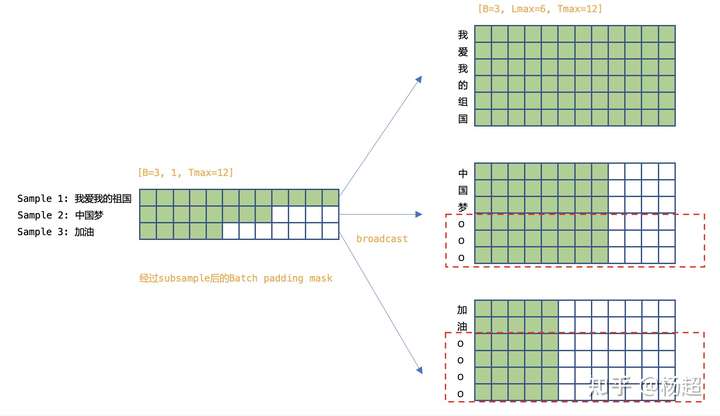
整体结构
Decoder中每一层中,均需要计算如上两个attention,从网络视角来看,如下图所示。
其他
在进行Batch解码时,还用到了mask_finished_scores和mask_finished_preds,本文不进行介绍。
