
 语音小管家
Wespeaker 是wenet社区联合学界(上海交通大学、西北工业大学、深圳市大数据研究院)、业界(腾讯、地平线、思必驰、NVIDIA)面向研究和产品的说话人表征学习框架,wespeaker 具有高质量,轻量级,面向产品,支持工业级数据训练,在线数据增强 等诸多优点。发布以来,wespeaker 受到了来自学界、业界的关注,并得到了社区的积极贡献。遵从利用大规模工业级数据、构建更强的统一基线、支持易用,高效的工业部署的原则,我们对wespeaker 进行了一系列的更新。
相对于我们的ICASSP 论文(https://arxiv.org/pdf/2210.17016.pdf) 描述内容而言,更新内容主要如下:
添加SSL (Self-supervised learning)无标签训练相关代码以及 VoxCeleb 数据集上的recipe (DINO, SimCLR, MOCO), 其中 DINO recipe 可达到类似框架的SOTA 结果。为后续利用大规模无标签数据提供技术支持。
添加了针对 VoxSRC 2023 比赛的recipe,具体表现可参考https://arxiv.org/pdf/2306.15161.pdf 添加对学界常用 SRE 数据集的支持 Kaldi 外第一个支持SRE数据的开源框架 SRE16 集合达到SOTA 结果 更新 PLDA 代码,大体与kaldi 保持一致,并添加PLDA unsupervised adaptation 相关代码,在 SRE16 数据集取得 SOTA 结果 打造更强基线系统,新增支持: Backbone 新加入对 CAM++ 的支持 训练准则加入对 Sphereface2 的支持,此外还添加了打比赛常用的 intertopk、 subcenter loss Pooling function 新加入对 MQMHASTP(Multi-query Multi-head Attentive Statistics Pooling)的支持
添加 AMP(Automatic Mixed Precision) 训练支持 添加了更多的预训练模型供用户选择 添加了C++ 的onnxruntime 支持 添加了对diarization pipeline 的Triton GPU 部署
利用大规模无标签数据:支持SSL 训练
新增SSL 代码可在 VoxCeleb Recipe V3 进行尝试。
从相同音频截取的片段都来自同一个说话人。 从不同音频截取的片段大概率来自不同的说话人。
SimCLR
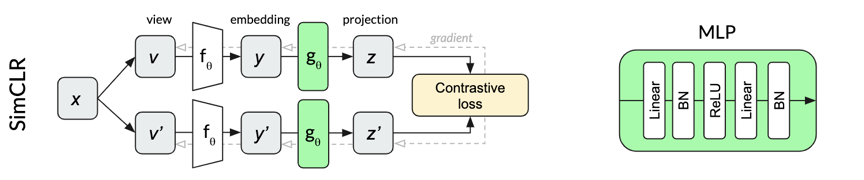
参考论文:
A Simple Framework for Contrastive Learning of Visual Representations
Contrastive Self-Supervised Learning for Text-Independent Speaker Verification
MOCO
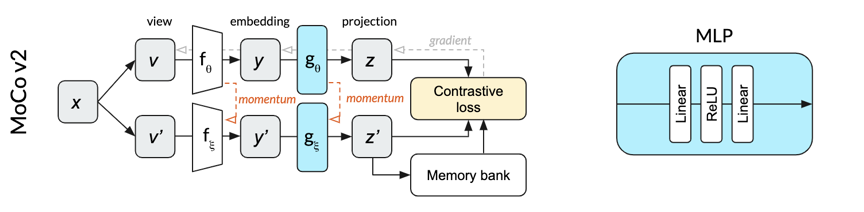
自监督学习中负样本的数量往往关系到最终性能。SimCLR依靠大batchsize来增大负样本数量,但会受到算力的约束。相比于SimCLR,MoCo提出了:
用memory bank来提升负样本数量。负样本从memory bank中采集,而不仅仅依赖于当前 batch 中的样本。这有效地增加了负样本数量,从而提高了模型的性能。同时,这种方法降低了对 batch size 的依赖,使得在有限算力下也能获得较好的性能。
引入了额外的momentum encoder来解决一致性问题。
MoCo 的整体流程与 SimCLR 类似,但通过引入 memory bank 和 momentum encoder,它能够在有限算力条件下获得更好的性能。这些策略同样可以应用于语音处理任务,以提高自监督学习的效果。
Momentum Contrast for Unsupervised Visual Representation Learning
Self-Supervised Text-Independent Speaker Verification Using Prototypical Momentum Contrastive Learning
DINO
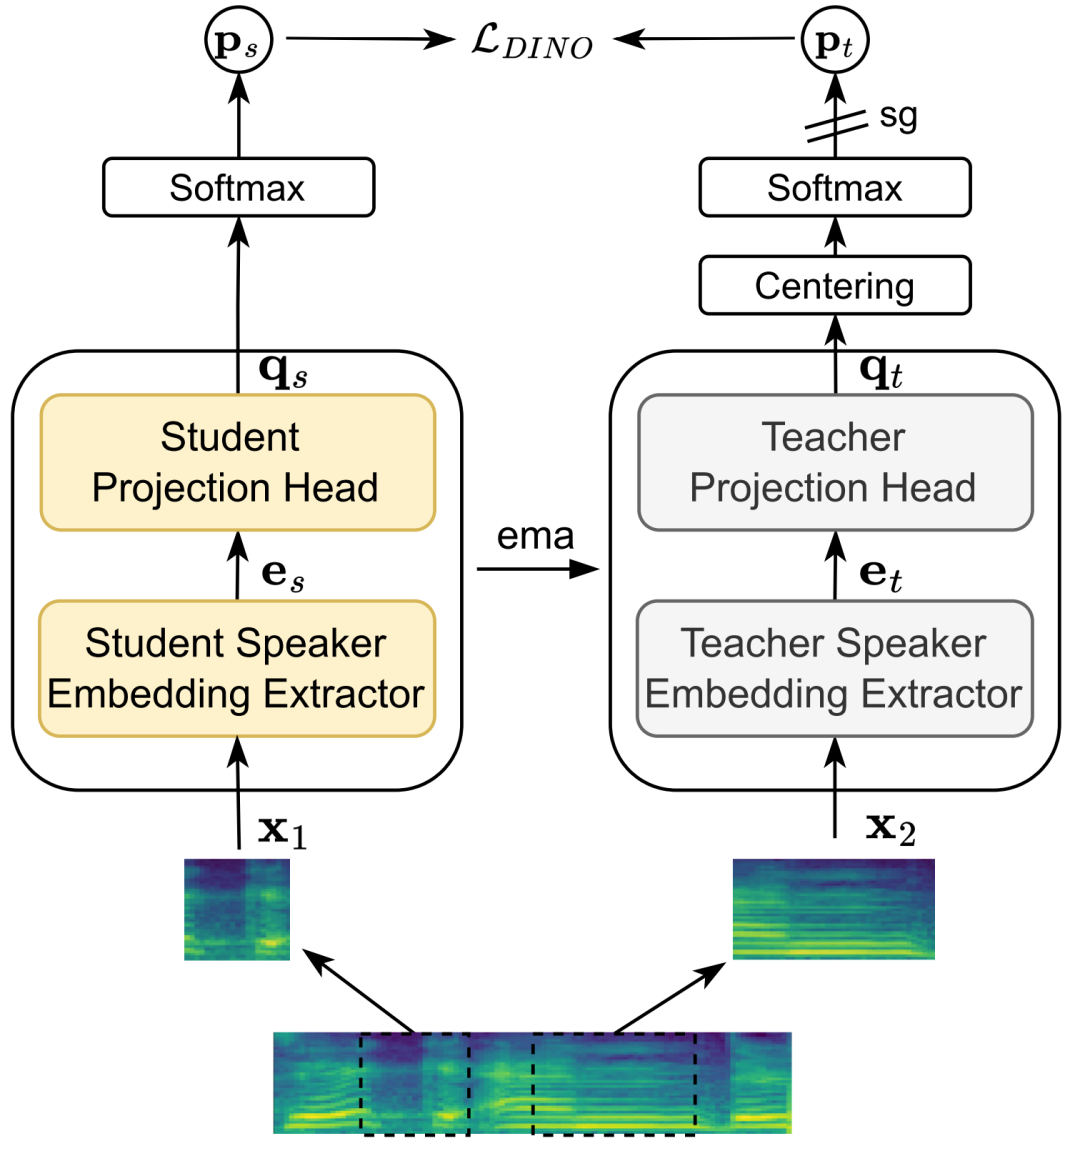
相较于SimCLR 和 MOCO 不同的构建负样本的策略,DINO(DIstillation of knowledge with NO labels)不再依赖于负样本进行优化,这样能够避免负样本构建过程中可能引入的错误(同一个batch内部可能会采样到同一个说话人,但是根据假设却将其视为不同说话人)。DINO框架不需要负样本,只是通过最大化正样本对之间的相似度来完成模型的优化。区别在于:
采用动量更新的teacher-student架构,teacher 模型由 student模型的参数动量更新。
正样本对片段不等长。长片段输入teacher模型,结果sharpen之后作为模型优化的target;短片段则输入student模型,使用交叉熵损失进行梯度反传。DINO 的核心思想是通过最大化正样本对之间的相似度来完成模型的优化,在性能上也明显好于另外两种框架。
参考论文:
Emerging Properties in Self-Supervised Vision Transformers
A Comprehensive Study on Self-Supervised Distillation for Speaker Representation Learning
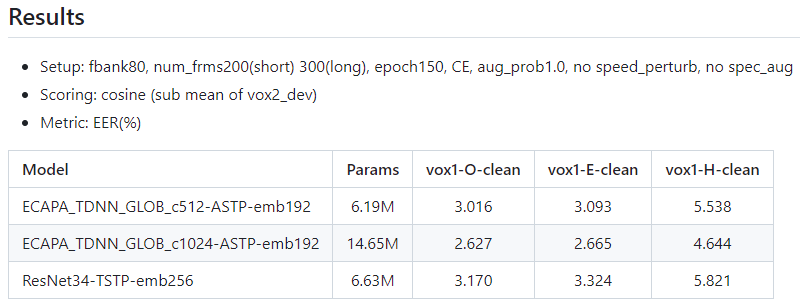
Wespeaker 中DINO 框架在VoxCeleb 数据集上的结果如下:
SRE Recipe
NIST SRE竞赛始于1996年,是一个长期举办的说话人识别评估活动。自那时以来,NIST每隔1-2年就会组织一次SRE竞赛,以推动该领域的研究和发展。每届竞赛都会引入新的数据集,以适应技术的进步和应用需求的变化。历年来,NIST SRE竞赛积累了大量的电话信道数据集合。
相对于VoxCeleb数据集,NIST SRE数据集侧重于8k电话信道数据,覆盖了不同的噪声场景和语种。训练和测试数据之间存在较大的差异,使得该任务更加具有挑战性。
相对于VoxCeleb Recipe, 我们主要做了如下改动:
静音检测:由于 SRE 数据中存在大量的静音段,我们在数据预处理阶段加入了静音检测功能,以便更有效地处理语音数据。
Pipe 读取支持:SRE 数据是 .sph 格式,而大部分语音读取工具都不支持这种格式。为了让 Wespeaker 更好地读取 .sph 格式的数据,我们在数据预处理阶段支持了从管道中读取语音数据的功能。基于这个功能,我们可以先用特定的工具将 .sph 文件转成 .wav 格式输出到管道中,然后用代码直接从管道读取,避免了额外的存储步骤。
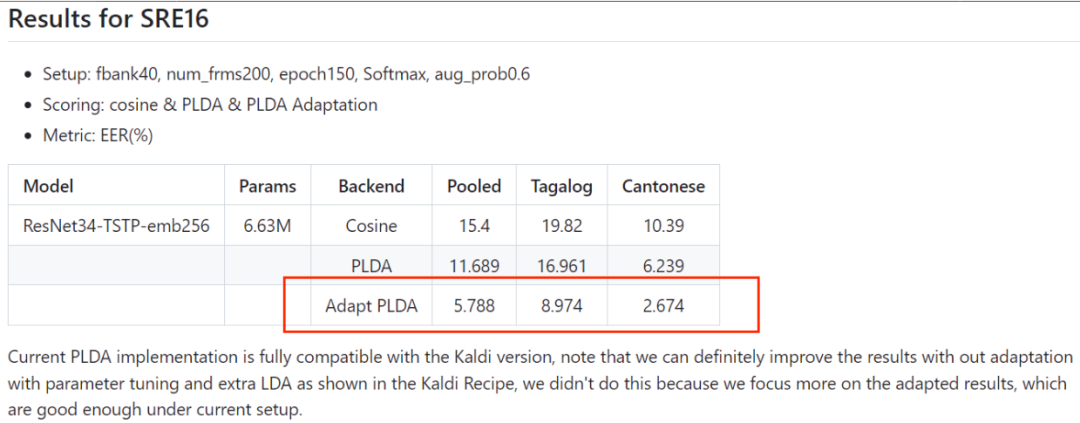
PLDA 快速领域自适应:在 SRE 的 Recipe 中,测试数据 SRE16 与训练数据存在较大的域失配。为了提升测试集的性能,我们支持了 PLDA 快速领域自适应功能。基于这个功能,我们可以使用目标域无标签数据实现快速的领域自适应,从而提高模型在测试集上的表现。
通过这些改进,我们使得 Wespeaker 在处理 SRE 数据时更加高效和准确。Wespeaker 提供的SRE16 Recipe 结果如下:
自发布以来,wespeaker 及其预训练模型已被应用于多个需要音色建模的任务,以及语音数据预处理流程,以下以WenetSpeech 打说话人标签举例说明:
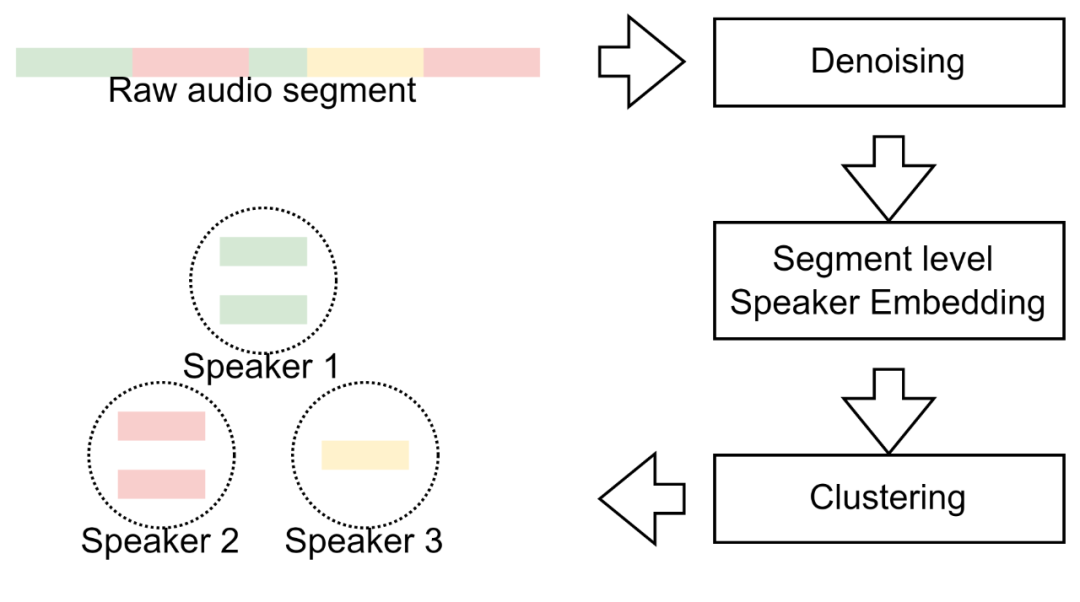
近年来,开源大规模数据集如 WenetSpeech 和 Gigaspeech 极大地推动了语音识别任务的研究。同时,越来越多的研究者尝试利用这些大规模数据进行其他任务,如语音合成。然而,由于原始数据无法保证一句话中只有一个说话人,并且没有将同一个录音切分出来的语音段按说话人进行分类,因此需要额外的说话人聚类操作。
我们使用 wespeaker 预训练的说话人表征模型,通过聚类算法对开源的 WenetSpeech 数据集构建了局部(同一recording 内)的伪说话人标签。这样可以过滤掉原始数据中包含两个或以上说话人的语音短句。经过筛选和打标签后的数据便可用于语音合成等任务。
相关的metadata 可以参考:
最后,欢迎大家使用wespeaker,服务于各类需要音色建模的任务,也欢迎社区的贡献和宝贵建议!
